


使用 BigQuery Agent Analytics
BigQuery Agent Analytics 是一种开源解决方案,可让您将原始智能体互动(例如请求、回答、工具调用和错误)直接流式传输到 BigQuery,从而大规模捕获、分析和直观呈现多模态智能体互动数据。借助此解决方案,您可以执行 AI 赋能的评估、优化代理提示,并提取长期记忆以增强未来的互动。 智能体开发套件 (ADK) 和 LangGraph(预览版)支持 BigQuery Agent Analytics。
架构
BigQuery Agent Analytics 使用 BigQuery Storage Write API (gRPC) 将智能体活动数据流式传输到 BigQuery,该 API 可提供高吞吐量、低延迟的日志流式传输,而不会阻塞智能体执行。
数据流包含以下阶段:
- 拍摄。使用智能体开发套件 (ADK) 中的插件或 LangGraph 中的回调拦截互动事件,以捕获智能体事件。
- 数据流。互动事件通过 Storage Write API (gRPC) 发送到 BigQuery。如果不存在标准化架构,代理会自动创建一个。
- 使用。分析和评估记录的代理数据。您可以使用 SQL 查询原始数据,在自定义信息中心内跟踪指标,或使用 BigQuery Agent Analytics SDK 重构和评估复杂的多轮智能体执行轨迹。
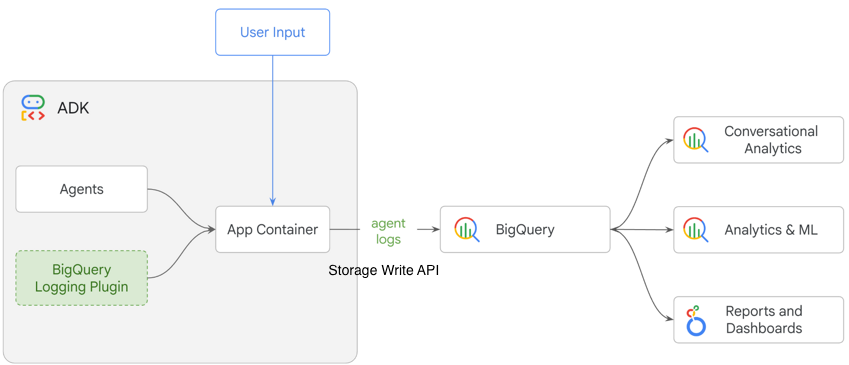
智能体分析的优势
- 只需一行代码即可启用全面的日志记录,并自动管理架构。
- 使用对象表记录和分析多模态数据,例如文本、图片、视频和音频。
- 在预定义的强大架构中跟踪运营指标,例如 token 消耗量和延迟时间。
- 使用 BigQuery 生成式 AI 函数和 Vector Search 来确定优化机会。
- 通过精细的访问权限控制、数据遮盖和加密来保护智能体日志。
捕获智能体日志数据的方法
如需将智能体的互动遥测数据(请求、回答、工具调用和错误日志)原生捕获到 BigQuery 中,您可以通过以下几种方式记录事件数据:
- 编排框架插件:使用智能体编排工具包提供的标准日志记录插件。例如,智能体开发套件 (ADK) 中的
BigQueryAgentAnalyticsPlugin会挂接到智能体运行器,以自动拦截、序列化和流式传输事件。 - 框架回调处理程序:在热门智能体环境中集成标准回调。例如,您可以使用 LangGraph 和 LangChain 中的内置 BigQuery 处理程序来拦截和转发跟踪记录。
- 直接 API 提取:对于自定义或专有框架,请使用Google Cloud 客户端库,通过 Storage Write API (gRPC) 将结构化事件直接流式传输到事件表。
- 对话分析数据智能体:在 BigQuery Studio 中或通过 Conversational Analytics API 为 BigQuery 数据智能体配置设置时,启用内置对话日志记录功能,以自动将对话事件流式传输到目标 BigQuery 表并分析对话日志。
无论采用哪种方法,所有日志记录选项都使用低延迟、高吞吐量的 BigQuery Storage Write API (gRPC)。此 API 提供了一个强大的流式传输端点,可在提交行之前在内存中异步缓冲和序列化行(使用 PyArrow 引擎),从而确保可观测性流水线任务不会阻塞面向用户的智能体执行轮次。
分析智能体日志数据的方法
如需了解和优化智能体的性能,请通过以下方式分析和评估互动日志:
- 直接 SQL 查询:在 BigQuery 中运行自定义查询,以计算 token 消耗和执行延迟时间等指标。您还可以使用
AI.GENERATE自动分析错误的根本原因,或与业务表执行联接以衡量业务影响。 - 交互式信息中心:将数据洞察等可视化工具连接到预构建或自定义的 BigQuery 视图,以跟踪代理运行状况、错误率和一段时间内的使用趋势。Looker 客户还可以使用 Looker Marketplace 中预构建的 BigQuery Agent Analytics 信息中心模板(Looker 组成块)。
- Jupyter 笔记本:在交互式环境中使用 Python 库、pandas 或 BigFrames 探索和试验日志数据。
- Python SDK:直接在应用代码或自动化评估流水线中以编程方式查询、重构和审核智能体执行轨迹。
使用智能体日志数据的示例
以下是在 BigQuery 中使用智能体日志数据的常见用例和示例。
可观测性和运营指标
- 查询数据,按智能体流程细分费用,并确定特定智能体(例如优化智能体)消耗的 token 数量是否与其对最终回答的贡献不成比例。
- 通过使用
AI.GENERATE函数运行查询,使用 BigQuery 对话式分析代理进行 AI 赋能的根本原因分析。例如,“分析此对话日志并解释失败的根本原因”。
智能体评估和质量分析
- 使用
AI.SCORE函数对对话进行排名,并衡量客服人员排名随时间的变化。 - 使用包含 Vector Search 的 SQL 查询,找出智能体未能协助用户的对话聚类,然后将其与用户的原始意图进行比较。这有助于您找出代理工具或知识库中的不足之处。
业务数据洞见和情境化
如需将代理数据置于上下文中,请将 agent_events 表与其他业务表联接。例如,显示与 AI 智能体互动的客户与使用搜索栏的客户的平均订单价值 (AOV)。
如需查看更多示例,请参阅高级分析查询。
使用 Jupyter 笔记本处理智能体日志
使用此示例 Colab Jupyter 笔记本以交互方式查询、直观呈现和评估智能体日志。
使用 BigQuery Agent Analytics SDK
BigQuery Agent Analytics SDK 是一个开源 Python 库,可为长期智能体可观测性提供使用和评估层。信息中心和笔记本非常适合进行临时探索,而 SDK 则提供了一种系统化、大规模分析和审核智能体行为的方法。
您可以使用该 SDK 执行的操作
您可以使用 BigQuery Agent Analytics SDK 执行以下任务。如需查看日志分析的详细示例,请参阅 SDK 的 GitHub 代码库。
- 跟踪重建:将多态事件日志重建成因果事件链,以调试跨多个轮次的会话,包括嵌套工具和 LLM 调用。
- 确定性和语义评估:根据基于规则的标准(例如延迟时间、轮次计数和错误率)以及语义标准(例如正确性、情感和幻觉)评估智能体质量。
- 轨迹匹配:将实际智能体执行路径与预期黄金轨迹进行比较,以验证步骤效率以及工具是否按正确顺序使用。
- 行为监控和偏移检测:对非确定性智能体输出执行统计分析,监控用户请求分布,并检测生产回归或语义偏移。
- 长跨度智能体记忆:为智能体提供跨会话上下文、用户画像语义检索以及原生存储在 BigQuery 中的令牌预算感知情景记忆。
记录和分析智能体活动
将 SDK 集成到智能体工作流中通常涉及以下步骤:
- 记录互动:在智能体编排框架中附加一个日志记录器插件(例如 ADK 中的
BigQueryAgentAnalyticsPlugin)或回调处理程序。当用户与您的代理互动时,系统会使用高吞吐量 Storage Write API (gRPC) 将日志异步流式传输到 BigQuery。 初始化客户端:通过 Python SDK 连接到日志数据集:
from google.cloud import bigquery
from bigquery_agent_analytics import Client

client = Client(
    project_id="YOUR_PROJECT_ID",
    dataset_id="YOUR_DATASET_ID",
    table_id="agent_events",
)
该代码段使用以下组件:
client:以编程方式路由查询并管理活跃数据库连接的父级Client实例。project_id:包含目标数据集的 Google Cloud 项目 ID。dataset_id:存储日志的 BigQuery 数据集名称。table_id:存储遥测事件的特定表(默认为agent_events)。
重构会话轨迹:提取特定对话会话,以直观呈现和查看确切的事件序列:
trace = client.get_session_trace(
    session_id="YOUR_SESSION_ID"
)
trace.render()
该代码段使用以下组件:
trace:填充后的Trace对象,其中包含所有用户和智能体操作的重构因果关联分层 DAG span 树。YOUR_SESSION_ID:您要检查的会话的唯一 ID。
运行自动化评估:以编程方式对会话轨迹进行评分,或对照黄金测试套件检查是否存在回归:
from bigquery_agent_analytics import (
    LLMAsJudge,
    TraceFilter,
)

# Run semantic evaluations across target sessions
evaluator = LLMAsJudge.correctness()
filters = TraceFilter(session_ids=["session_1", "session_2"])

report = client.evaluate(evaluator, filters=filters)
print(f"Evaluation Pass Rate: {report.pass_rate:.2%}")
该代码段使用以下组件:
evaluator:用于为会话评分的语义 (LLMAsJudge) 评估器(您也可以运行基于规则的SystemEvaluator检查,或将评估器组合成加权GraderPipeline)。filters:TraceFilter实例,用于指定要在 BigQuery 中运行批量评估的session_ids列表(或时间窗口和代理过滤条件)。report:生成的EvaluationReport对象,其中包含原始会话评分、指标摘要和自动评分器反馈。
将 BigQuery Agent Analytics 集成到工作流中
如需将 BigQuery Agent Analytics 集成到您的工作流中,请参阅您所用框架的文档:
- ADK BigQuery Analytics 插件指南
- BigQuery 回调处理程序集成(LangChain 和 LangGraph)