


AI 可用區是專門用於人工智慧和機器學習 (AI 和機器學習) 訓練和推論工作負載的可用區。提供大量機器學習加速器 (GPU 和 TPU) 運算資源。
在區域內,AI 可用區與標準 (非 AI) 可用區在地理位置上彼此獨立。下圖範例顯示 AI 可用區 (us-south1-ai1b) 與 us-south1 區域中標準可用區的相對位置較遠。
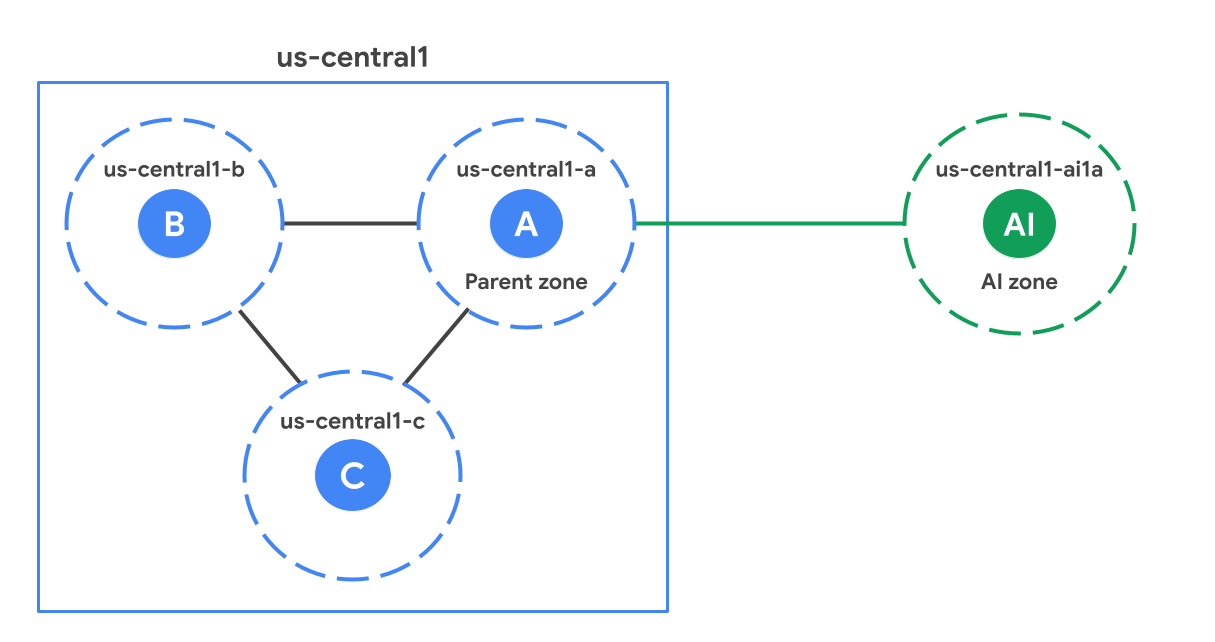
父項可用區
每個 AI 可用區都會與該區域中的標準可用區建立關聯,稱為「父項可用區」。父項可用區是與 AI 可用區後置字串相同的標準可用區。舉例來說,在圖表中,us-central1-a 是 us-central1-ai1a 的父項區域。他們會共用軟體更新時程,有時也會共用基礎架構。也就是說,任何影響上層可用區的軟體或基礎架構問題,也可能影響 AI 可用區。設計高可用性解決方案時,請詳閱高可用性 (HA) 考量事項,瞭解對上層可用區的依賴性。
AI 專區的使用時機
AI 可用區經過最佳化調整,可處理 AI 和機器學習工作負載。請參考下列指引,判斷哪些工作負載最適合 AI 可用區,哪些工作負載更適合標準可用區。
建議對象:
大規模訓練:由於有大量加速器可用,因此非常適合大型語言模型 (LLM) 和基礎模型訓練等大規模訓練工作負載。
小規模訓練、微調、大量推論和重新訓練:AI 可用區適合需要大量加速器容量的工作負載。
即時機器學習推論:AI 專區支援即時推論工作負載。效能取決於應用程式設計和模型延遲時間需求,尤其是工作負載需要向父項區域發出來回要求時。
不建議用於:
- 非機器學習工作負載:AI 可用區並未在本機提供所有 Google Cloud 服務,因此建議您在標準可用區執行非機器學習工作負載。
從 AI 可用區存取服務
您可以從 Google Cloud 區域的 AI 專區,存取該區域的所有 Google Cloud 產品。不過,從 AI 可用區存取 Google Cloud 區域中的服務,可能會增加網路延遲時間,因為 AI 可用區與該區域標準可用區的位置在實體上是分開的。
如要在 Google Cloud 控制台、Google Cloud CLI 和 REST API 中查看 AI 區域,您必須為專案啟用 AI 區域瀏覽權限。AI 區域可見度與存取控管和組織政策服務邊界各自獨立。詳情請參閱「管理 AI 可用區顯示設定」。
特定產品支援在 AI 區域中,於本機建立或存取可用區資源。如要進一步瞭解這些服務,請參閱下表:
| 產品 | 說明 |
|---|---|
| Google Kubernetes Engine (GKE) | 設定在 GKE 叢集中使用 AI 專區,包括使用 ComputeClass、自動佈建節點和 GKE Standard 節點集區。 在 GKE 中使用 AI 專區 |
| Cloud Storage | 設定 AI 區域中工作負載的物件儲存庫,包括在執行中的工作期間,使用可用區儲存空間盡可能提高效能,以及使用永久儲存空間儲存資料集和模型檢查點。 搭配使用 AI 專區和 Cloud Storage |
| Compute Engine | 使用控制台、Google Cloud CLI 和 REST API 找出可用 AI 區域的方法,包括如何依命名慣例、加速器類型或機器篩選 找出可用的 AI 區域 |
| Google Cloud Managed Lustre | 針對部署在 GKE Standard 的 AI 和機器學習工作負載,最佳化效能 使用 Google Cloud Managed Lustre 最佳化 AI 和機器學習工作負載 |
位置
AI 專區適用於下列國家/地區:
| AI 專區 | AI 可用區位置 | Google Cloud 區域 | Google Cloud 區域位置 | 上層區域 |
|---|---|---|---|---|
europe-west4-ai1a |
荷蘭德庫伊 (歐洲) | europe-west4 |
荷蘭埃姆斯港 (歐洲) | europe-west4-a |
us-south1-ai1b |
德州奧斯汀 (北美洲) | us-south1 |
德州達拉斯 (北美洲) | us-south1-b |
us-central1-ai1a |
內布拉斯加州林肯市 (北美洲) | us-central1 |
愛荷華州康索布魯夫 (北美洲) | us-central1-a |
如要查看 AI 專區提供哪些 GPU 和 TPU 類型,請參閱下列資源:
將資源部署至 AI 可用區
您可以透過 Google Cloud 控制台、Google Cloud CLI 或 REST 存取 AI 區域。不過,使用 Google Cloud 控制台建立 VM 時,必須手動選取 AI 可用區。系統不會像標準可用區一樣為您選取。如要搭配下列功能使用 AI 區域,您必須在設定這些資源時明確選取 AI 區域。
特定 Compute Engine 功能:某些 Compute Engine 區域功能不會自動選取 AI 可用區,例如區域大量插入作業或區域代管執行個體群組 (MIG)。
大量插入:如要在區域性大量插入作業中加入 AI 可用區,必須使用
locationPolicy.zones[]欄位。locations[]欄位不支援 AI 專區。以下範例顯示可用區us-south1-ai1b的格式:{ "locationPolicy": { "zones": [ "zones/us-south1-ai1b" ] } }區域性 MIG:如要在所選區域的 AI 可用區中建立執行個體,您必須在分配政策 (
distributionPolicy.zones[]) 中明確指定該可用區,以及其他偏好的可用區。以下範例顯示可用區us-south1-ai1b的格式:{ "distributionPolicy": { "zones": [ "zones/us-south1-a", "zones/us-south1-b", "zones/us-south1-ai1b" ] } }
特定 GKE 功能:AI 可用區不會在特定 GKE 區域功能 (例如區域 GKE 叢集) 中自動選取。如要進一步瞭解 GKE,請參閱本文的「在 GKE 中使用 AI 可用區」一節。
Vertex AI:以 GKE 為基礎的 Vertex AI 區域性產品必須設定 GKE,在區域性叢集中加入 AI 可用區。您不必選擇加入 Vertex AI。Vertex AI 會管理這項設定。
Google Cloud Service Metadata Locations API:使用 locations.list API 時,必須啟用
--extraLocationTypes旗標,確保只有打算使用 AI 區域的使用者才能看到這些區域。非加速器工作負載限制:Compute Engine 會限制在 AI 可用區建立僅限 CPU 的 VM。
在 GKE 使用 AI 可用區
根據預設,GKE 不會在 AI 可用區部署工作負載。如要使用 AI 區域,請設定下列其中一個選項:
ComputeClass:將最高優先順序設為在 AI 可用區中要求隨選 TPU。ComputeClass 可協助您定義工作負載的優先硬體設定清單。如需範例,請參閱「關於 ComputeClass」。
自動佈建節點:在 Pod 規格中使用
nodeSelector或nodeAffinity,指示自動佈建節點功能在 AI 可用區建立節點集區。如果工作負載未明確指定 AI 可用區,自動佈建節點功能在建立新的節點集區時,只會考慮標準可用區。這項設定可確保未執行 AI/機器學習模型的工作負載,會保留在標準可用區,除非您明確設定其他選項。如需使用nodeSelector的資訊清單範例,請參閱「設定自動建立節點的預設可用區」。GKE Standard:如果您直接管理節點集區,請在建立節點集區時,於
--node-locations旗標中使用 AI 可用區。如需範例,請參閱「在 GKE Standard 部署 TPU 工作負載」。
限制
AI 專區不提供下列功能:
AI 可用區的設計考量
設計應用程式以使用 AI 專區時,請考量下列事項。
高可用性 (HA) 注意事項
AI 可用區與上層可用區共用軟體推出作業和基礎架構。為確保工作負載的高可用性,無論是自動或手動選取可用區,請避免採用下列部署模式:
請勿在 AI 區域及其父項區域部署高可用性工作負載。
避免在共用相同父項可用區的兩個 AI 可用區中部署高可用性工作負載。
儲存空間最佳做法
建議採用分層儲存架構,兼顧成本、耐用性和效能:
- 冷儲存層:在標準可用區使用區域 Cloud Storage bucket,以高耐用性持久儲存訓練資料集和模型檢查點。
效能層:使用專門的可用區儲存空間服務,做為高速快取或臨時暫存空間。這種做法可消除可用區之間的延遲,並在執行中的工作期間盡可能提高有效處理量。
為確保 GPU 和 TPU 保持飽和狀態,盡可能提高有效輸送量,請在與運算資源相同的 AI 區域中佈建效能層。
建議採用下列儲存空間解決方案,搭配 AI 可用區,充分提升 AI 和機器學習系統效能:
| 儲存服務 | 說明 | 用途 |
|---|---|---|
| Cloud Storage 的 Anywhere Cache 功能 | 全代管、採用 SSD 的可用區唯讀快取,可將 bucket 中經常讀取的資料帶入 AI 可用區。 | 建議對象:
|
納入或排除 AI 專區
如要手動納入或排除 AI 區域,請使用篩選器:
- 如要篩選可用區清單,只顯示 AI 可用區,請參閱「搜尋 AI 可用區」。
- 如要篩選可用區清單,排除 AI 可用區,請參閱「從清單中排除 AI 可用區」。