

在大语言模型 (LLM) 不断发展的格局中,“每台机器一个模型”的部署模式正在成为企业 LLM 服务成本效益的重大瓶颈。LLM 通常需要大量硬件预留(例如完整的 8x H100 GPU 节点)来管理峰值负载。不过,在标准操作期间,这些昂贵的资源往往未得到充分利用,从而导致总拥有成本 (TCO) 居高不下。
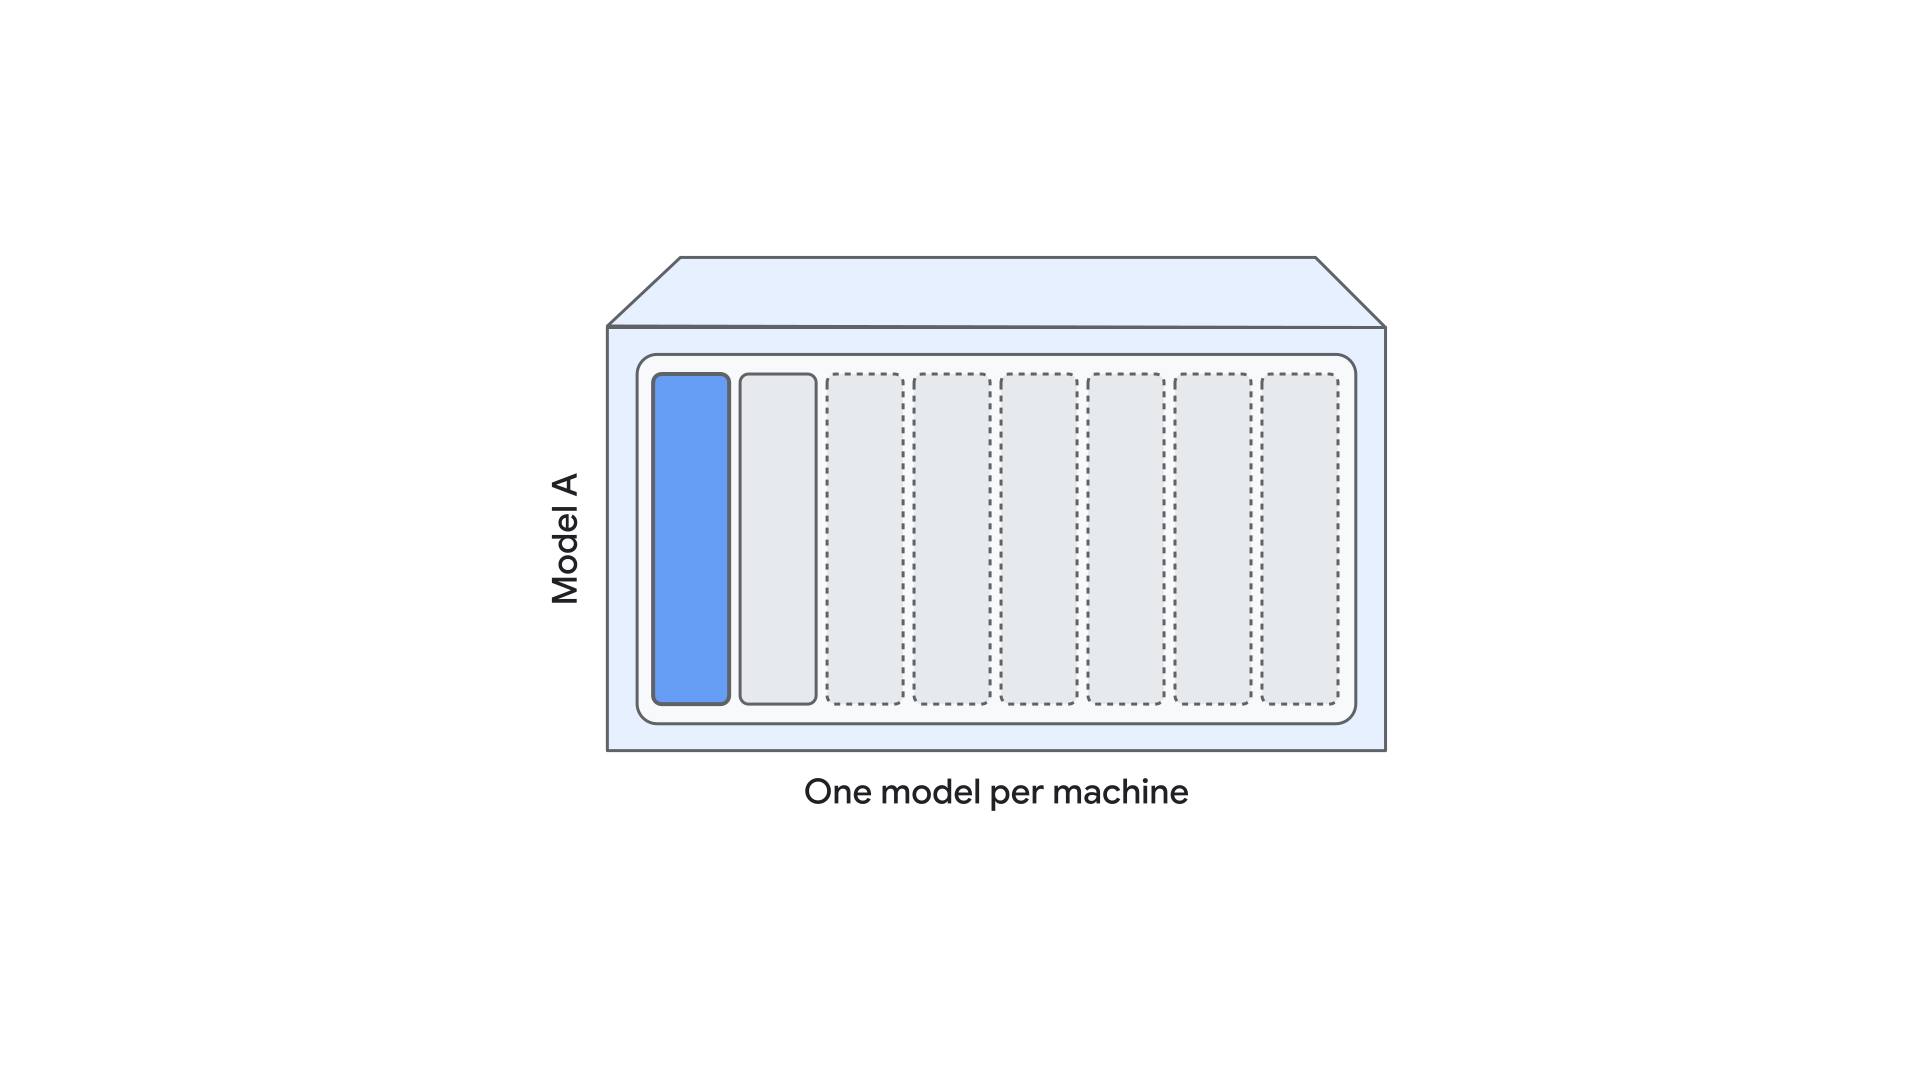
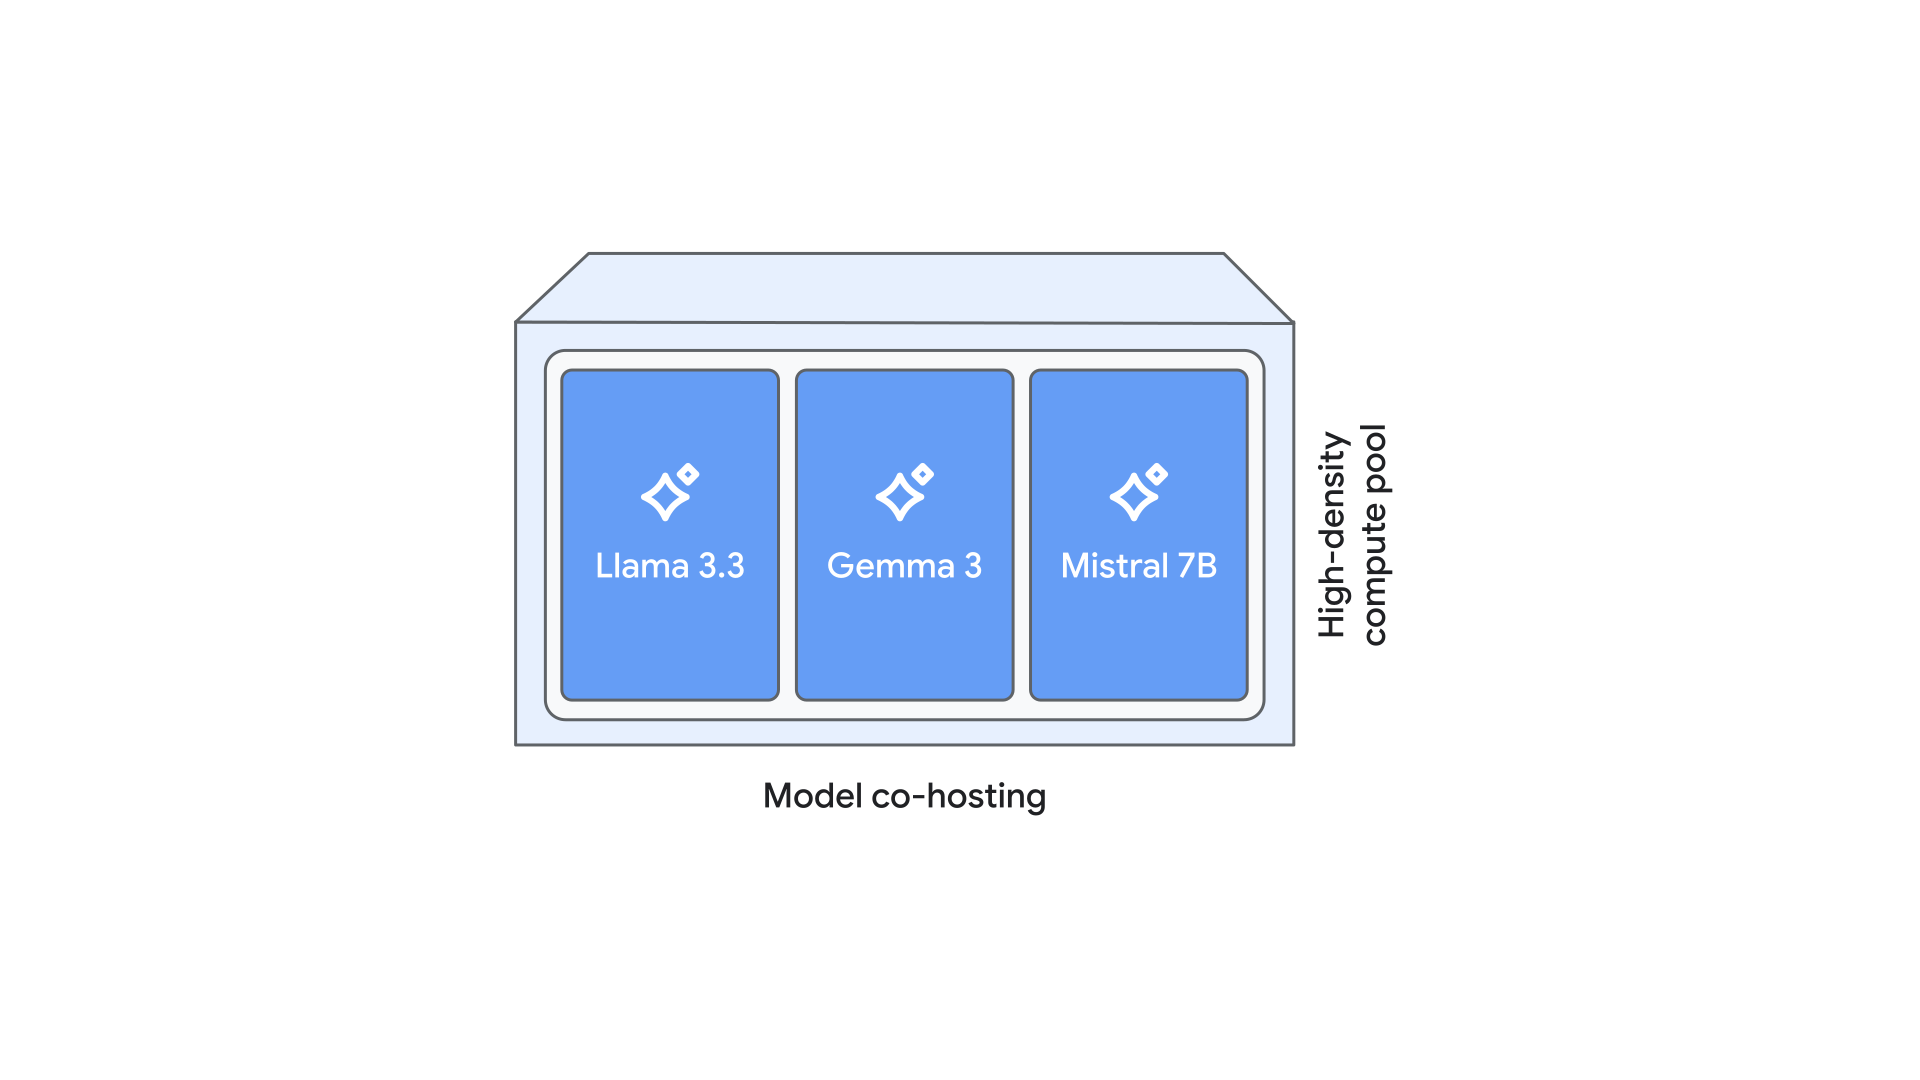
模型共同托管通过允许多个模型实例共享同一虚拟机和 GPU 资源,解决了这一效率差距。这包括完全不同的模型,例如 Llama 3.3 和 Gemma 3。通过利用子 GPU 内存切片和智能资源分区,Vertex AI Model Garden 可将静态硬件预留转换为灵活的高密度计算池。
这篇技术博文详细介绍了 Vertex AI Engineering 将模型共同托管功能引入可用于生产用途的云服务的过程。我们将分享容器级实现策略的方法、确定最佳服务配置的方法,以及我们广泛的多模型基准研究中的关键发现,帮助您最大限度地提高 LLM 服务成本效益。
了解模型共同托管:概念和架构
模型共同托管是一种高密度服务策略,可让多个大语言模型 (LLM) 实例或不同的模型架构在单个虚拟机 (VM) 中共享相同的物理硬件资源。与将整个虚拟机或 GPU 专用于单个模型的传统部署模式不同,共同托管利用精细的资源分区来最大限度地提高硬件投资回报率,并提高内存和计算资源的利用率。
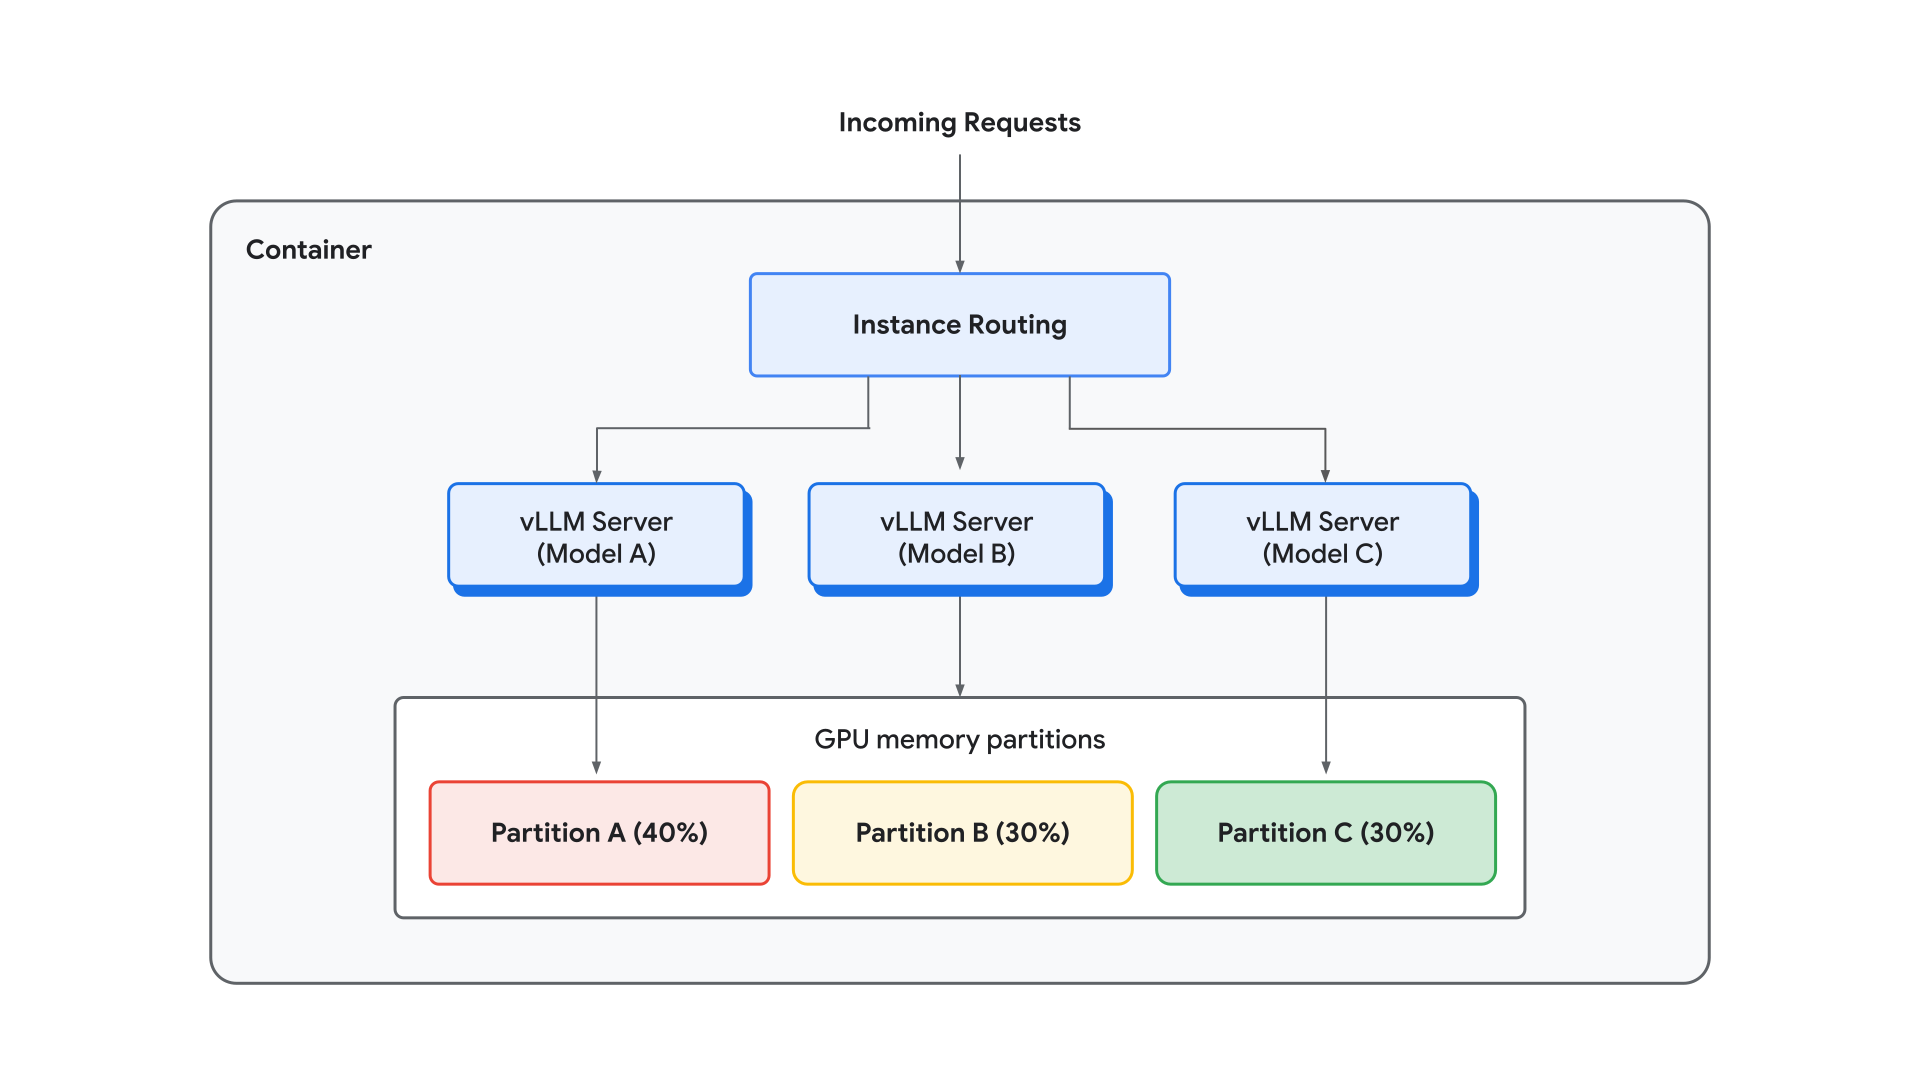
我们的实现侧重于容器级解决方案,该解决方案允许同时提供具有独立配置的多个模型。此架构通过多种集成技术机制运行,首先是在单个容器中部署多个独立的模型服务器实例。每个实例都充当模型服务器的完整独立副本,从而可在整个虚拟机中同时处理请求。为了管理此流量,我们在容器内实现了一个实例路由层,该层可在活跃实例之间高效分配传入请求。
这种设计提供了精细的并行性,允许每个共存模型利用专用的服务配置,并为张量并行 (TP)、流水线并行 (PP) 和特定数量的模型实例提供独特的设置。此外,还辅以资源切片技术,为每个模型分配特定的 GPU 内存分区(例如每个模型 0.4 个 GPU 内存分区),以确保各种工作负载在同一加速器上共存,而不会相互争夺关键内存资源。这种架构方法将静态硬件预留(例如完整的 8x H100 GPU 节点)转换为灵活的计算池,能够服务于多样化的产品组合,从大型推理模型到小型、低延迟的聊天模型。
原型设计和基准研究
在开发可用于生产环境的编排器之前,我们进行了全面的基准研究,以验证模型共宿的理论效率。此阶段旨在全面测试 vLLM 的原生并行性,并精确量化模型共享同一芯片时的“干扰”程度。
并行性调查:寻找“交叉点”
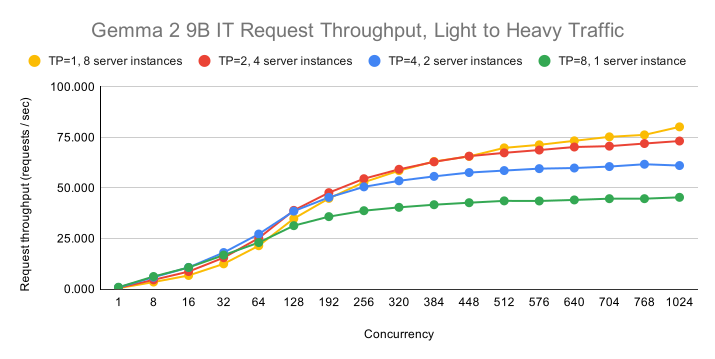
我们的初步分析侧重于 vLLM 的原生张量并行处理 (TP) 和模型实例的 Vertex 实现(作为多个 vLLM 服务器实例),以确定这些策略如何与不同的用户负载进行交互。我们发现,最佳配置高度依赖于并发性;在并发性较低时,高张量并行处理(例如 TP=8)通过在所有可用加速器之间分布层,为单个请求提供最低延迟。但是,随着并发流量的增加,瓶颈会发生变化。为了在高负载条件下最大限度地提高吞吐量,最佳配置会从 TP=8 转换为 TP=4、TP=2,最后转换为 TP=1,同时增加独立模型实例的数量。这种转变定义了一个“交叉点”,即在低 TP 设置下,GPU 间通信延迟降低带来的好处超过了高 TP 执行的原始速度。下图是 Gemma 2 9B IT 模型的交叉点图表。
最佳伸缩:单模型、多副本
为了建立严格的可伸缩性基准,我们对在单个节点上提供同一模型的多个实例进行了基准测试。在饱和流量条件下(每个 GPU 2,048 个并发请求),在 8xH100 节点上启动 8 个独立的 vLLM 服务器实例,与单 GPU 基准相比,吞吐量提高了大约 7.8 倍,而延迟时间几乎没有增加。
基础设施比较:容器与 Pod 协同调度
我们进一步评估了容器级编排与原生基础架构级解决方案(特别是 Pod 协同调度)的对比情况。虽然这两种解决方案在多副本服务方面提供了相当的性能,但我们最终还是为最简可行产品 (MVP) 选择了容器级方法。之所以做出这一决定,是因为容器级解决方案在异构共存方面具有卓越的灵活性,使开发者能够通过不受底层 Kubernetes 调度限制约束的精细软件定义内存分区,并排提供不同的模型架构。除此之外,容器级编排还支持更快的迭代,并且更易于自定义和创新。
干扰测试:共同托管不同的模型
原型设计的最后一个里程碑是“干扰测试”,我们在同一虚拟机上共同托管了 Gemma-3n-E2B-it 和 Llama-3.1-8B-Instruct。每个模型分配了 0.4 GPU 内存分区,服务性能与单模型基准几乎相同。例如,Gemma-3n 在共存环境中的请求数为 30.21,而在隔离环境中的请求数为 30.96。这些结果证实,只要适当划分内存资源以防止 KV 缓存耗尽,即使在高流量下,共存模型之间也几乎没有计算干扰。
MVP 容器实现
从经过验证的基准过渡到可用于生产用途的系统,需要设计一个强大的容器化编排器。此开发阶段的重点是构建一个高级软件层,该软件层能够管理多个模型生命周期的复杂性,同时确保确定性资源隔离。
模型共同托管服务器设计
我们实现的核心是 model_cohost_server,这是一个自定义入口点,旨在充当容器内的主编排器。该服务器不采用标准的单进程模型,而是实现了子进程管理,从而能够将多个独立的模型服务器实例(例如 vLLM)作为隔离的子进程并发执行。为了管理传入流量,编排器采用高级请求路由,通过 --served-model-name 等参数按其唯一模型标识符识别请求,并将其定向到相应的内部服务器实例。除了路由之外,服务器还提供全面的生命周期编排,用于管理所有共存实例的初始化、健康状况监控和终止。这种集中管理方式为外部流量提供了一个统一的端点,同时保持了每个子流程的独特操作边界。
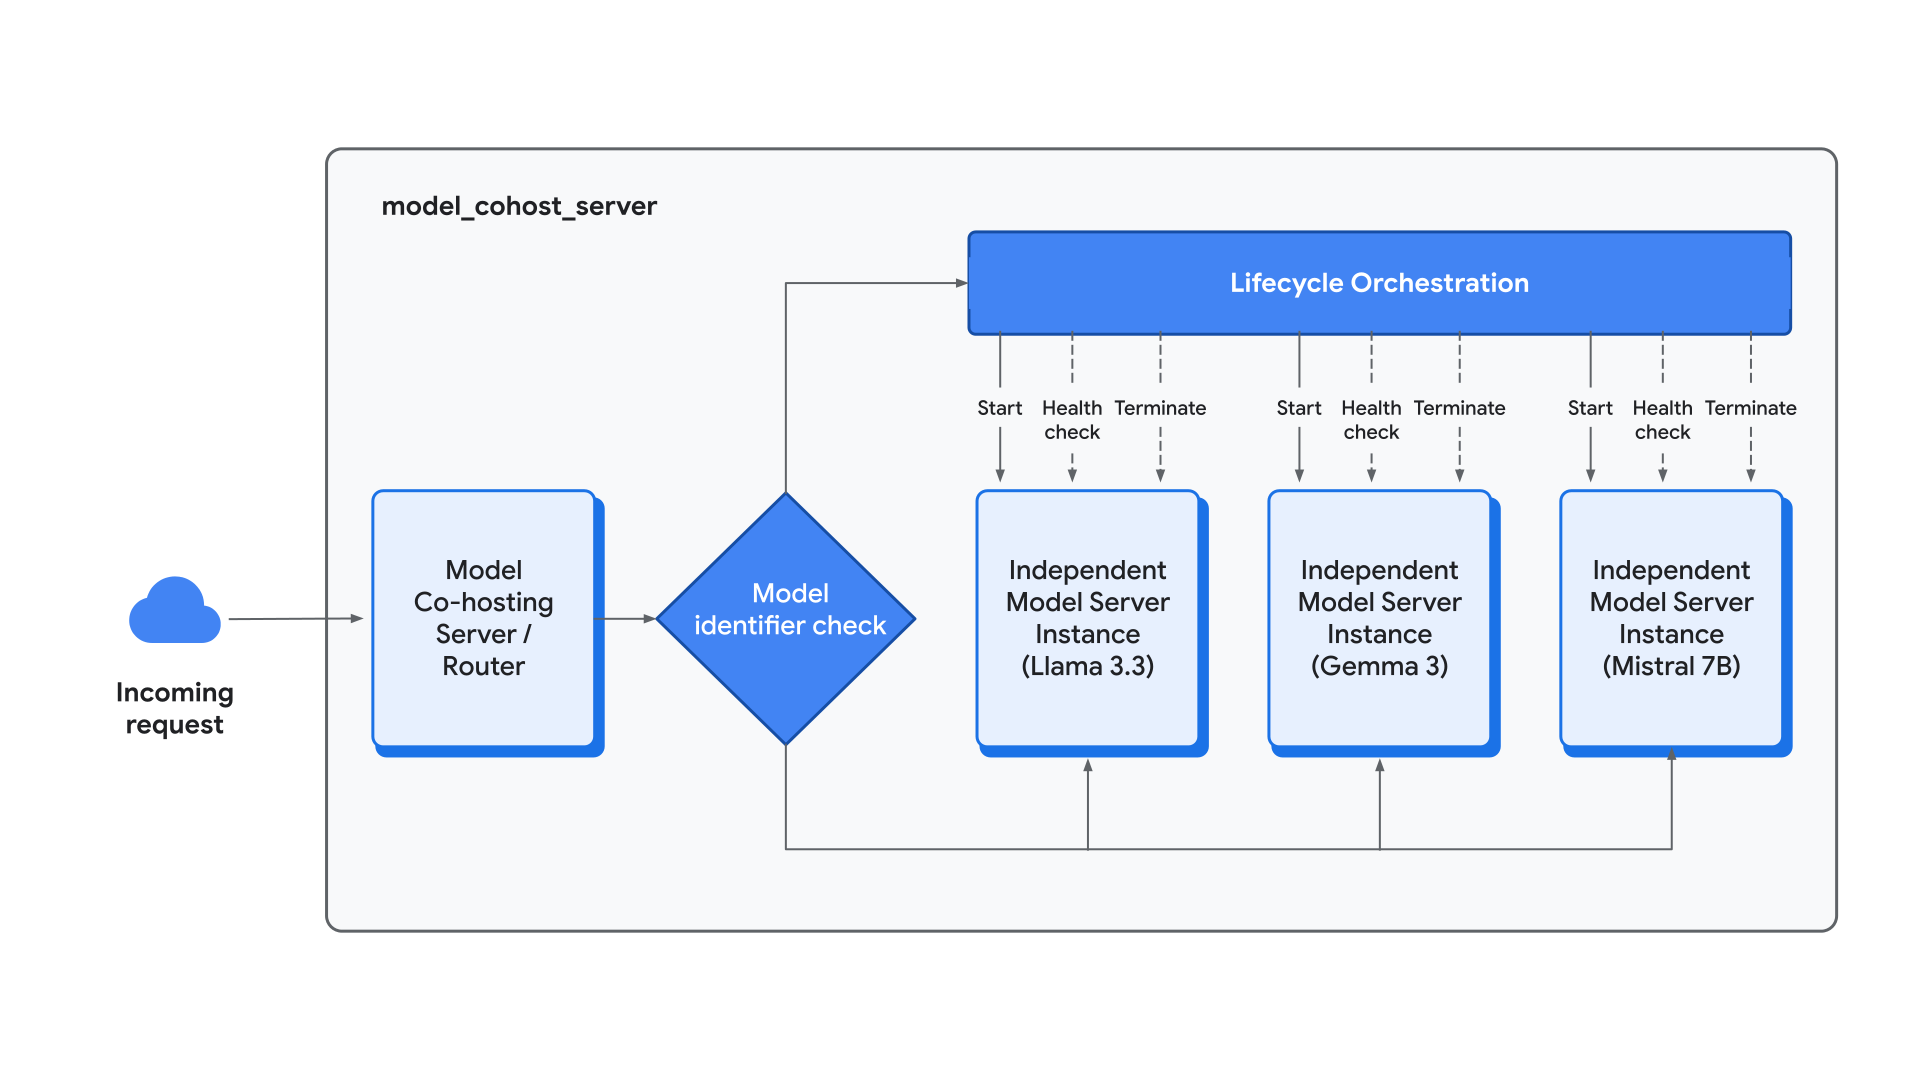
GPU 资源分区:确定性切片
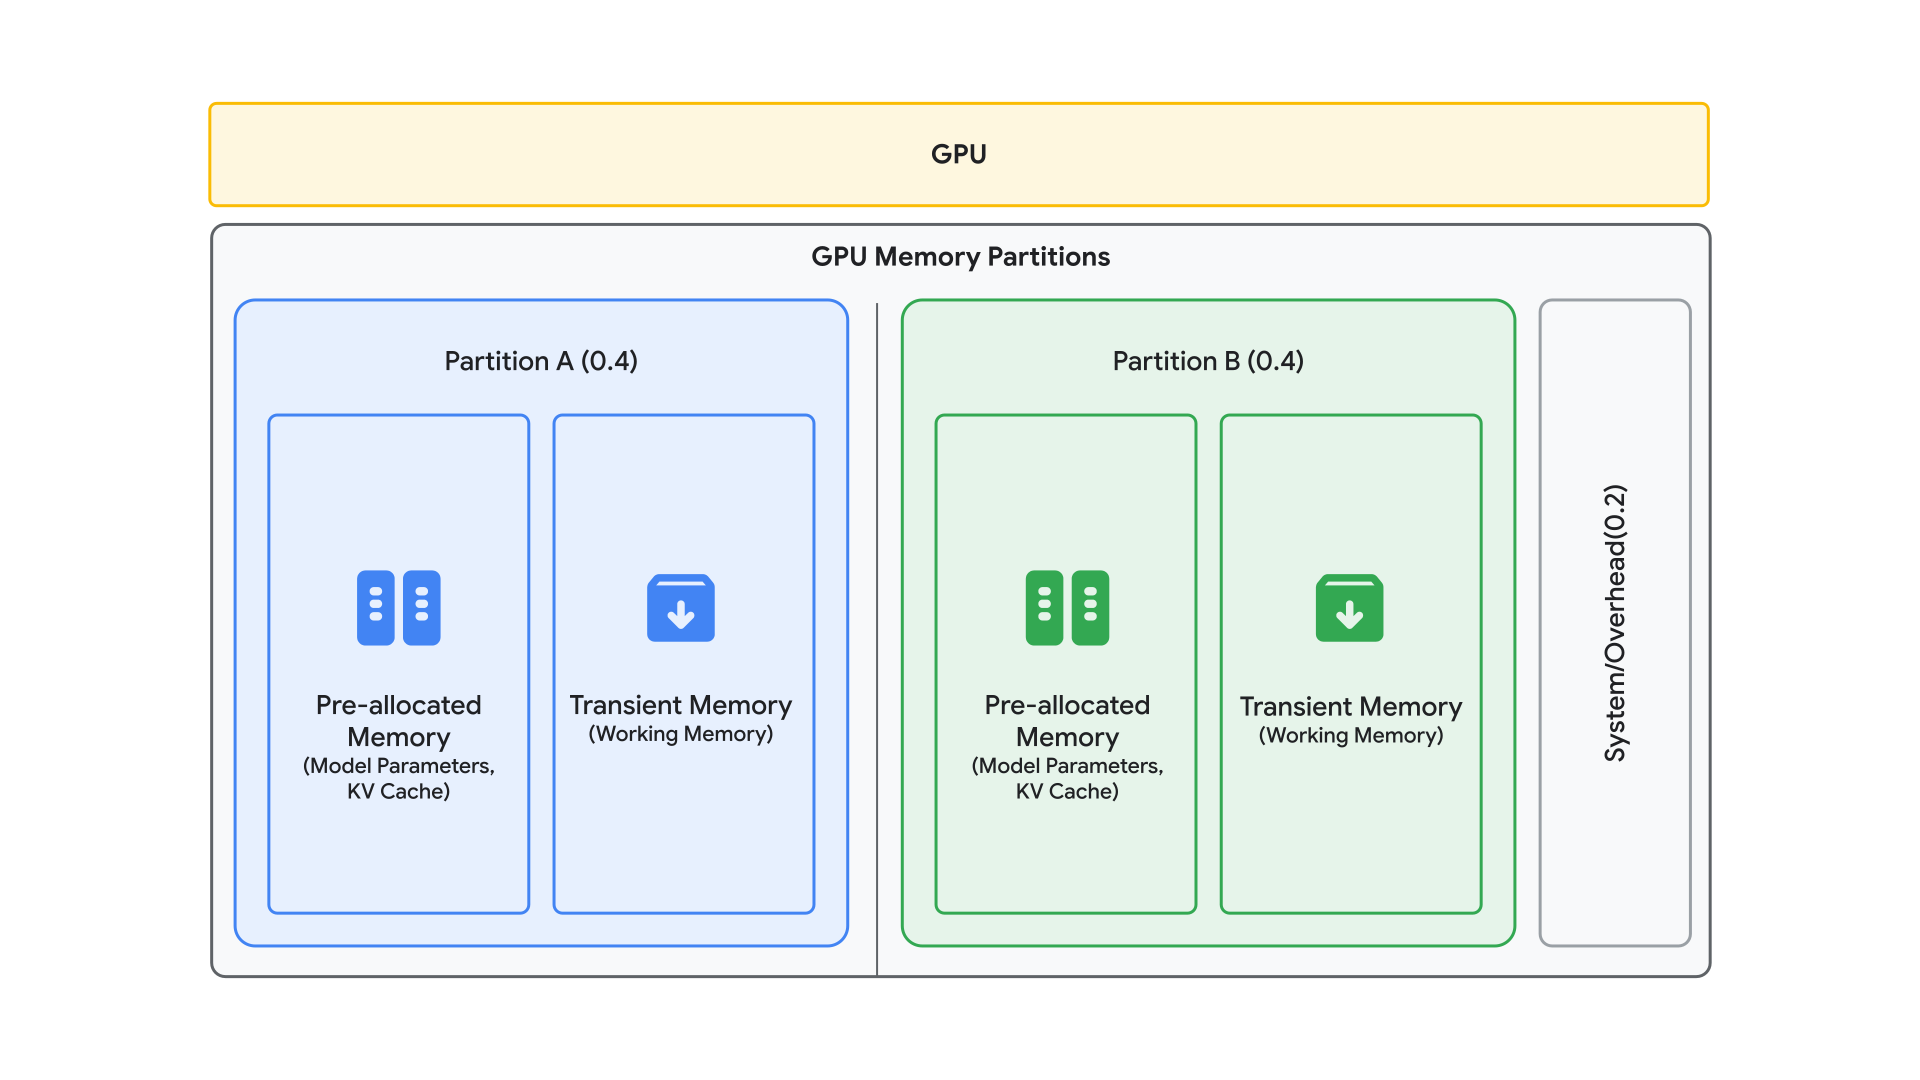
为了消除单个模型的工作负载在共用环境中触发内存不足 (OOM) 错误的风险,我们实施了严格的资源切片机制。这通过 gpu-memory-partition 参数实现,该参数允许开发者定义明确的内存比率(例如 0.4、0.4),以便为每个单独的模型实例预留节点总 GPU 内存的固定百分比。
为了指导这种分配,我们采用了“预分配与瞬态”内存模型,该模型可区分静态和动态资源需求。“预分配”内存由用于模型权重和 KV 缓存的内存组成。用于模型权重的内存量取决于模型的参数数量和精度。例如,BF16 中的 8B 参数模型需要大约 16GB 的静态存储空间。用于 KV 缓存的内存量取决于模型维度、精度、上下文长度和序列数量。“瞬态”内存由中间计算和推理工作内存组成。gpu-memory-partition 参数用于说明“预分配”的内存。我们建议通过将 gpu-memory-partition 的总和设置为小于 1.0,为“瞬态”内存留出缓冲空间。
产品化
使用 Vertex AI 进行模型共同托管的产品化阶段致力于为单模型多副本和多模型服务配置建立无缝、可用于生产的环境。这一转变有效地将经验基准测试结果转化为简化的部署工作流和深度集成的基础设施支持结构。
简化的部署工作流
为了降低高密度服务的准入门槛,我们使用与现有 Vertex AI API 原生集成的自定义容器参数,对共同托管配置进行了标准化。对于全形虚拟机(例如 8x H100 节点),我们开发了一个基准实用程序,可针对您的特定应用场景自定义最佳方案。这些基准实用程序可让您找到根据模型的特定参数数量和精度自动平衡张量并行处理 (TP)、流水线并行处理 (PP) 和模型实例数量的配置。此外,还提供强大的 Deployment API 支持,让开发者可以直接在标准 deployModel 请求中指定这些精细参数(包括确切的 GPU 内存分区),并部署模型。
动态多模型服务
我们在技术发展历程中取得的一项重大进展是从静态配置过渡到动态服务架构。此功能对于流量模式快速变化的生产环境至关重要,因为无需完全重启容器即可加载或卸载模型的能力对于保持基础架构敏捷性和高可用性至关重要。
Dynamic Update API (update_models)
为了解决不可变部署的固有局限性,我们在 Vertex Gemini Enterprise Agent Platform Model Garden vLLM 模型共宿容器中实现了一个专用模型更新 API。此 API 有助于实现热重新加载,使服务器能够根据存储在 Cloud Storage 存储桶中的集中式配置文件,动态调整其托管模型的组合。
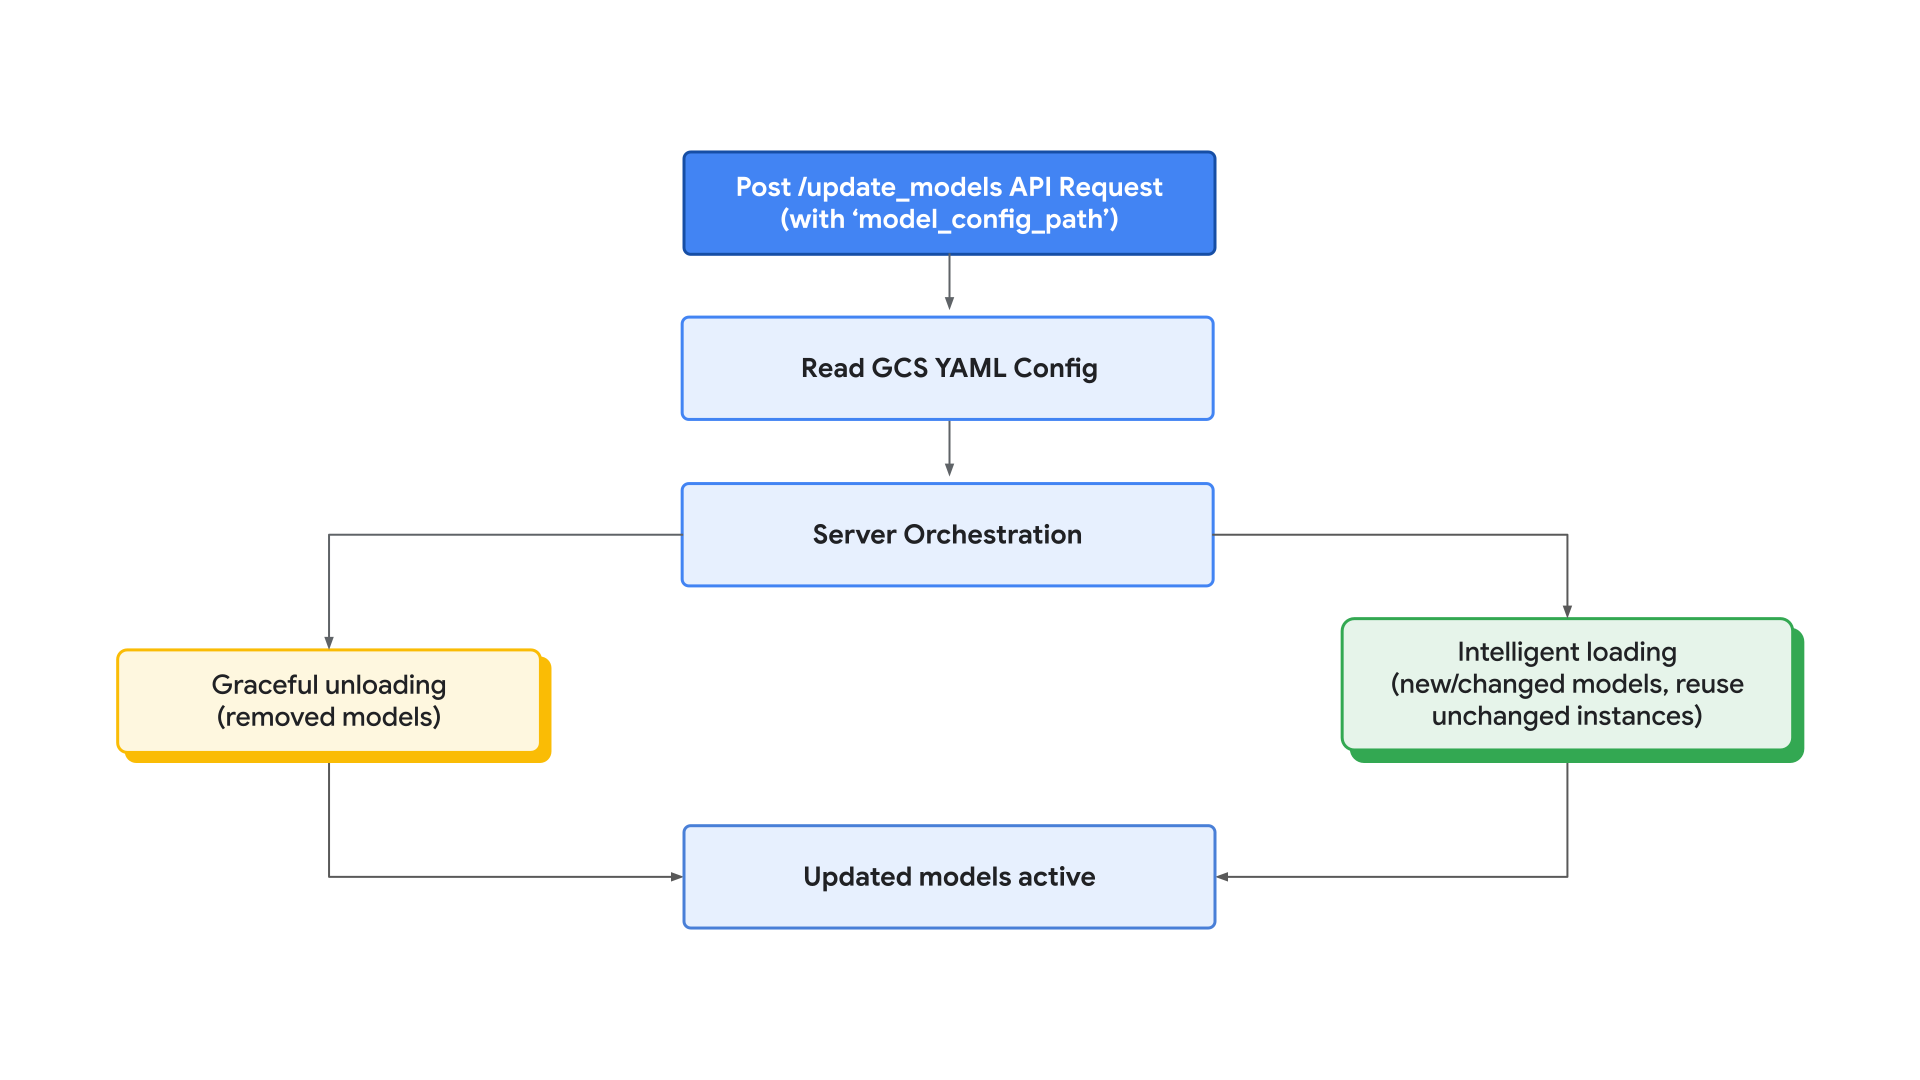
更新流程通过向 update_models 端点发送 POST 请求来启动,该请求包含指向 Cloud Storage YAML 文件的 model_config_path。收到此请求后,服务器会执行多阶段编排序列,该序列经过优化,可最大限度地减少停机时间:
- 平稳卸载:系统会识别新配置中不存在的模型,并首先终止其子进程,从而立即回收 GPU 内存和计算资源。
- 智能加载和重复使用:然后,服务器会初始化新的模型实例。至关重要的是,如果模型的并行设置(例如张量并行 [TP] 或流水线并行 [PP])及其分配的内存分区保持不变,编排器会重复使用现有的运行实例。此优化会绕过成本高昂的重新初始化阶段,确保活跃服务在配置切换期间不会中断。
延迟时间和性能分析
对这些更新策略的实证分析表明,动态热重新加载可显著缓解通常与大规模 LLM 服务相关的“冷启动”代价。
总结
借助 Vertex AI 进行模型共同托管代表着一种根本性的范式转变,即从刚性、硬件密集型的单体式部署过渡到灵活高效的服务架构。通过从“每个虚拟机一个模型”的标准演变为高密度计算池模型,组织可以显著降低总拥有成本 (TCO),同时保持(通常还能提高)性能基准。
我们的工程历程和广泛的多模型基准研究为该架构制定了一套明确的生产指南:
- 没有一种配置适用于所有情况。我们主张针对特定用例(模型、硬件、流量)寻找最佳服务方案,并为此构建工具。
- 通过副本扩缩吞吐量。
- 通过打破硬件边界并以更精细的级别拆分内存,提高资源利用率。
为了成功实现共同托管架构,我们建议采用以下技术工作流:
- 显式分区:使用
--gpu-memory-partitions参数为各个模型分配内存资源。 - 迭代基准测试:利用提供的基准测试实用程序,确定工作负载的特定“并发交叉”点,即实例数量、TP 和 PP 的“最佳”配置。
在 Google Cloud Model Garden 上实现共宿,为构建高密度 AI 应用提供了可伸缩的蓝图。我们鼓励开发者探索这些功能,并使用提供的教程笔记本重现我们的基准,以针对其特定企业要求优化服务配置。
感谢阅读
欢迎您就 Vertex AI 提供反馈和提出问题。
致谢
我们谨向 Google Cloud Vertex AI 团队表示诚挚的感谢。特别感谢 Bo Wu 和 Ting Yu 在整个项目中的领导和指导,以及 Deborah He、Shawn Ma、Desmond Liu、Yang Pan、Surya K G Tangatur 和 Luis Rizo 的宝贵贡献。