

在大型語言模型 (LLM) 不斷演進的環境中,「每部機器一個模型」的部署模式,已成為企業 LLM 服務成本效益的重大瓶頸。LLM 通常需要大量預留硬體資源,例如完整的 8x H100 GPU 節點,才能因應尖峰負載。不過,在標準作業期間,這些昂貴的資源往往未充分利用,導致總持有成本 (TCO) 偏高。
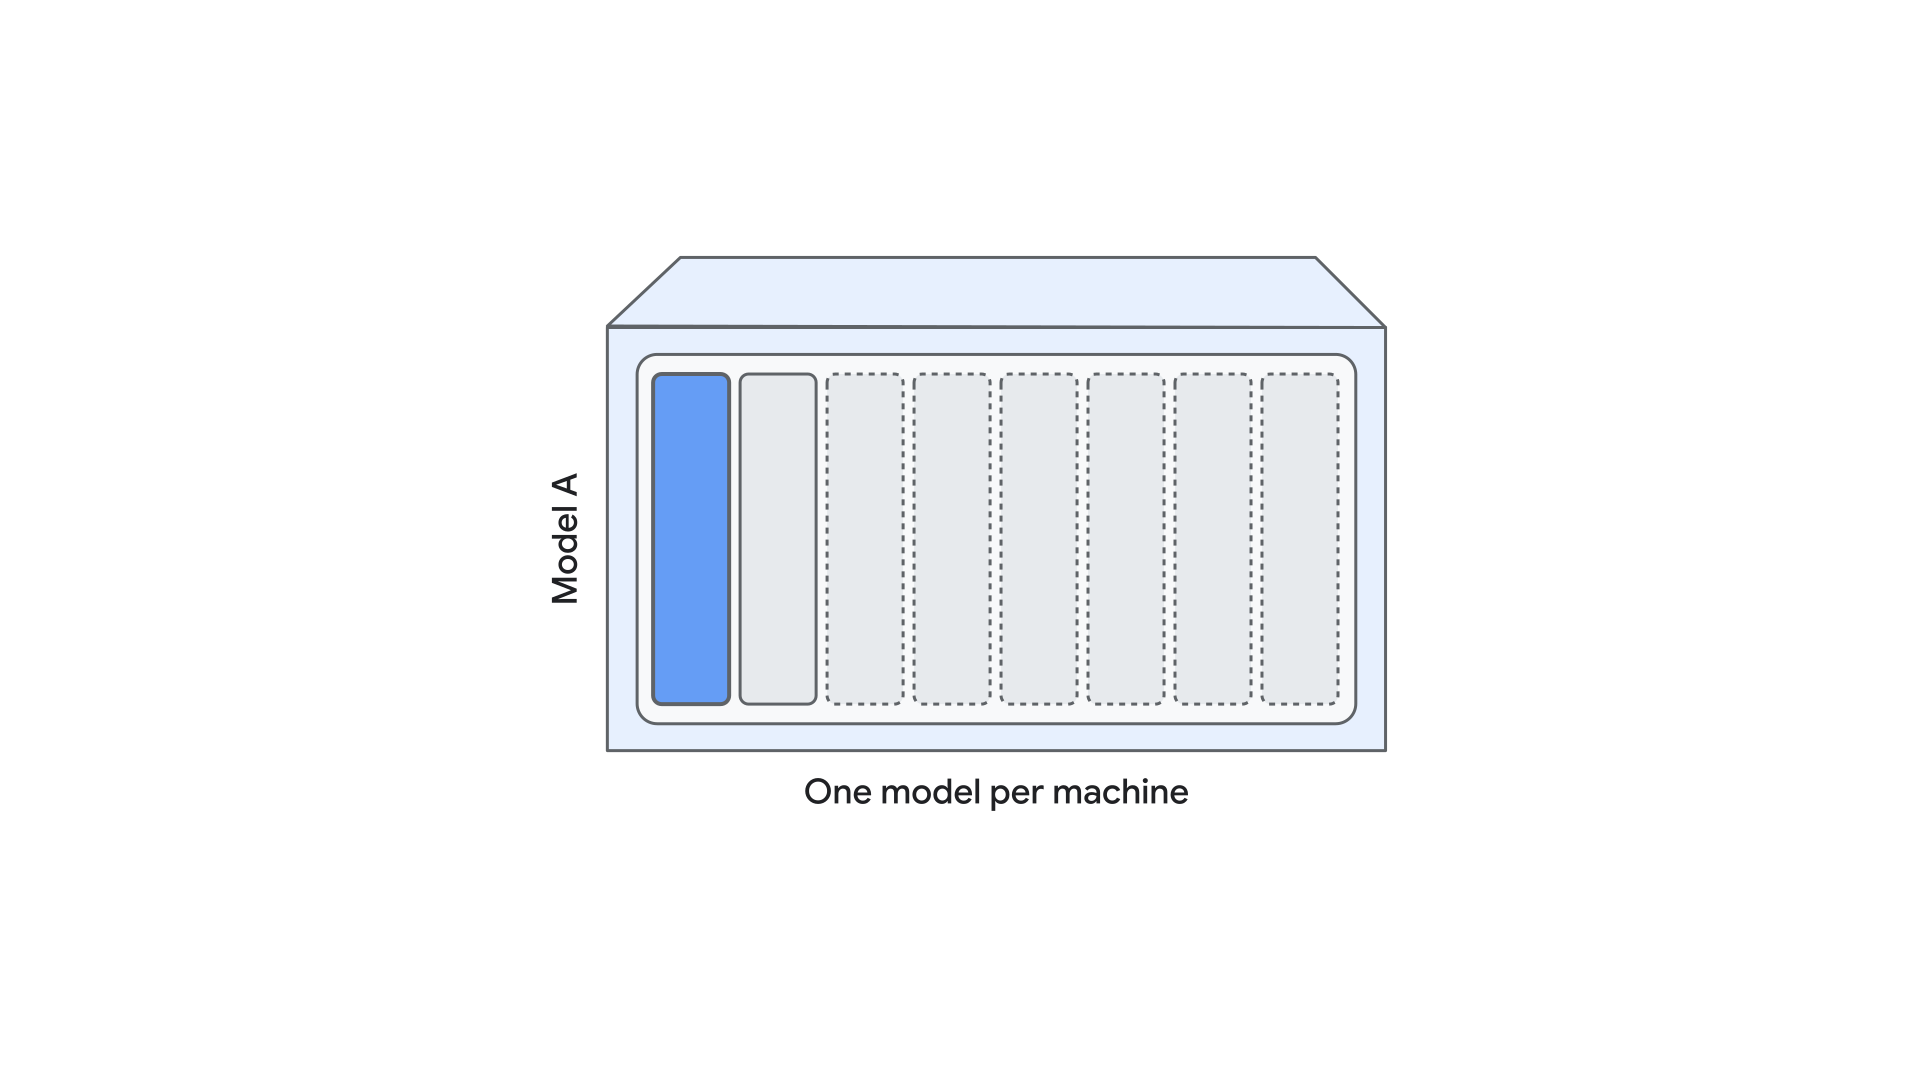
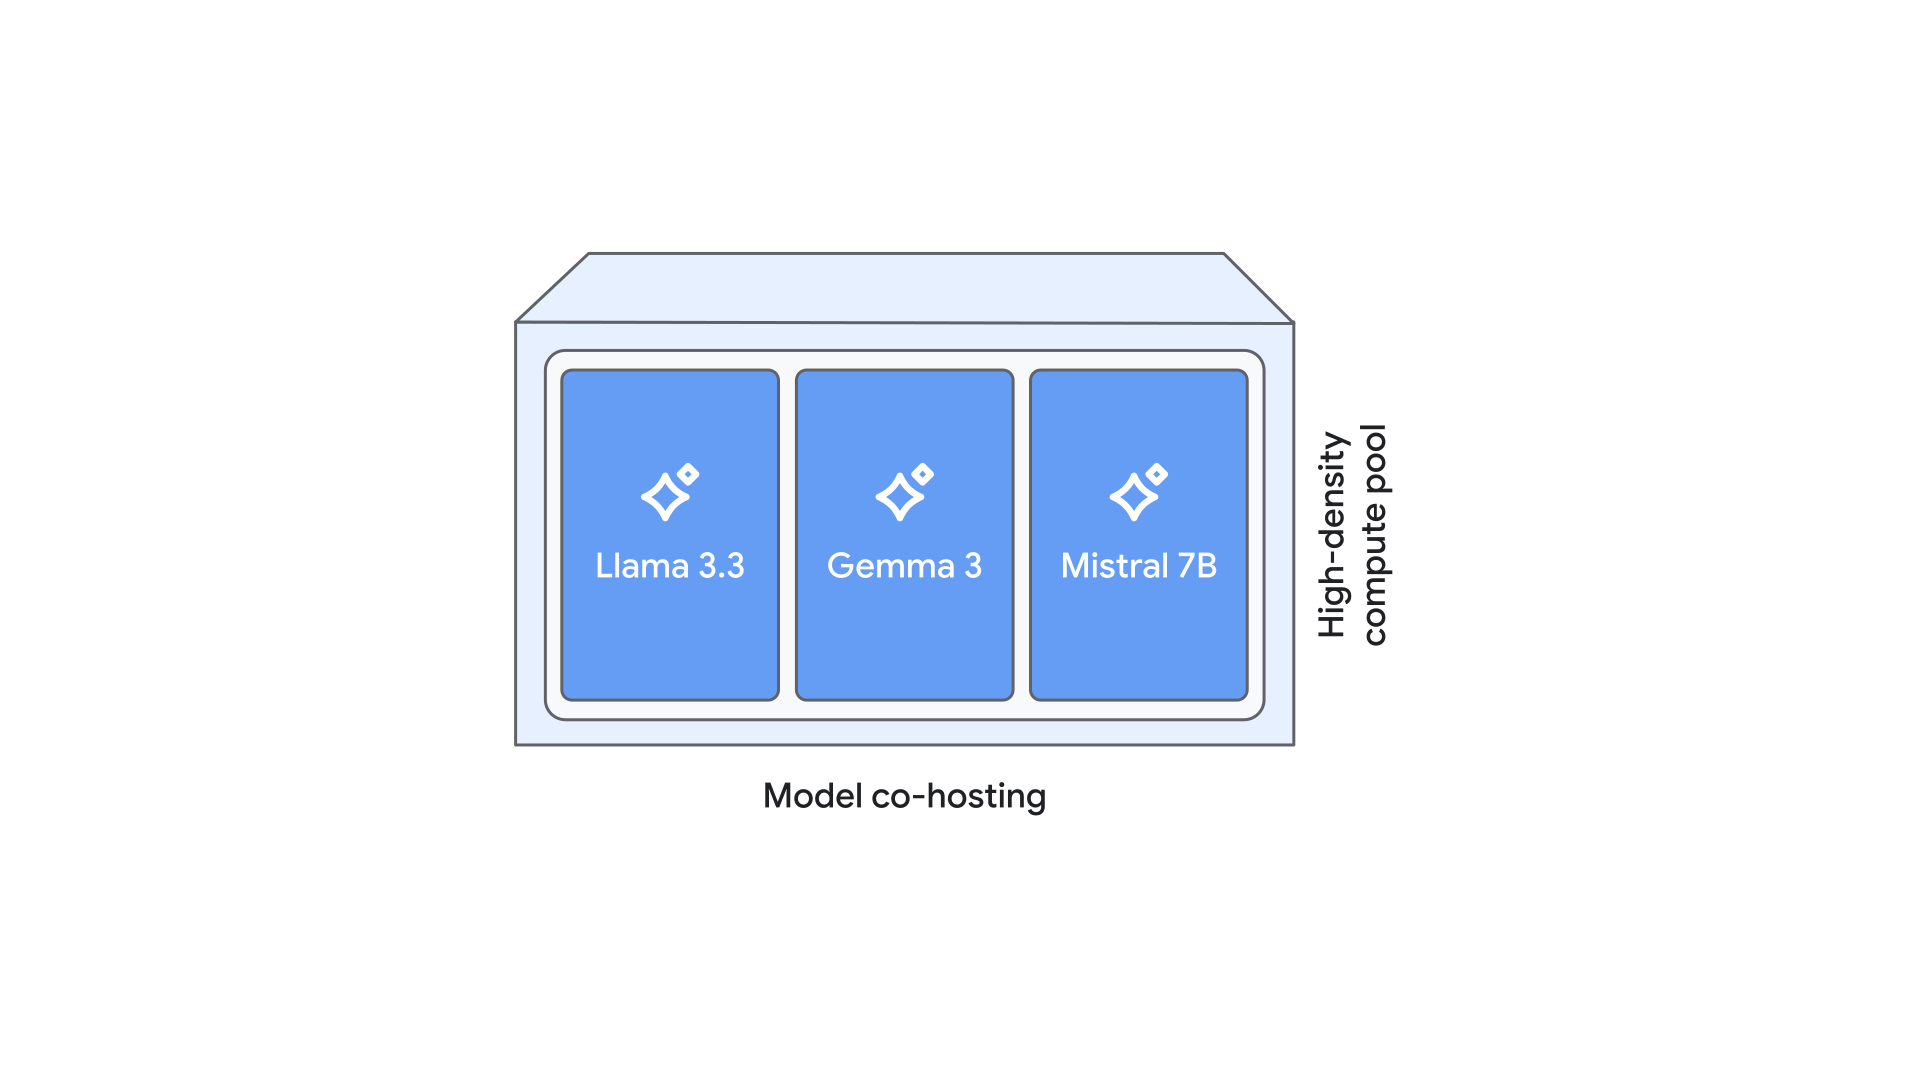
模型共同託管可讓多個模型執行個體共用相同的虛擬機器和 GPU 資源,解決效率不彰的問題。包括 Llama 3.3 和 Gemma 3 等完全不同的模型。Vertex AI Model Garden 運用子 GPU 記憶體切片和智慧型資源分區,將靜態硬體預留項目轉換為彈性的高密度運算集區。
這篇技術網誌詳細說明 Vertex AI Engineering 如何將模型共同託管功能,導入可正式使用的雲端服務。我們將分享容器層級實作策略的方法、找出最佳服務設定,以及從廣泛的多模型基準研究中獲得的重要發現,協助您充分提高 LLM 服務成本效益。
瞭解模型共同託管:概念和架構
模型共同託管是一種高密度服務策略,可讓多個大型語言模型 (LLM) 執行個體或不同的模型架構,在單一虛擬機器 (VM) 中共用相同的實體硬體資源。傳統部署模式會將整個 VM 或 GPU 專用於單一模型,共同託管則不同,會使用精細的資源分區,盡可能提高硬體投資報酬率,並提高記憶體和運算資源的使用率。
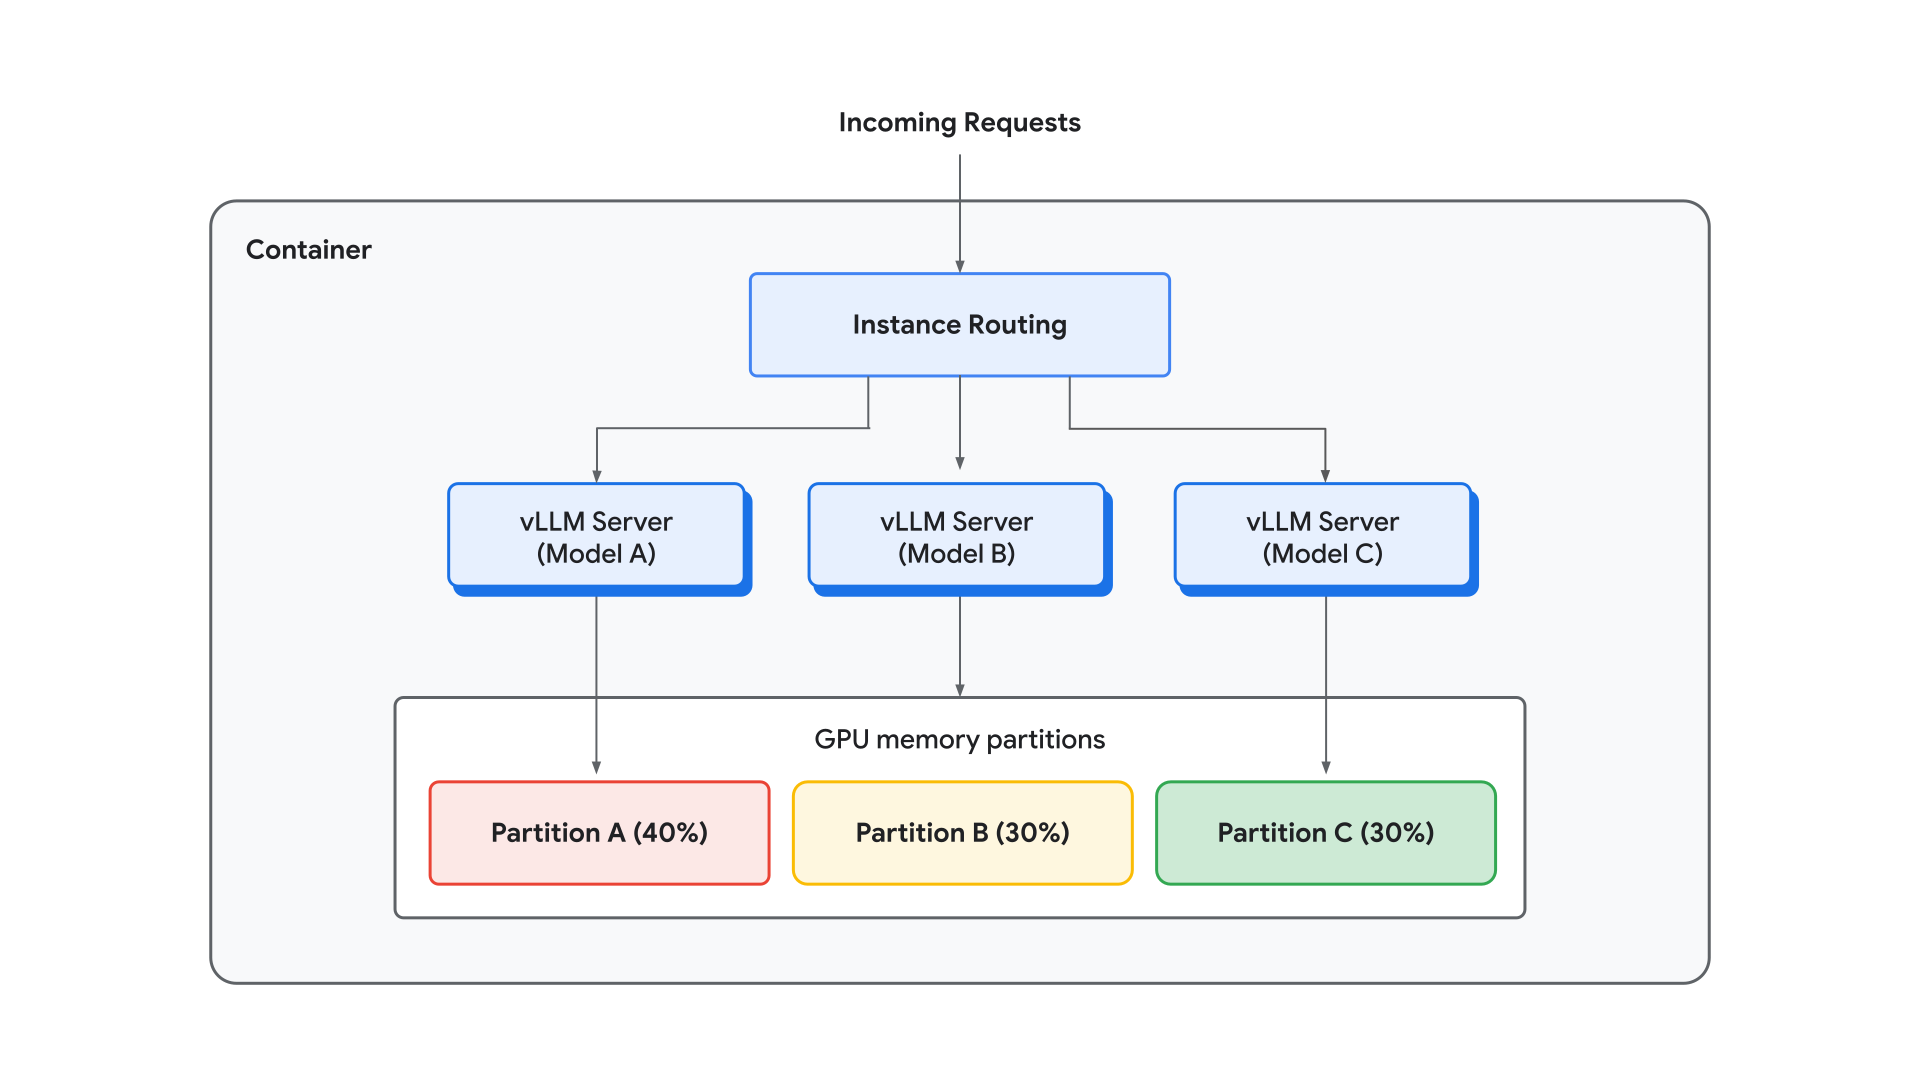
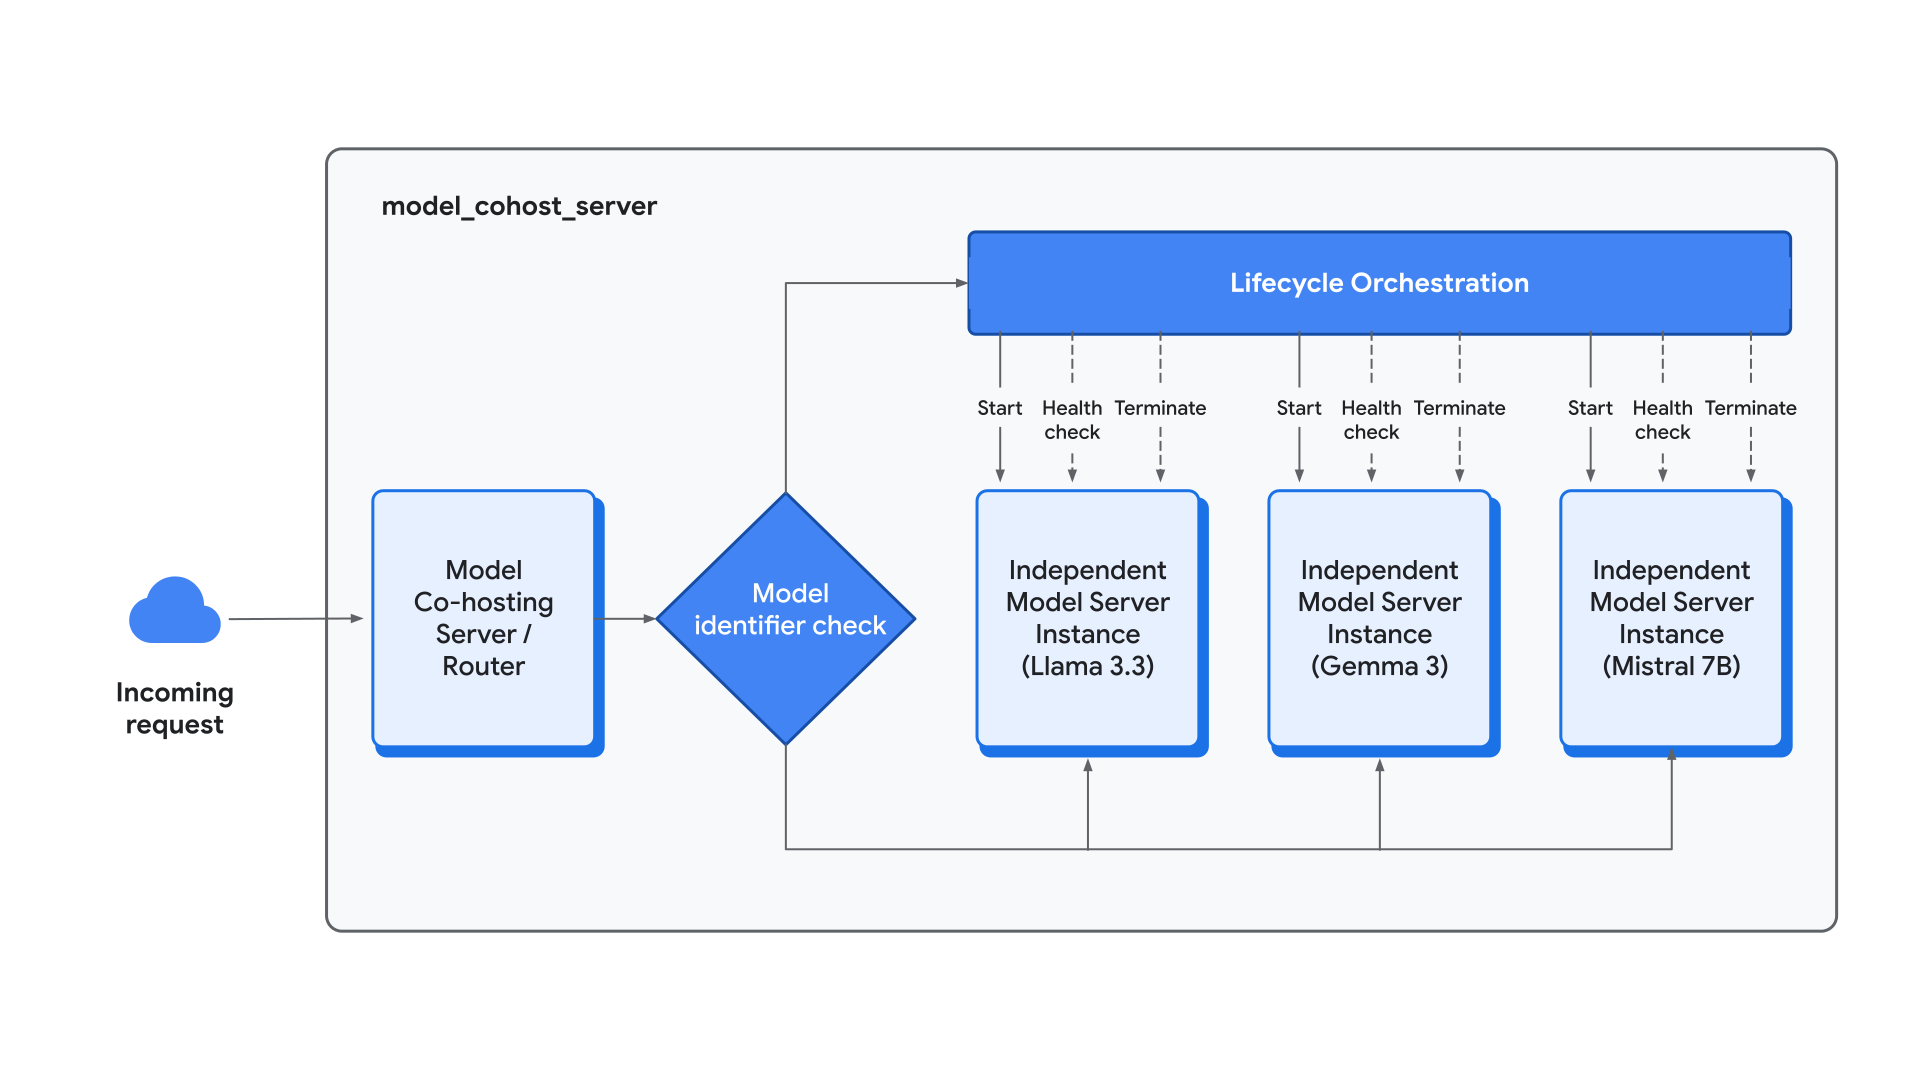
我們的實作方式著重於容器層級解決方案,可同時提供多個具有獨立設定的模型。這個架構透過多項整合技術機制運作,首先是在單一容器中部署多個獨立的模型伺服器執行個體。每個執行個體都是模型伺服器的完整獨立副本,可在虛擬機器中同時處理要求。為了管理這類流量,我們在容器中導入執行個體轉送層,有效將傳入要求分配給各個運作中的執行個體。
這項設計可讓每個共同託管的模型使用專屬服務設定,並針對張量平行處理 (TP)、管道平行處理 (PP) 和特定數量的模型執行個體進行獨特設定,提供精細的平行處理功能。此外,資源切片功能會將特定 GPU 記憶體分區指派給各個模型 (例如每個模型 0.4 個 GPU 記憶體分區),確保多種工作負載在同一個加速器上共存,不會互相爭奪重要記憶體資源。這種架構方法可將靜態硬體預留項目 (例如完整的 8x H100 GPU 節點) 轉換為彈性的運算集區,能夠提供多樣化的產品組合,從大型推論模型到小型、低延遲的對話模型,一應俱全。
原型設計和基準研究
在開發可部署於正式環境的自動調度管理工具之前,我們進行了全面的基準研究,驗證模型共同託管的理論效率。這個階段旨在徹底測試 vLLM 的原生平行處理能力,並精確量化模型共用相同晶片時的「干擾」程度。
平行處理調查:找出「交叉點」
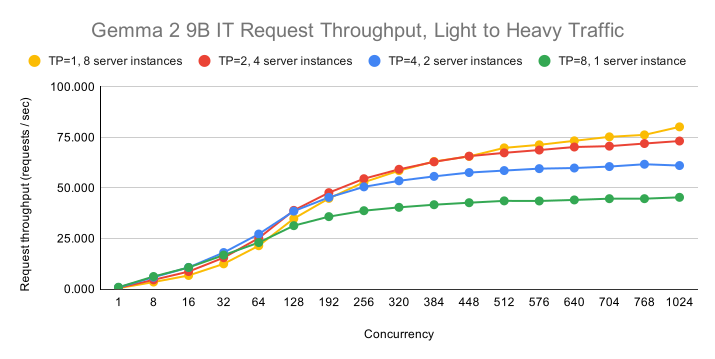
我們一開始著重分析 vLLM 的原生張量平行處理 (TP),以及 Vertex AI 將模型執行個體實作為多個 vLLM 伺服器執行個體的方式,藉此判斷這些策略如何與不同的使用者負載互動。我們發現,最佳設定高度取決於並行程度。在並行程度較低時,高張量平行處理 (例如 TP=8) 會將層分散到所有可用的加速器,為個別要求提供最低延遲。不過,隨著並行流量增加,瓶頸會轉移。如要在高負載條件下盡可能提高處理量,最佳設定會從 TP=8 轉換為 TP=4、TP=2,最後轉換為 TP=1,同時增加獨立模型執行個體的數量。這項轉換定義了「交叉點」,也就是在低 TP 設定中,減少 GPU 間通訊延遲的好處,超過高 TP 執行的原始速度。下圖是 Gemma 2 9B IT 模型的交叉點圖表。
最佳擴充:單一模型、多個副本
為了建立嚴謹的可擴充性基準,我們在單一節點上,對同一個模型的多個執行個體進行基準測試。在飽和流量條件下 (每個 GPU 2048 個並行要求),在 8xH100 節點上啟動八個獨立的 vLLM 伺服器執行個體,與單一 GPU 基準相比,處理量約提升 7.8 倍,且延遲時間幾乎沒有退步。
基礎架構比較:容器與 Pod 共同排程
我們進一步評估容器層級自動調度管理,並與原生基礎架構層級解決方案 (特別是 Pod 共同排程) 進行比較。雖然這兩種解決方案在多副本服務方面的效能相當,但我們最終選擇了容器層級方法,用於最簡可行產品 (MVP)。這項決策是基於容器層級解決方案在異質共同託管方面提供的卓越彈性,讓開發人員能透過精細的軟體定義記憶體分區,並排提供不同的模型架構,不受基礎 Kubernetes 排程限制。此外,容器層級的自動化調度管理可加快疊代速度,也更容易自訂和創新。
干擾測試:共同託管不同模型
原型設計的最後一個里程碑是「干擾測試」,我們在同一個 VM 上共同託管 Gemma-3n-E2B-it 和 Llama-3.1-8B-Instruct。每個模型都分配到 0.4 個 GPU 記憶體分區,因此提供效能幾乎與單一模型基準測試相同。舉例來說,Gemma-3n 在共同託管環境中的要求數為 30.21,而在隔離環境中則為 30.96。這些結果證實,只要適當分割記憶體資源,避免 KV 快取耗盡,即使在流量龐大的情況下,共同託管的模型之間也幾乎不會發生運算干擾。
MVP 容器導入
為了從經過驗證的基準測試,轉換為可部署於正式環境的系統,我們必須設計強大的容器化自動調度管理工具。這個開發階段著重於建構高階軟體層,以便管理多個模型生命週期的複雜性,同時確保確定性資源隔離。
模型共同託管伺服器設計
實作的核心是 model_cohost_server,這是自訂進入點,旨在做為容器內的主要協調器。這款伺服器與標準單一程序模型不同,採用子程序管理,可同時執行多個獨立的模型伺服器執行個體 (例如 vLLM),做為獨立子程序。為管理傳入流量,自動調度管理工具會採用高階要求轉送功能,透過 --served-model-name 等引數,依據專屬模型 ID 識別要求,並將要求導向對應的內部伺服器執行個體。除了轉送之外,伺服器還提供全面的生命週期自動調度管理,管理所有共同託管執行個體的初始化、健康狀態監控和終止。這種集中管理方式可為外部流量提供單一、統一的端點,同時維持每個子程序的獨立作業界線。
GPU 資源分區:確定性切片
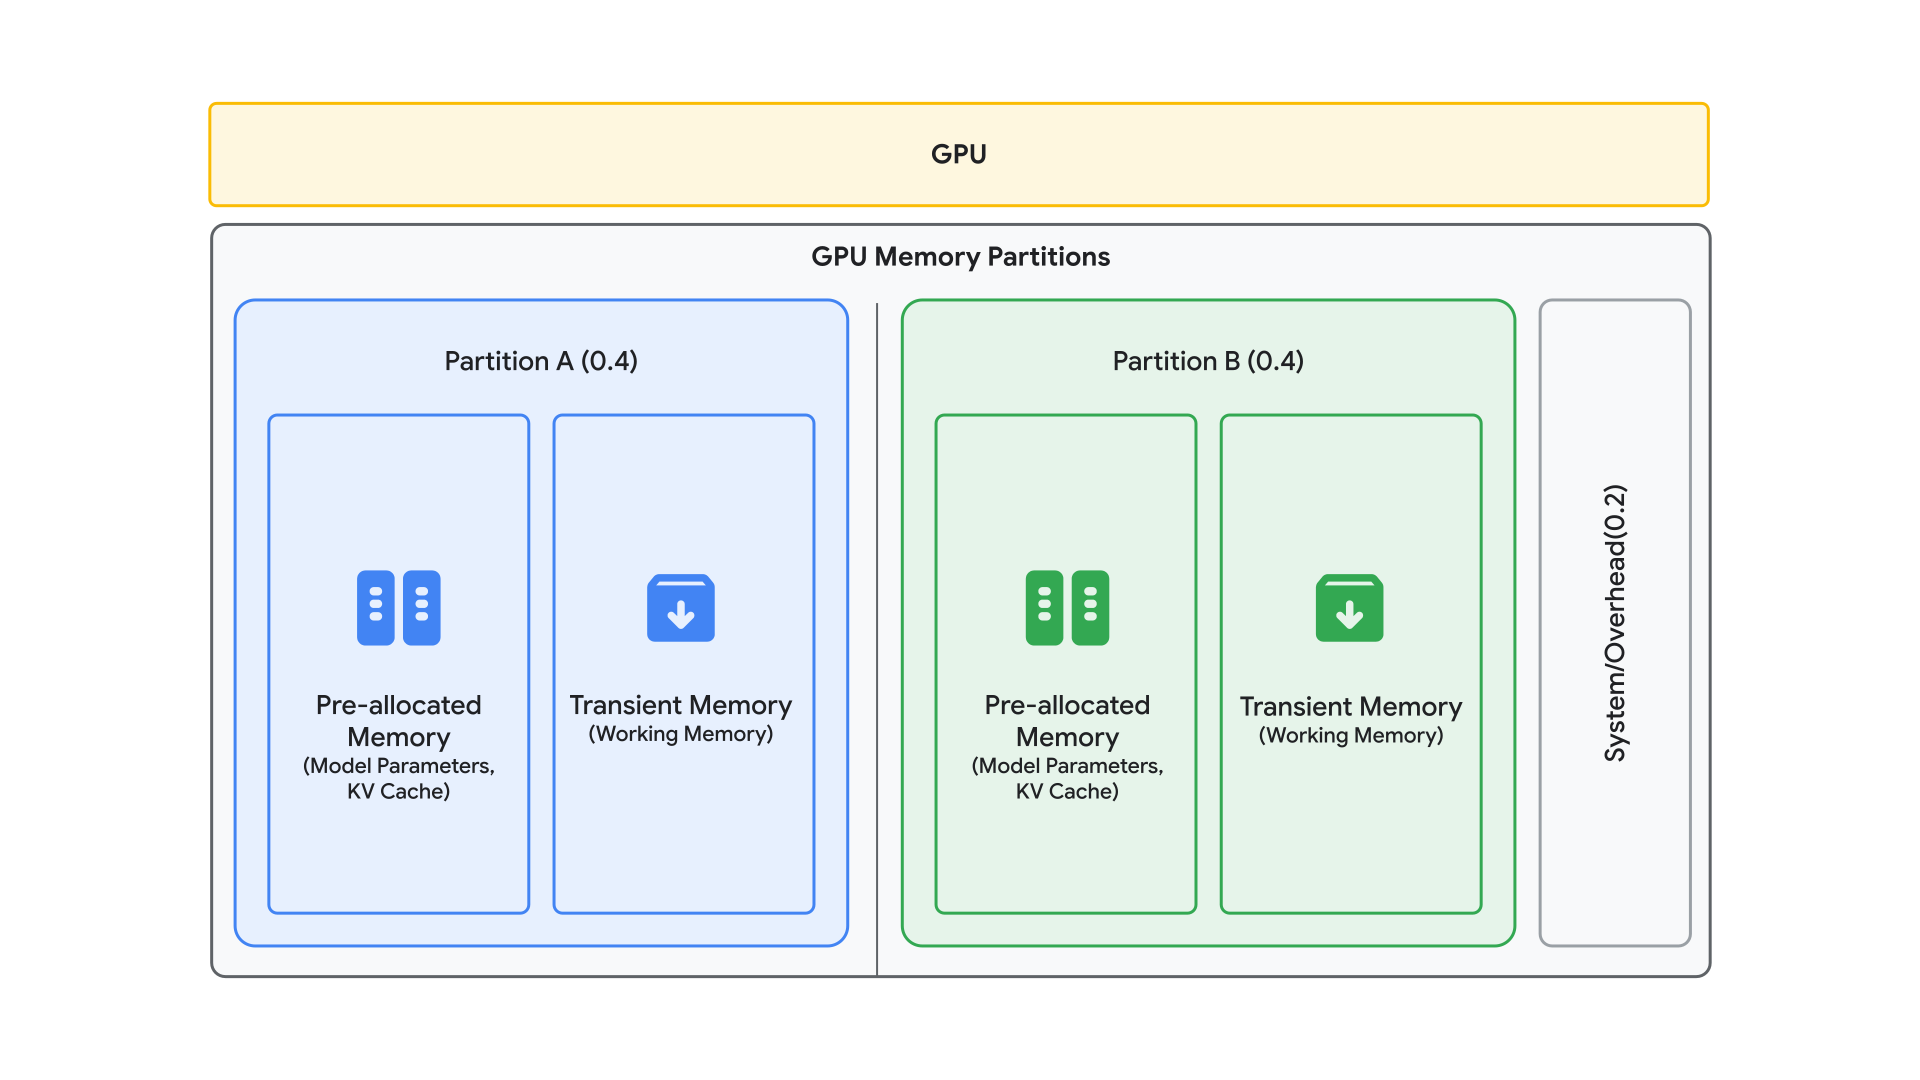
為避免單一模型的運算工作負載,在共同託管環境中觸發記憶體不足 (OOM) 錯誤,我們實施了嚴格的資源切片機制。這項功能是透過 gpu-memory-partition 引數實作,開發人員可以定義明確的記憶體比率 (例如 0.4、0.4),為每個模型執行個體保留節點 GPU 記憶體總量的固定百分比。
為引導這項分配,我們採用「預先分配與暫時」記憶體模型,區分靜態和動態資源需求。「預先分配」的記憶體包含用於模型權重和 KV 快取的記憶體。模型權重使用的記憶體量取決於模型的參數數量和精確度。舉例來說,BF16 中的 8B 參數模型需要約 16 GB 的靜態儲存空間。KV 快取使用的記憶體量取決於模型維度、精確度、脈絡長度和序列數量。「暫時」記憶體包含中間運算和推論工作記憶體。gpu-memory-partition 引數會計入「預先分配」的記憶體。建議將 gpu-memory-partition 的總和設為小於 1.0,為「暫時」記憶體保留緩衝空間。
產品化
在 Vertex AI 共同託管模型的產品化階段,我們致力於為單一模型多副本和多模型提供設定,建立流暢、可部署於正式環境的環境。這項轉變有效地將實證基準測試結果,轉化為簡化的部署工作流程,以及深度整合的基礎架構支援結構。
簡化部署工作流程
為了降低高密度服務的進入門檻,我們使用自訂容器引數標準化共同託管設定,這些引數與現有的 Vertex AI API 原生整合。針對 8x H100 節點等全形狀虛擬機器,我們開發了基準測試公用程式,可根據您的特定用途自訂最佳配方。這些基準測試公用程式可協助您找出設定,根據模型的特定參數數量和精確度,自動平衡張量平行處理 (TP)、管道平行處理 (PP) 和模型執行個體數量。此外,Deployment API 也提供強大支援,開發人員可以直接在標準 deployModel 要求中指定這些精細參數 (包括確切的 GPU 記憶體分區),並部署模型。
動態提供多模型
我們在技術發展歷程中的一項重大進展,是從靜態設定轉換為動態服務架構。這項功能對於流量模式快速變化的正式環境至關重要,因為不必完全重新啟動容器,就能載入或卸載模型,是維持基礎架構靈活性和高可用性的關鍵。
Dynamic Update API (update_models)
為解決不可變動部署作業的固有侷限,我們在 Vertex Gemini Enterprise Agent Platform Model Garden vLLM 模型共同託管容器中,導入了專門的模型更新 API。這個 API 可協助熱重新載入,讓伺服器根據儲存在 Cloud Storage bucket 中的集中式設定檔,即時調整託管模型組合。
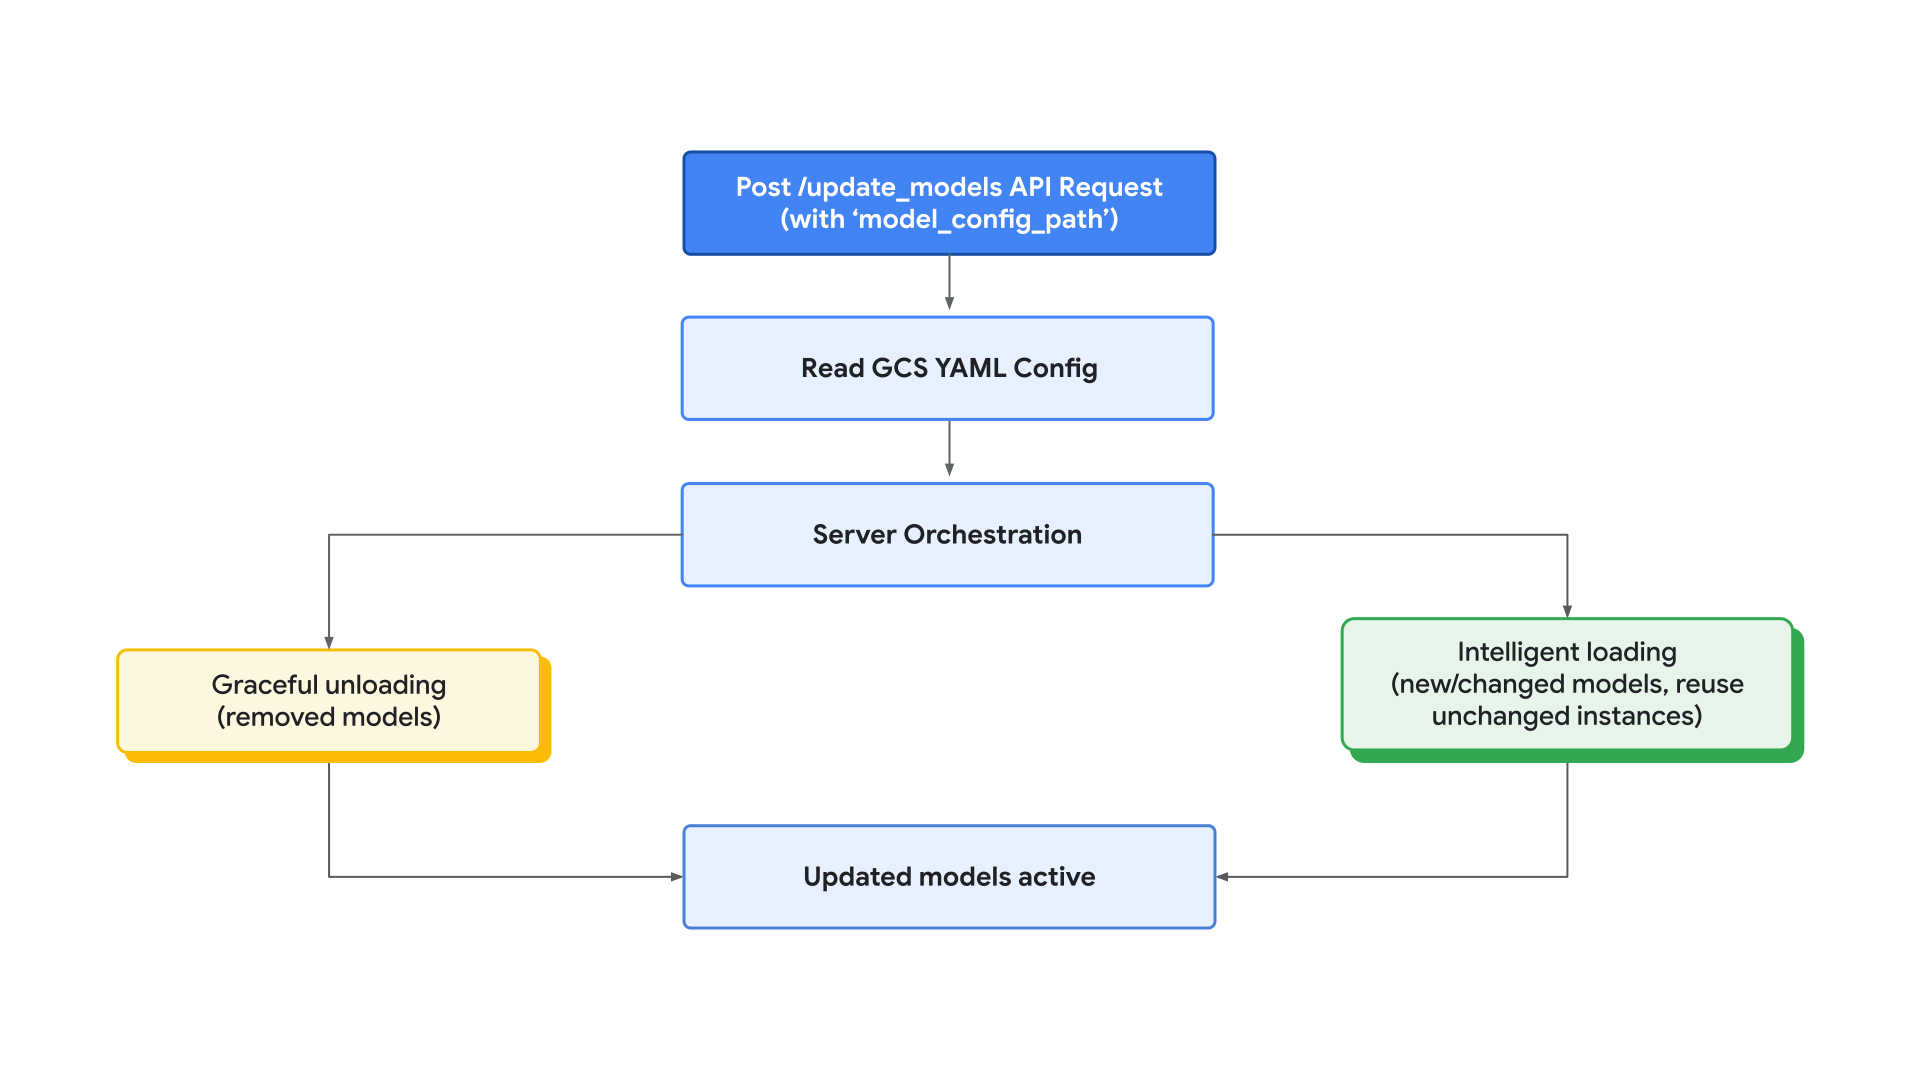
更新程序會透過向 update_models 端點發出 POST 要求來啟動,其中包含指向 Cloud Storage YAML 檔案的 model_config_path。收到這項要求後,伺服器會執行多級式自動化調度管理序列,盡可能縮短停機時間:
- 正常卸載:系統會找出新設定中缺少的模型,並先終止其子程序,立即回收 GPU 記憶體和運算資源。
- 智慧載入和重複使用:伺服器會初始化新的模型執行個體。重要的是,如果模型的平行處理設定 (例如張量平行處理 (TP) 或管道平行處理 (PP)) 和分配的記憶體分區保持不變,自動調度管理工具就會重複使用現有的執行個體。這項最佳化功能可略過成本高昂的重新初始化階段,確保設定變更期間,運作中的服務不會中斷。
延遲時間和效能分析
根據這些更新策略的實證分析,動態熱重新載入可大幅降低大規模 LLM 服務常見的「冷啟動」效能損耗。
結論
Vertex AI 的模型共同託管功能代表根本性的典範轉移,從僵化、硬體繁重的單體式部署,轉變為流暢且有效率的服務架構。只要從「一個 VM 一個模型」的標準,演進為高密度運算集區模型,組織就能大幅降低總持有成本 (TCO),同時維持 (通常還能提升) 效能基準。
我們的工程歷程和廣泛的多模型基準研究,為這個架構建立了一套明確的正式環境指南:
- 沒有一體適用的設定。我們主張針對特定用途 (模型、硬體、流量) 找出最佳服務方案,並建構相關工具。
- 使用副本調度處理量。
- 打破硬體界限,以更精細的方式分割記憶體,提高資源使用率。
如要成功導入共同託管架構,建議採用下列技術工作流程:
- 明確分區:使用
--gpu-memory-partitions引數,為個別模型分配記憶體資源。 - 反覆基準測試:使用提供的基準測試公用程式,找出工作負載的特定「並行交叉點」,也就是執行個體數量、TP 和 PP 的「最佳」設定。
在 Google Cloud Model Garden 實作共同託管,可提供可擴充的藍圖,用於建構高密度 AI 應用程式。建議開發人員探索這些功能,並使用提供的教學筆記本重現我們的基準,根據特定企業需求最佳化服務設定。
感謝閱讀
歡迎與我們分享您對 Vertex AI 的意見和問題。
特別銘謝
我們想向 Google Cloud Vertex AI 團隊表達誠摯謝意。特別感謝 Bo Wu 和 Ting Yu 的領導和指導,以及 Deborah He、Shawn Ma、Desmond Liu、Yang Pan、Surya K G Tangatur 和 Luis Rizo 在整個專案中的寶貴貢獻。