


强化学习是一种强大的技术,可用于调整大语言模型 (LLM),以最大限度地提高用户定义的奖励函数提供的反馈奖励。模型会探索许多可能的答案,观察每个答案的数值奖励,并逐渐调整其行为,使高奖励答案的可能性更高,低奖励答案的可能性更低。这种方法非常适合需要多步推理、复杂决策或理解提示中细微差别的场景。
借助 Gemini 的强化学习微调功能,您可以使用自己的提示和自定义奖励函数来微调 Gemini。您可以使用它来提升 Gemini 模型的推理能力和输出质量,以满足您自己的应用场景和 Agentic Workflows 的需求。
工作原理
强化学习微调以迭代方式运行,以优化 LLM 的行为。在每次迭代期间,模型都会生成对一组提示的回答。然后,系统会通过用户定义的奖励函数评估这些回答,该函数会根据您的目标标准量化生成输出的质量。该服务使用此奖励信号通过强化学习算法更新模型的参数,以鼓励产生更高奖励的行为。通过生成、评估和参数更新的迭代过程,模型可以适应您的特定应用场景。
下图展示了强化学习微调的整体工作流:
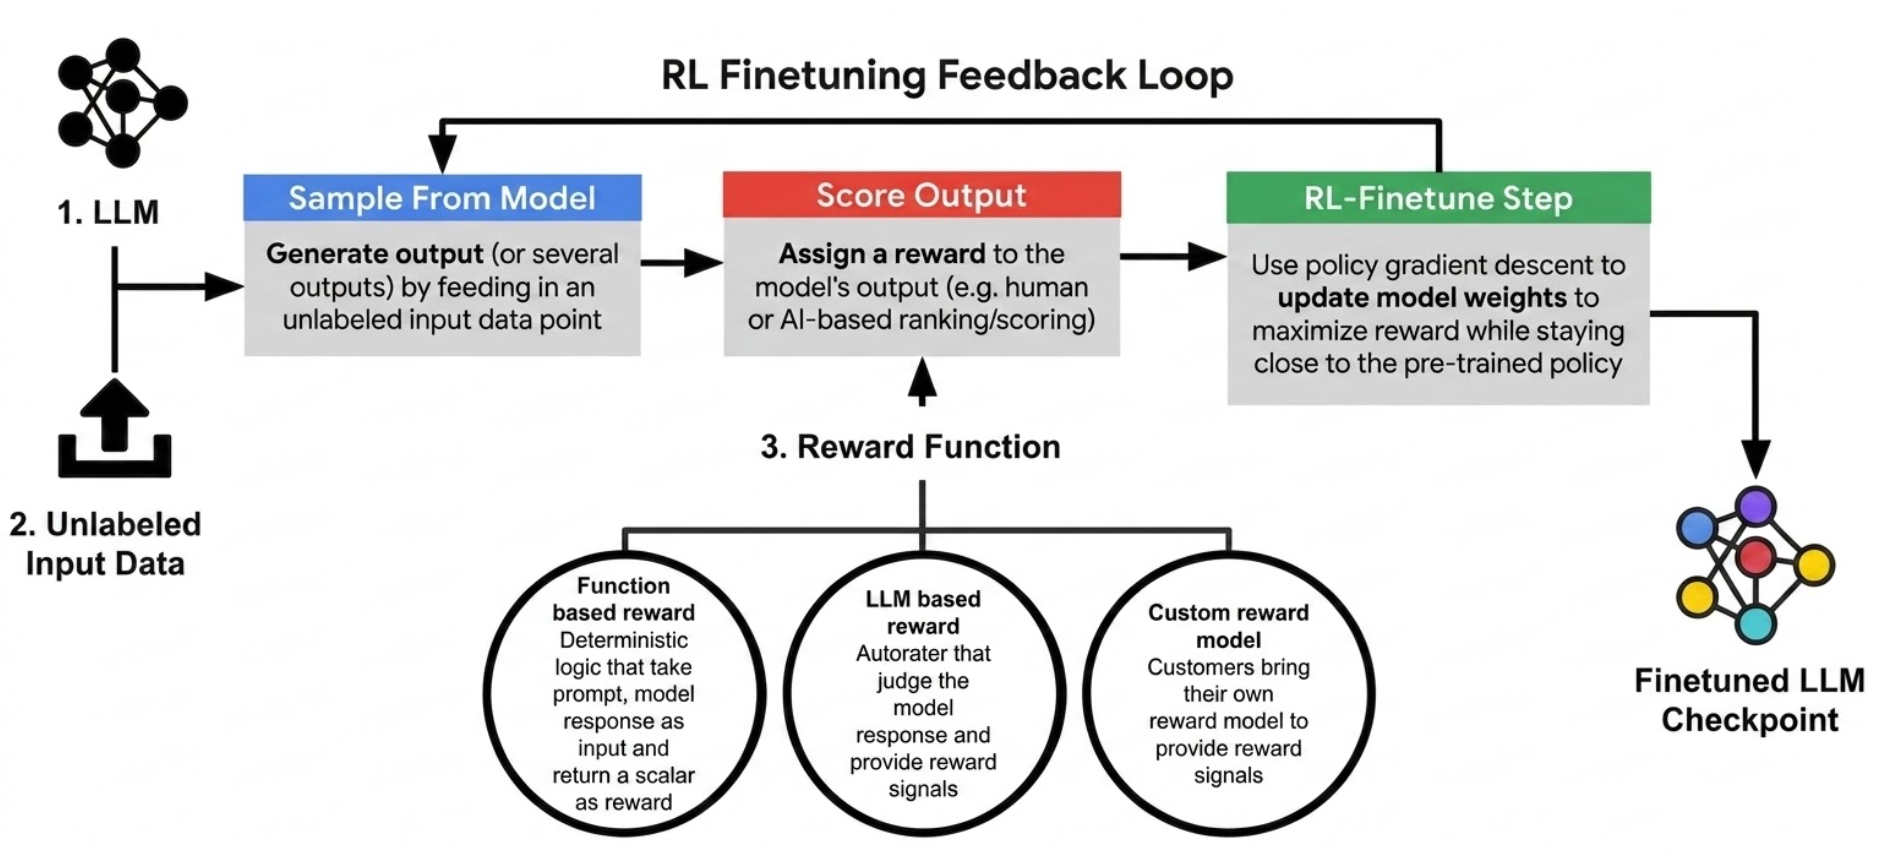
主要特性
强化学习微调包括以下主要功能:
可自定义的奖励函数:定义您自己的奖励函数,以便针对各种自定义用例进行精确优化,并使模型的行为与特定目标保持一致。如需详细了解支持的奖励类型,请参阅奖励函数页面。
用于高效调优的适配器:强化学习微调使用适配器,可在重复使用现有服务基础架构的同时实现有效调整。
多种思考水平:该服务支持在两种思考水平(
MINIMAL和HIGH[动态思考])下进行调优,因此您可以选择最适合您的优化目标和目标回答生成模式的方法。如需了解详情,请参阅超参数页面。持续调优:通过添加更多训练样本或周期,进一步优化之前调优过的模型。使用现有的已调优模型或检查点作为基础,可以更高效地进行调优实验。如需了解详情,请参阅持续调优页面。
多模态数据集:支持文本、图片、视频(仅限 Gemini 3.5 Flash)和音频数据模态。
何时使用强化学习微调
在通过监督学习无法明显确定最佳策略的情况下,强化学习微调是微调 LLM 的首选。这包括以下任务:目标是优化特定指标,但没有现成的标准答案标签;与人类偏好保持一致至关重要(且存在判断方法);以及需要大量推理、可从迭代改进和探索中受益的任务。
以下是一些首选强化学习微调的场景:
遵循复杂指令:当模型需要遵循复杂指令时,其中“正确”的输出不是单个答案,而是需要一组检查。强化学习可以调整模型,使其能够处理这些复杂的指令集。
创意内容生成:适用于生成创意写作、诗歌或高度专业化代码等难以定义客观指标的任务。强化学习通过精心设计的奖励函数(可能涉及人类反馈或专家评估),可以引导模型生成更有效、更具创新性的输出。
推理任务:对于需要大量推理的任务(例如解决字谜或数学问题),强化学习可以激励模型探索不同的推理序列,以确定哪些模式在解决问题方面最有效。
支持的模型和区域
以下 Gemini 模型支持强化学习微调:
Gemini 3.5 Flash
| 规范 | 值 |
|---|---|
| 支持模型调优的端点 |
|
| 支持调优模型部署的端点 |
|
| API 版本 | 仅限 v1beta1 |
Gemini 3.1 Flash-Lite
| 规范 | 值 |
|---|---|
| 支持模型调优的端点 |
|
| 支持调优模型部署的端点 |
|
| API 版本 | 仅限 v1beta1 |
支持的调优模态
强化学习微调支持调优数据集中的以下数据模态:
- 文本
- 音频
- 映像
- 视频(仅 Gemini 3.5 Flash 支持)
如需了解每种模态的数据集限制(例如每个提示的文件数量上限、文件大小上限和总长度上限),请参阅调优数据集页面。
持续调优
您可以使用先前调优作业的输出作为新强化学习微调作业的基础。支持以下持续调优模式:
- 监督式微调 → 强化学习微调
- 强化学习微调 → 强化学习微调
如需了解配置详情,请参阅持续调优页面。
应用经过调优的模型
在基础 Gemini 模型上成功完成强化学习微调作业后,系统会将基于最后一个检查点的调优模型部署到项目中的端点。调优后的模型使用与基础模型相同的服务端点策略。例如,如果您在 us-central1 中运行调优作业,则调优后的模型会部署到 us 多区域端点 (mREP)。
如需在 Google Cloud 控制台中或使用 API 检索已部署的调优模型端点并对其运行推理,请参阅 Google Cloud 控制台快速入门或 API 快速入门。
价格
调优价格
Gemini 的强化学习微调分两个阶段生成 token:采样阶段和训练阶段。训练阶段生成的 token 将根据 Gemini Enterprise Agent Platform 价格页面的“模型调优”部分收费。
推理价格
调优完毕后,调优后模型的推理(预测请求)仍然会产生费用。对于 Gemini 3 及更高版本模型,调优后的模型端点的预测价格是基本模型价格的 1.5 倍。如需了解详情,请参阅可用的 Gemini 稳定模型版本。
如果您将 Gen AI Evaluation Service 配置为在调优期间自动运行,则评估会按批量预测作业收费。如需了解详情,请参阅 Agent Platform 价格页面的“模型调优”部分。
后续步骤
- 按照Google Cloud 控制台快速入门或 API 快速入门创建您的第一个强化学习微调作业。
- 了解如何准备调优数据集和配置奖励函数。
- 了解如何部署调优后的 Gemini 模型。