


強化學習是一項強大的技術,可調整大型語言模型 (LLM),盡可能提高使用者定義獎勵函式提供的獎勵。模型會探索多種可能答案,觀察各答案的數值獎勵,並逐步調整行為,提高獲得高獎勵答案的機率,降低獲得低獎勵答案的機率。這種方法適合需要多步驟推論、複雜決策或理解提示細微差異的情境。
Gemini 的強化學習微調功能可讓您使用自己的提示和自訂獎勵函式微調 Gemini。您可以運用這項功能,提升 Gemini 模型的推論能力和輸出品質,以因應自己的用途和 Agentic Workflows。
運作方式
強化學習微調會反覆運作,精進 LLM 的行為。在每次疊代中,模型會針對一組提示詞生成回覆。接著,系統會依據使用者定義的回饋函式評估這些回覆,根據指定條件量化生成輸出的品質。這項服務會使用這個獎勵信號,透過強化學習演算法更新模型參數,鼓勵能獲得更高獎勵的行為。透過生成、評估和參數更新的疊代程序,模型就能適應特定用途。
下圖顯示強化學習微調的整體工作流程:
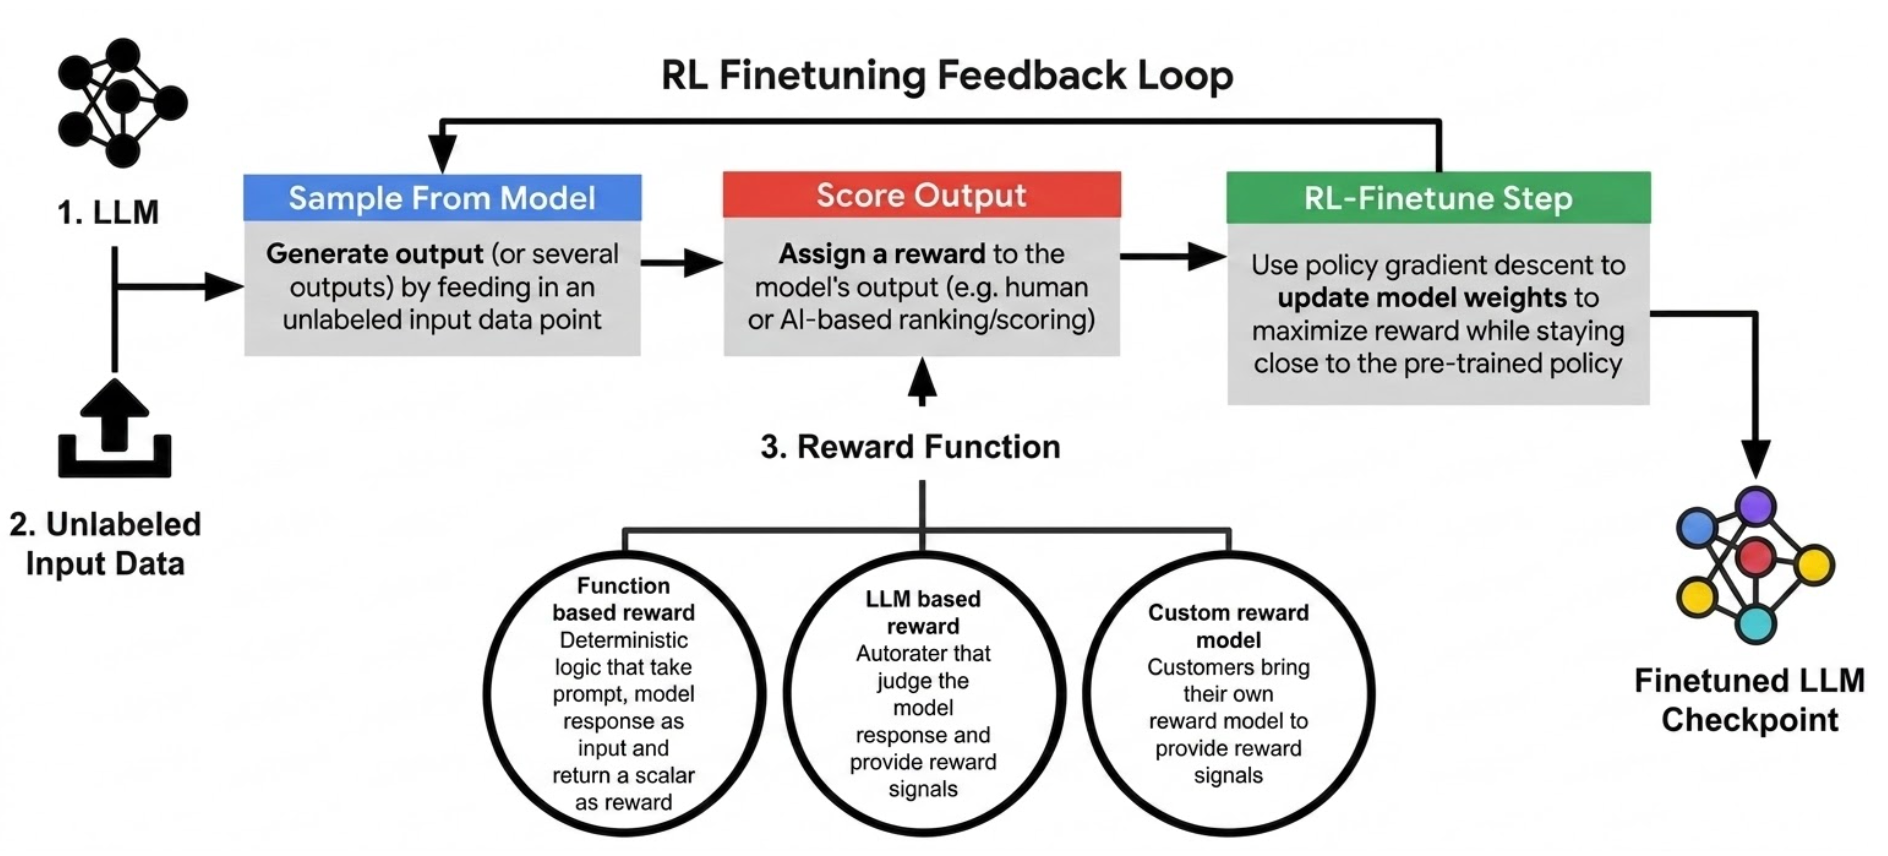
主要功能與特色
強化學習微調包含下列主要功能:
可自訂獎勵函式:定義自己的獎勵函式,精準最佳化各種自訂用途,並根據特定目標調整模型行為。如要進一步瞭解支援的獎勵類型,請參閱「獎勵函式」頁面。
用於高效調整的轉接器:強化學習微調會使用轉接器,在重複使用現有服務基礎架構的同時,有效調整模型。
多種思考程度:這項服務支援兩種思考程度的調整:
MINIMAL和HIGH(動態思考),您可以根據最佳化目標和目標回覆生成模式,選擇最合適的方法。詳情請參閱「超參數」頁面。持續調整:加入更多訓練樣本或訓練週期,進一步調整先前調整過的模型。使用現有的調整模型或檢查點做為基礎,可提高調整實驗的效率。詳情請參閱「持續調整」頁面。
多模態資料集:支援文字、圖片、影片 (僅限 Gemini 3.5 Flash) 和音訊資料模態。
強化學習微調的使用時機
如果無法透過監督式學習,找出最佳策略,建議使用強化學習微調 LLM。這包括:目標是最佳化特定指標,但沒有現成的真值標籤;與人類偏好一致至關重要 (且有判斷方法);以及需要大量推理,且能從反覆改進和探索中受益的工作。
以下是適合使用強化學習微調的情境:
複雜指令遵循:模型需要遵循複雜指令,且「正確」輸出內容並非單一答案,而是需要一系列檢查。強化學習可調整模型,以便處理這些複雜的指令集。
生成創意內容:適用於生成創意寫作、詩歌或高度專業程式碼等難以定義客觀指標的工作。透過精心設計的獎勵函式 (可能涉及人類意見回饋或專家評估) 進行增強學習,可引導模型產生更有效、更創新的輸出內容。
推論工作:對於需要大量推論的工作 (例如解字謎或數學問題),強化學習可以鼓勵模型探索不同的推論序列,找出最能有效解決問題的模式。
支援的模型和區域
下列 Gemini 模型支援強化學習微調:
Gemini 3.5 Flash
| 規格 | 值 |
|---|---|
| 支援的模型調整端點 |
|
| 支援提供調整後模型的端點 |
|
| API 版本 | 僅限 v1beta1 |
Gemini 3.1 Flash-Lite
| 規格 | 值 |
|---|---|
| 支援的模型調整端點 |
|
| 支援提供調整後模型的端點 |
|
| API 版本 | 僅限 v1beta1 |
支援的調整模態
強化學習微調支援調整資料集中的下列資料模態:
- 文字
- 音訊
- 圖片
- 影片 (僅支援 Gemini 3.5 Flash)
如要瞭解各模態的資料集限制 (例如每個提示的檔案數量上限、檔案大小上限和總長度上限),請參閱「調整資料集」頁面。
持續調整
您可以使用先前調整工作的輸出內容,做為新強化學習微調工作的基礎。支援下列連續微調模式:
- 監督式微調 → 強化學習微調
- 強化學習微調 → 強化學習微調
如需設定詳細資料,請參閱「持續調整」頁面。
提供調整後的模型
成功對基礎 Gemini 模型執行強化學習微調工作後,系統會根據最後一個檢查點,將調整後的模型部署至專案中的端點。微調模型採用的服務端點策略與基礎模型相同。舉例來說,如果您在 us-central1 執行調整工作,調整後的模型會部署至 us 多區域端點 (mREP)。
如要在 Google Cloud 控制台或使用 API 擷取已部署的調整後模型端點,並對其執行推論,請參閱Google Cloud 控制台快速入門導覽課程或 API 快速入門導覽課程。
定價
微調定價
Gemini 的強化學習微調功能會分兩個階段生成詞元:取樣階段和訓練階段。訓練階段生成的詞元,會依 Gemini Enterprise Agent Platform 定價頁面的「模型調整」部分計費。
推論定價
調整後,調整後的模型仍會產生推論 (預測要求) 費用。如果是 Gemini 3 以上版本,微調模型端點的預測價格是基礎模型的 1.5 倍。詳情請參閱「可用的 Gemini 穩定模型版本」。
如果將 Gen AI Evaluation Service 設為在調整期間自動執行,評估作業會以批次預測工作的形式計費。詳情請參閱 Agent Platform 定價頁面的「模型調整」一節。
後續步驟
- 請按照Google Cloud 控制台快速入門導覽課程或 API 快速入門導覽課程,建立第一個強化學習微調工作。
- 瞭解如何準備調整資料集及設定獎勵函式。
- 瞭解如何部署調整後的 Gemini 模型。