


本頁面提供模型監控總覽。
監控總覽
您可以視需要或定期執行 Model Monitoring 工作,追蹤表格模型的品質。如果您設定了快訊,Model Monitoring 會在指標超過指定門檻時通知您。
舉例來說,假設您有一個預測顧客終身價值的模型。隨著顧客習慣改變,預測顧客支出的因素也會改變。因此,您先前用來訓練模型的特徵和特徵值,可能不適用於目前的推論。這種資料偏差稱為「偏移」。
Model Monitoring 可追蹤偏差,並在偏差超過指定門檻時發出快訊。接著,您可以重新評估或重新訓練模型,確保模型運作符合預期。
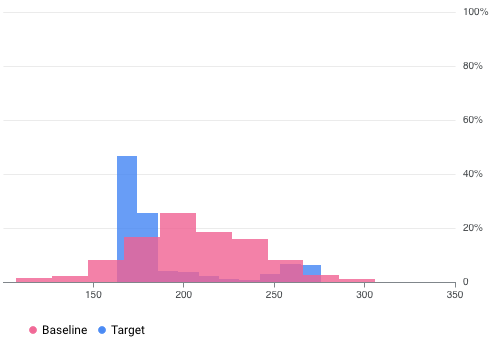
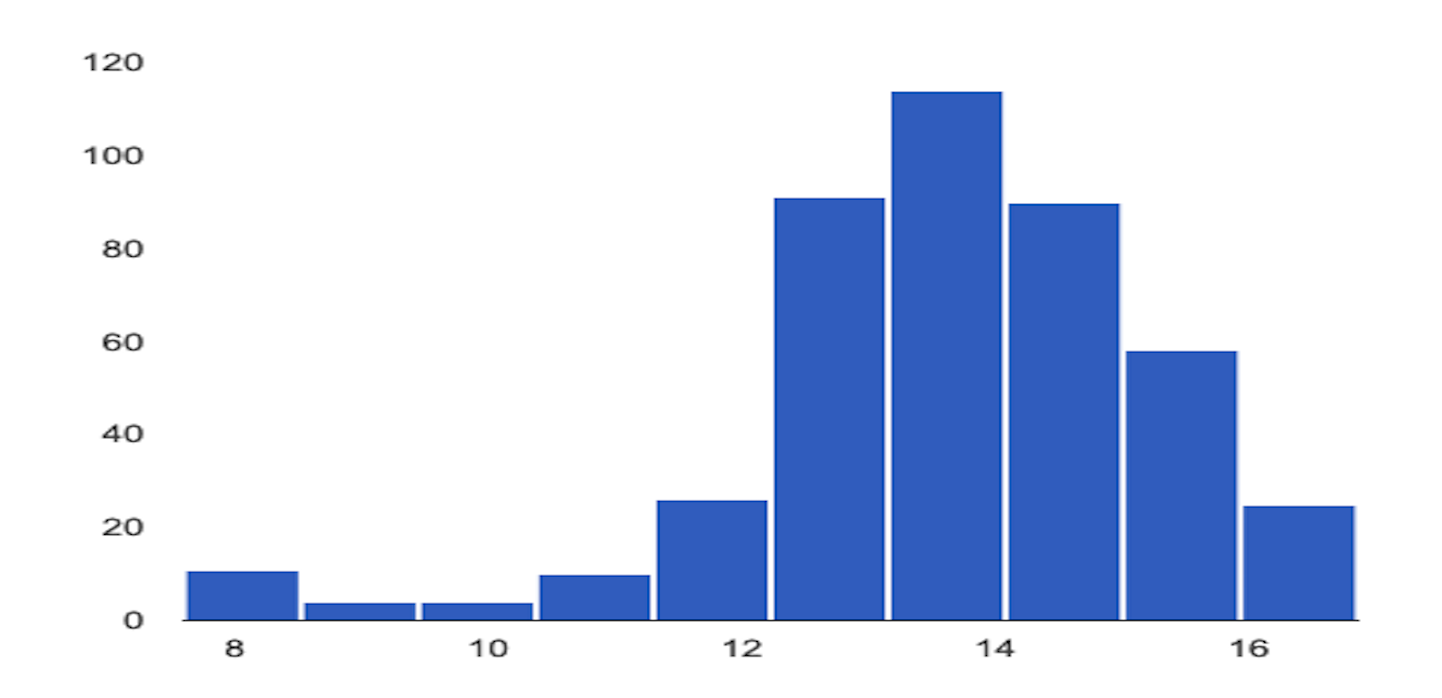
舉例來說,Model Monitoring 可提供如下圖所示的圖表,其中疊加了兩個資料集的圖表。這項圖表可讓您快速比較兩組資料,並查看兩者之間的偏差。
Model Monitoring 版本
Model Monitoring 提供兩個版本:v2 和 v1。
Model Monitoring v2 目前處於預先發布版階段,是最新推出的產品,可將所有監控工作與模型版本建立關聯。相較之下,Model Monitoring 第 1 版已正式發布,並在 Gemini Enterprise Agent Platform 端點上設定。
如果您需要正式環境層級的支援,並想監控部署在 Agent Platform 端點的模型,請使用 Model Monitoring 第 1 版。如果是其他用途,請使用 Model Monitoring v2,這項服務提供 Model Monitoring v1 的所有功能,以及更多其他功能。如要瞭解詳情,請參閱各版本的總覽:
對於現有的 Model Monitoring v1 使用者,Model Monitoring v1 會維持原樣,您不必遷移至 Model Monitoring v2。如要遷移,您可以同時使用這兩個版本,直到完全遷移至 Model Monitoring v2,避免在轉換期間出現監控落差。
Model Monitoring v2 總覽
設定模型監控並執行監控工作後,Model Monitoring v2 可讓您追蹤一段時間內的指標。您可以執行隨選監控工作,或設定排定的執行作業。使用排定執行作業時,Model Monitoring 會根據您定義的時間表,自動執行監控工作。
監控目標
您監控的指標和門檻會對應至監控目標。您可以為每個模型版本指定一或多個監控目標。下表詳細列出各項目標:
| 目標 | 說明 | 特徵資料類型 | 支援的指標 |
|---|---|---|---|
| 輸入特徵資料偏移 |
評估輸入特徵值的分布情形 (與基準資料分布情形相比)。 |
類別:布林值、字串、類別 |
|
| 數值:浮點數、整數 | Jensen-Shannon 散度 | ||
| 推論輸出資料偏移 |
評估模型的推論資料分布情形,並與基準資料分布情形比較。 |
類別:布林值、字串、類別 |
|
| 數值:浮點數、整數 | Jensen-Shannon 散度 | ||
| 特徵歸因 |
與基準相比,評估特徵對模型推論的貢獻變化。舉例來說,您可以追蹤某項重要特徵的重要性是否突然下降。 |
所有資料類型 | SHAP 值 (SHapley Additive exPlanations) |
輸入特徵和推論輸出內容偏移
模型部署至正式環境後,輸入資料可能會與用於訓練模型的資料不同,或正式環境中的特徵資料分布情形可能會隨時間大幅變動。Model Monitoring v2 可監控正式環境資料分布與訓練資料的差異,或追蹤正式環境資料分布隨時間的變化。
同樣地,Model Monitoring v2 也能監控推論資料,瞭解預測結果分布情形與訓練資料或實際工作環境資料分布情形的變化。
特徵歸因
特徵歸因會指出模型中各項特徵對每個指定執行個體推論的影響程度。歸因分數與特徵對模型推論的貢獻度成正比。通常會帶正負號,表示特徵會提高或降低推論結果。所有特徵的歸因總和必須等於模型的推論分數。
Model Monitoring v2 會監控特徵歸因,追蹤特徵對模型推論的貢獻變化。如果主要特徵的歸因分數發生變化,通常表示特徵已發生變化,可能會影響模型推論的準確度。
如要進一步瞭解特徵歸因和指標,請參閱「以特徵為基礎的說明」和「取樣 Shapley 方法」。
如何設定 Model Monitoring v2
您必須先在 Model Registry 註冊模型,如果是在 Agent Platform 以外提供模型,則不必上傳模型構件。接著,您會建立模型監控器,並與模型版本建立關聯,然後定義模型結構定義。部分模型 (例如 AutoML 模型) 會提供結構定義。
在模型監控中,您可以視需要指定預設設定,例如監控目標、訓練資料集、監控輸出位置和通知設定。詳情請參閱「設定模型監控」。
建立模型監控器後,您可以視需要執行監控工作,或排定定期工作,持續監控模型。執行工作時,除非您提供其他監控設定,否則 Model Monitoring 會使用模型監控器中設定的預設設定。舉例來說,如果您提供不同的監控目標或比較資料集,Model Monitoring 會使用工作的設定,而非模型監控器的預設設定。詳情請參閱「執行監控工作」。
定價
預先發布版期間,使用 Model Monitoring v2 不會產生費用。不過,使用其他服務仍須付費,例如 Cloud Storage、BigQuery、Agent Platform 批次推論、Agent Platform 可解釋 AI 和 Cloud Logging。
Notebook 教學課程
下列教學課程說明如何使用 Agent Platform SDK for Python,為模型設定 Model Monitoring v2。
Model Monitoring v2:自訂模型批次推論工作
Model Monitoring v2:自訂模型線上推論
Model Monitoring v2:Gemini Enterprise Agent Platform 以外的模型
Model Monitoring v1 總覽
為協助您維持模型效能,Model Monitoring 第 1 版會監控模型的推論輸入資料,偵測特徵偏差和偏移情形:
當正式環境和模型訓練作業的特徵資料分布情況不同時,就會發生訓練/應用偏差。如果有原始訓練資料,可以啟用偏差偵測功能,監控模型是否出現訓練/應用偏差情形。
當正式環境的特徵資料分布隨時間大幅變動時,就會發生推論偏移。如果沒有原始訓練資料,可以啟用偏移偵測功能,監控輸入資料的變化趨勢。
您可以同時啟用偏差和偏移偵測功能。
Model Monitoring v1 支援類別和數值特徵的特徵偏移和特徵偏移偵測:
「類別」特徵是可能值數量有限的資料,通常會依質性屬性分組。例如產品類型、國家/地區或顧客類型等類別。
數值特徵是任何數值資料,例如體重和身高。
如果模型特徵的偏差或偏移超過您設定的警告門檻,Model Monitoring v1 就會傳送電子郵件快訊給您。您也可以查看各項特徵在一段時間內的分布情形,評估是否需要重新訓練模型。
計算偏移
如要偵測第 1 版的偏移,模型監控功能會使用 TensorFlow Data Validation (TFDV) 計算分布和距離分數。
計算基準統計分布:
如要偵測偏移,基準是訓練資料中特徵值的統計分布。
如果是偏移偵測,基準則是過去在實際工作環境中觀察到的特徵值統計分布。
類別和數值特徵的分佈計算方式如下:
如果是類別特徵,計算出的分布情形是特徵每個可能值的例項數量或百分比。
如果是數值特徵,Model Monitoring 會將可能特徵值的範圍劃分為等距區間,並計算落在各區間的特徵值數量或百分比。
基準會在您建立模型監控工作時計算,只有在您更新工作的訓練資料集時,才會重新計算。
計算實際工作環境中最新特徵值的統計分布。
計算距離分數,比較正式環境中最新特徵值的分布與基準分布:
如果是類別特徵,則會使用 L-infinity 距離計算距離分數。
如果是數值特徵,則會使用 Jensen-Shannon 散度計算距離分數。
如果兩個統計分布之間的距離分數超過指定門檻,Model Monitoring 會將異常狀況判定為偏移或偏離。
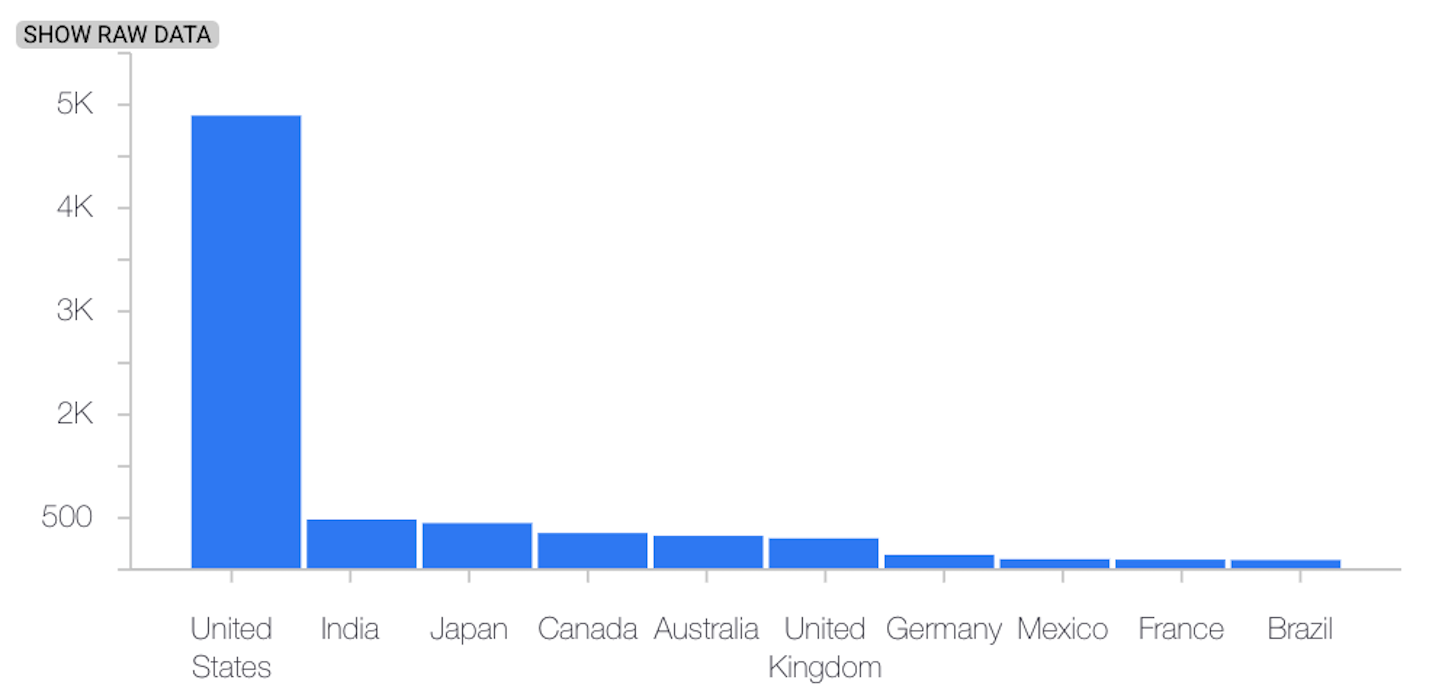
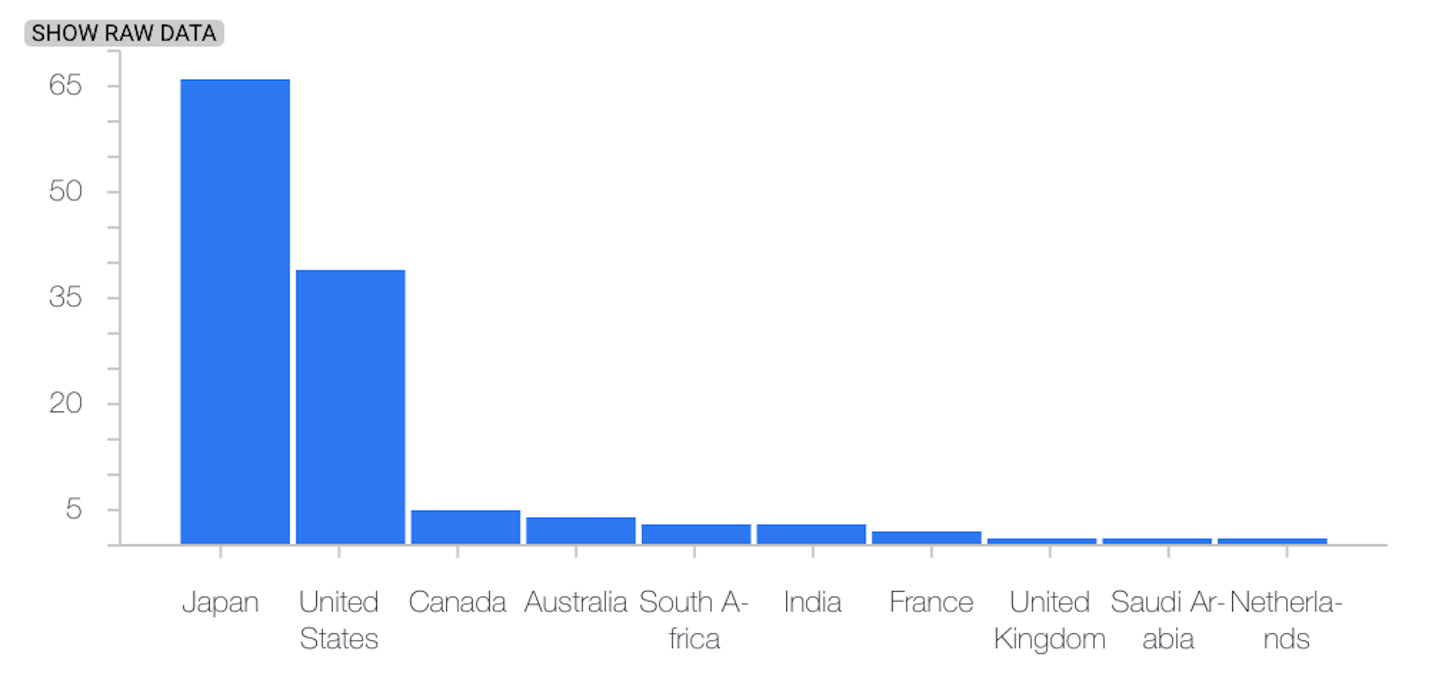
以下範例顯示類別特徵的基準和最新分布之間有偏差或偏移:
基準分布
最新發布
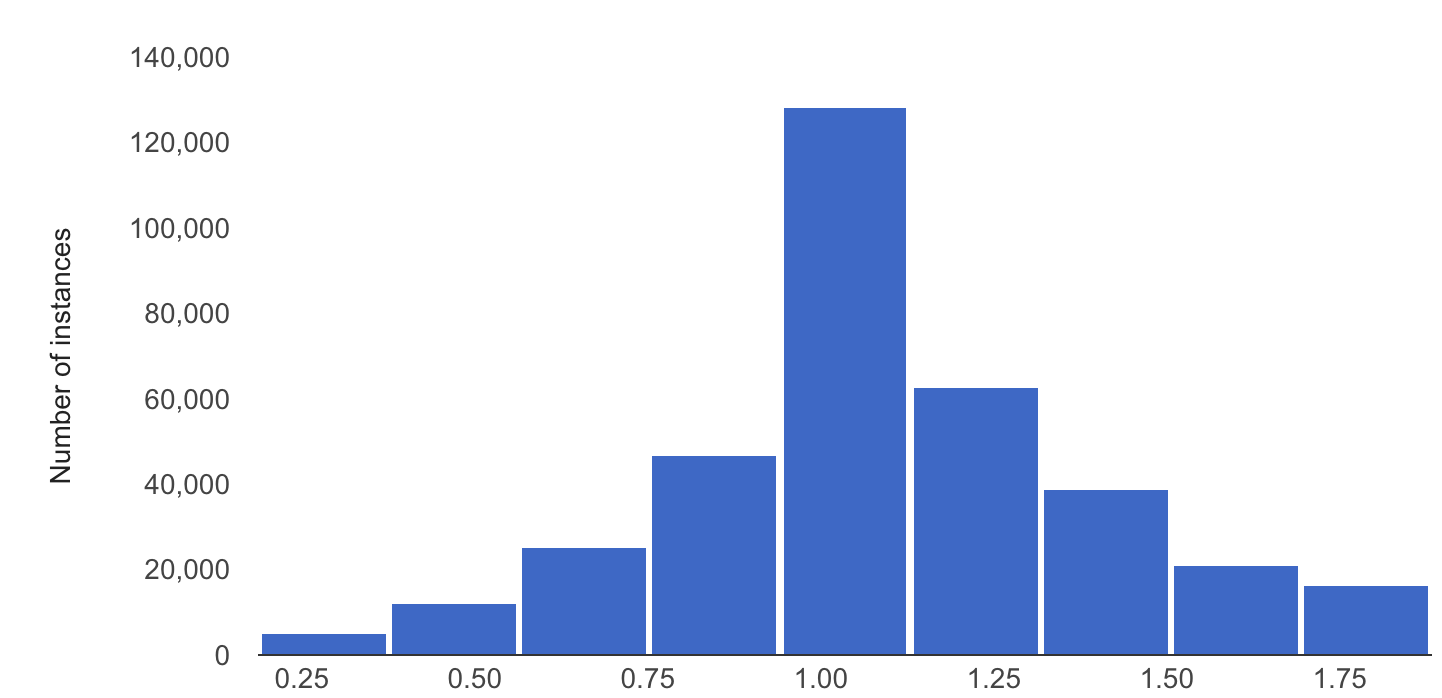
以下範例顯示數值特徵的基準和最新分布之間有偏差或偏移:
基準分布
最新發布
使用 Model Monitoring 的注意事項
為提高成本效益,您可以設定推論要求取樣率,監控模型的部分實際工作環境輸入內容。
您可以設定頻率,監控已部署模型最近記錄的輸入內容,檢查是否有偏誤或偏移。監控頻率會決定每次監控執行作業分析的記錄資料時間範圍,或監控時間範圍大小。
您可以為要監控的每項特徵指定警告門檻。如果輸入特徵分布情形與對應基準之間的統計距離超過指定門檻,系統就會記錄警告。根據預設,系統會監控每個類別和數值特徵,門檻值為 0.3。
線上推論端點可以託管多個模型。在端點啟用偏差或偏移偵測功能時,該端點託管的所有模型會共用下列設定參數:
- 偵測類型
- 監控頻率
- 受監控的輸入要求比例
至於其他設定參數,您可以為每個模型設定不同的值。