


本文档提供了一个参考架构,可用于通过 Vector Search 设计具有检索增强生成 (RAG) 功能的生成式 AI 应用的基础设施。Vector Search 是一项全托管式 Google Cloud 服务,可为超大规模向量相似度匹配提供经过优化的服务基础设施。
本文档的目标受众群体包括生成式 AI 应用的架构师、开发者和管理员。本文档假定您对 AI、机器学习 (ML) 和大语言模型 (LLM) 概念具有基本的了解。本文档未提供有关如何设计和开发生成式 AI 应用的指导。
架构
下图简要展示了本文档介绍的架构:
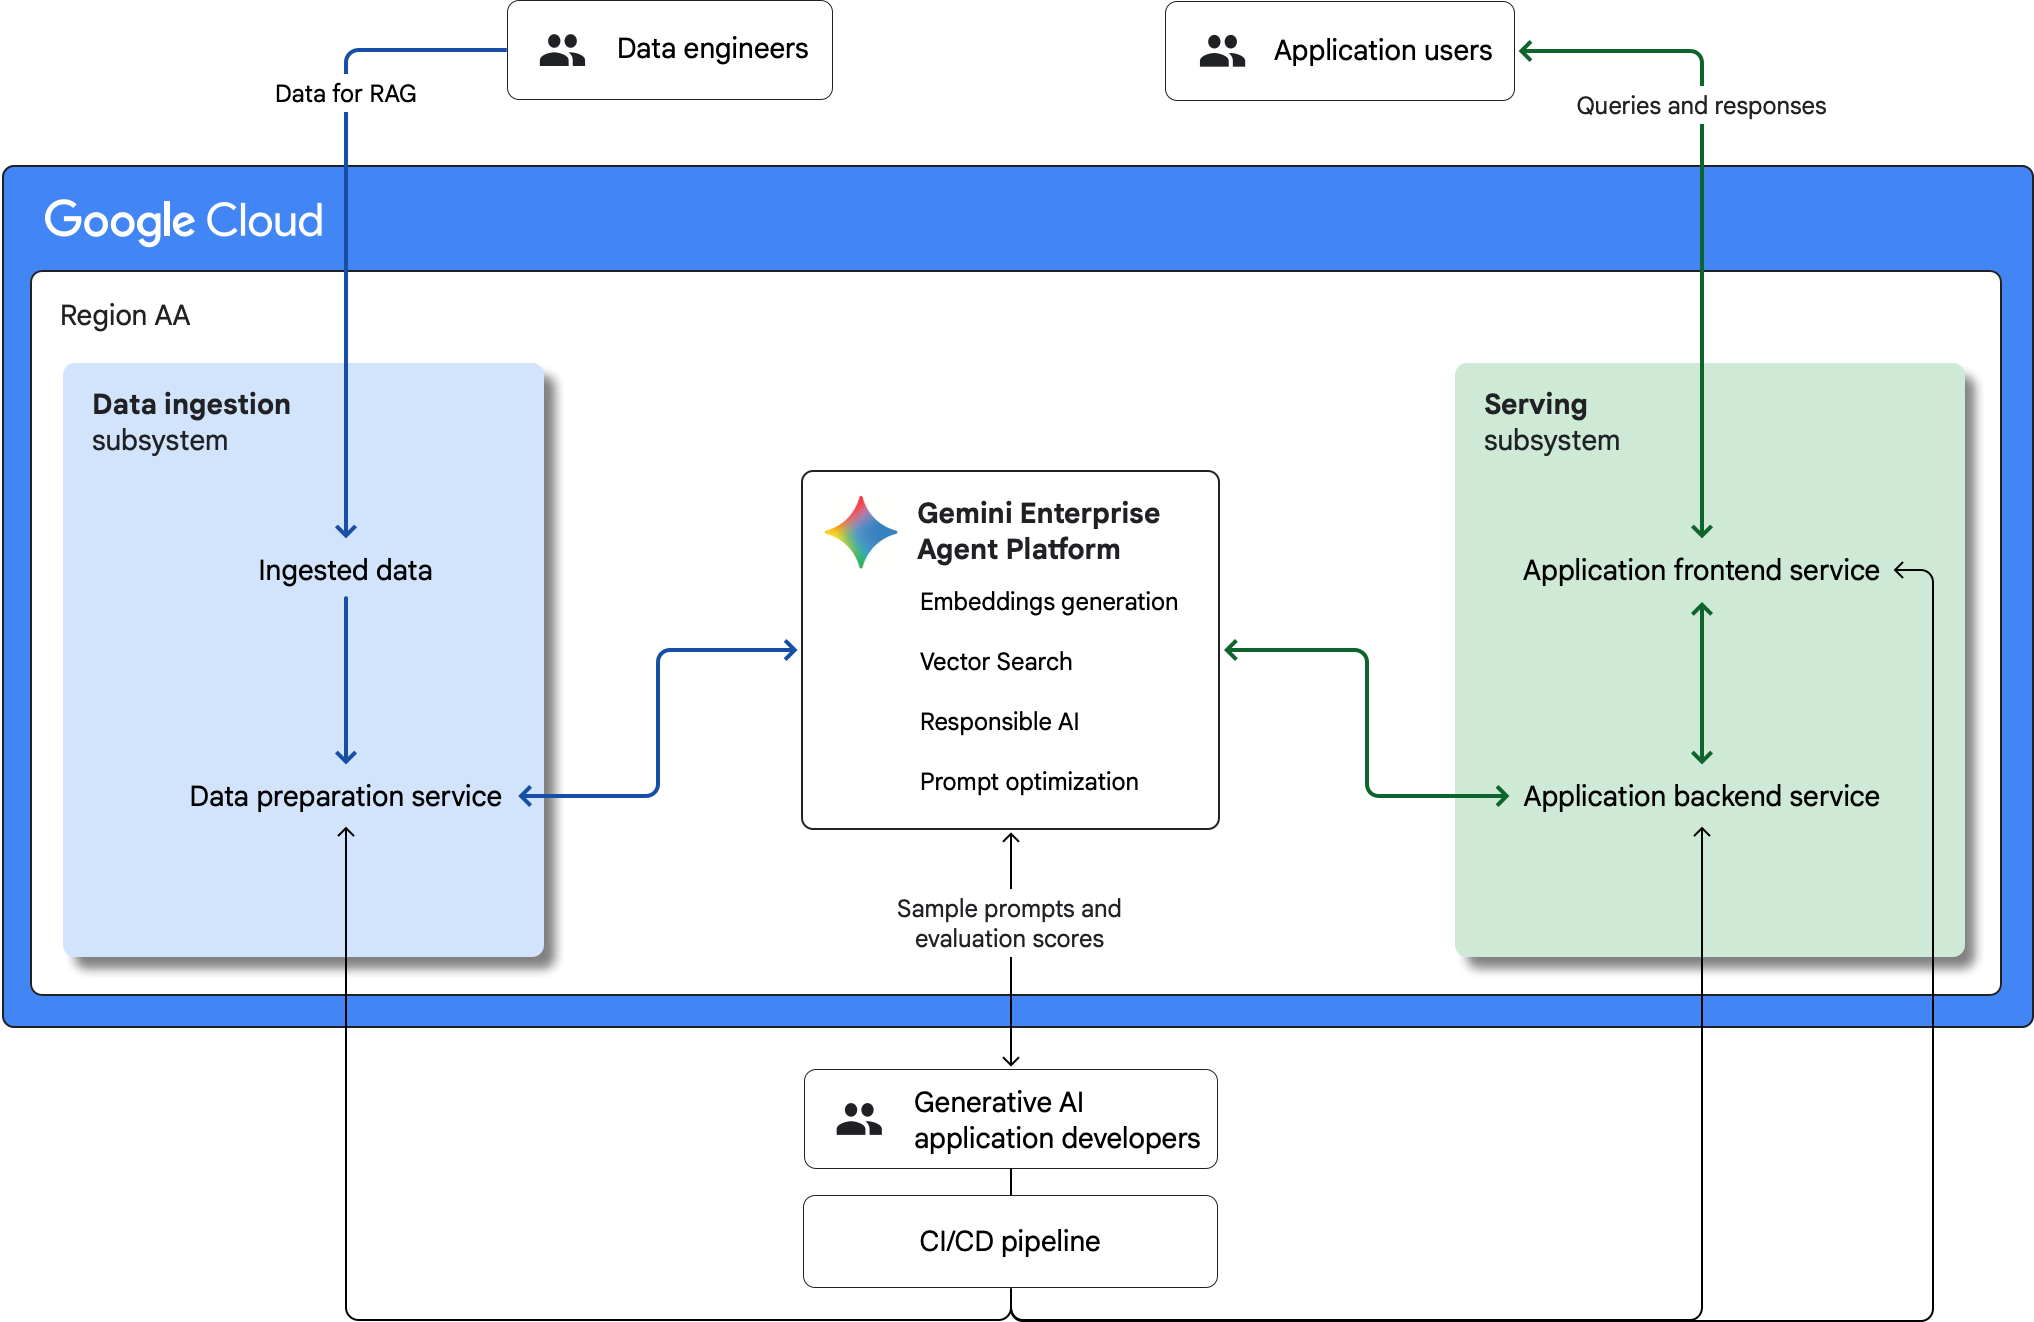
上图中的架构包含两个子系统:数据注入和服务。
- 数据注入子系统会注入从外部来源上传的数据。该子系统会为 RAG 准备数据,并与 Gemini Enterprise Agent Platform 交互,以便为注入的数据生成嵌入,并构建和更新向量索引。
- 服务子系统包含生成式 AI 应用的前端和后端服务。
- 前端服务处理与应用用户的查询-响应流,并将查询转发到后端服务。
- 后端服务使用 Agent Platform 生成查询嵌入、执行向量相似度搜索,并应用Responsible AI 安全过滤器和系统指令。
下图展示了此架构的详细视图:
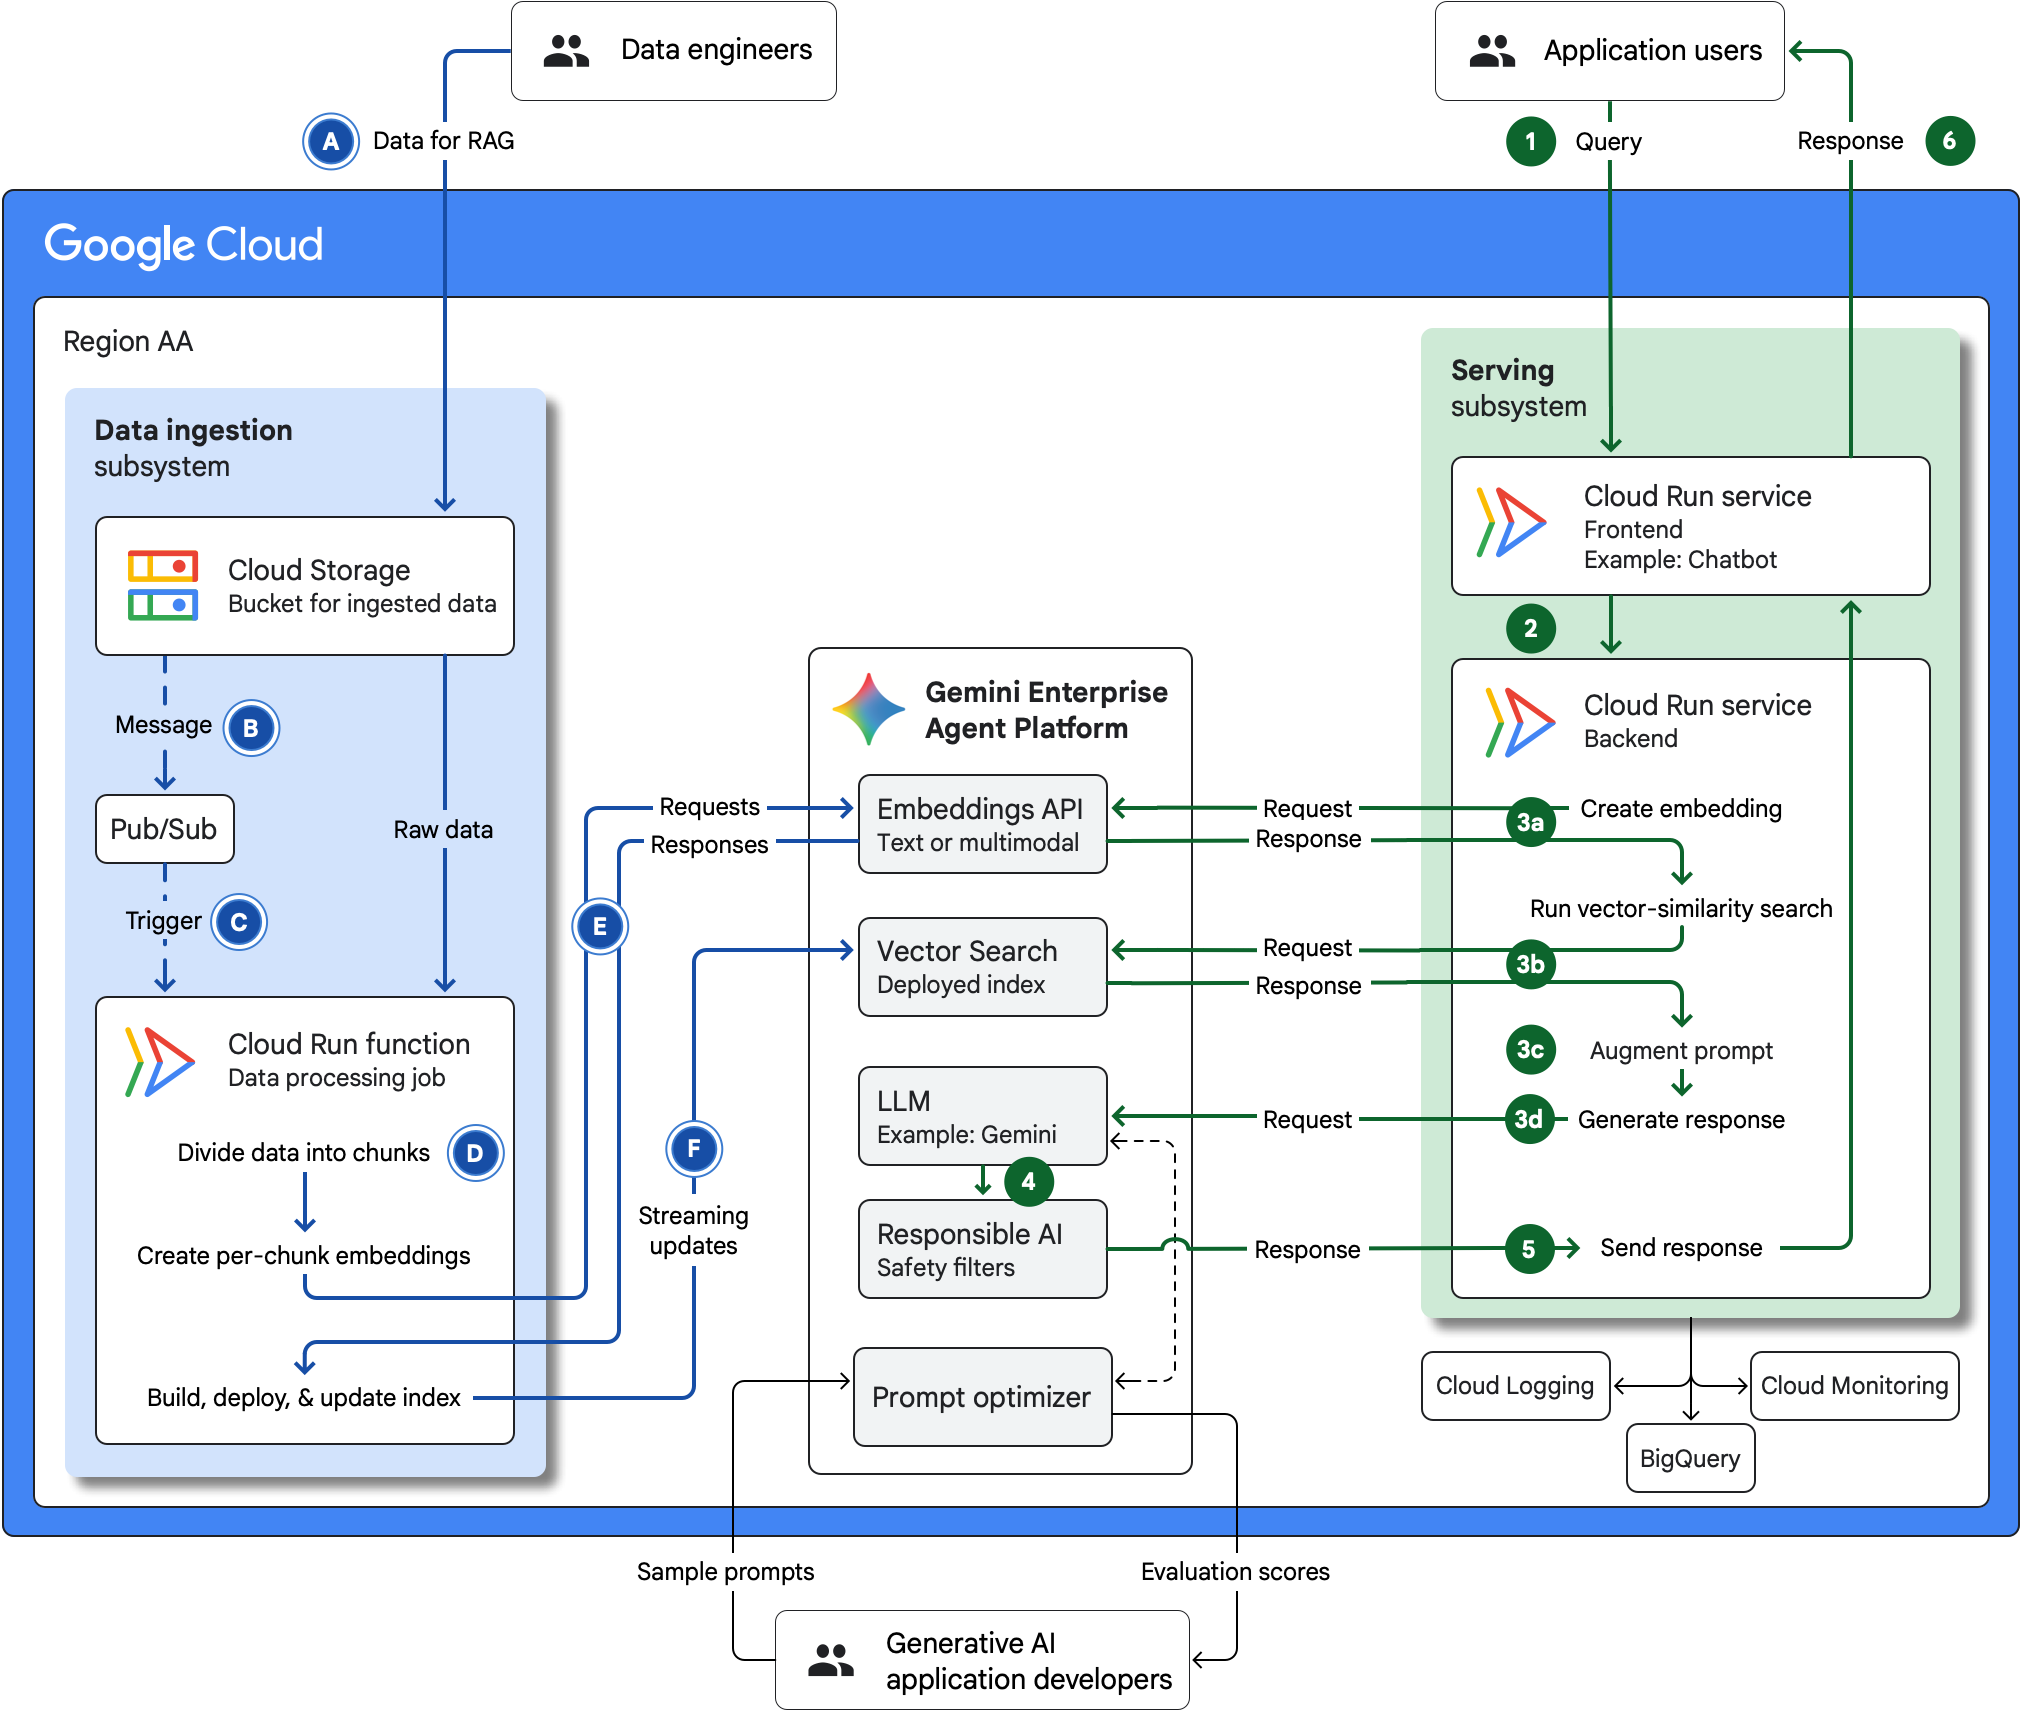
以下部分介绍了上述架构图中每个子系统内的数据流。
数据注入子系统
数据注入子系统从外部来源注入数据,并为 RAG 准备数据。以下是数据注入和准备流程中的步骤:
- 数据会从外部来源上传到 Cloud Storage 存储桶。外部来源可能是应用、数据库或在线媒体服务。
- 将数据上传到 Cloud Storage 后,系统会向 Pub/Sub 主题发布消息。
- 当 Pub/Sub 主题收到消息时,它会触发 Cloud Run 函数。
- Cloud Run 函数会解析原始数据,根据需要设置其格式,并将其分成多个分块。
- 该函数使用 Agent Platform Embeddings API,通过您指定的嵌入模型创建分块的嵌入。Agent Platform 支持文本和多模态嵌入模型。
- 然后,该函数会构建嵌入的 Vector Search 索引,并部署该索引。
当系统注入新数据时,会针对新数据执行上述步骤,并使用流式更新来更新索引。
当服务子系统处理用户请求时,它会使用 Vector Search 搜索索引进行向量相似度搜索。下一部分将介绍服务流程。
服务子系统
服务子系统处理生成式 AI 应用与其用户之间的查询-响应流。以下是服务流程中的步骤:
- 用户向 Cloud Run 服务提交自然语言查询,该服务为生成式 AI 应用提供前端界面(例如聊天机器人)。
- 前端服务会将用户查询转发到后端 Cloud Run 服务。
-
后端服务通过执行以下操作来处理查询:
- 使用数据注入子系统用于生成注入数据的嵌入的相同嵌入模型和参数,将查询转换为嵌入。
- 通过对 Vector Search 索引中的查询嵌入执行向量相似度搜索,检索相关的接地数据。
- 通过将原始查询与接地数据相结合,构建增强提示。
- 将增强后的提示发送到部署在 Agent Platform 上的 LLM。
- LLM 会生成响应。
- 对于每个提示,Agent Platform 都会应用您配置的 Responsible AI 安全过滤条件,然后将过滤后的回答和 AI 安全得分发送到 Cloud Run 后端服务。
- 应用通过 Cloud Run 前端服务将回答发送给用户。
您可以在 Cloud Logging 中存储和查看查询-响应活动的日志,并且可以使用 Cloud Monitoring 设置基于日志的监控。您还可以将生成的响应加载到 BigQuery 中,以进行离线分析。
Agent Platform 提示优化器可帮助您在初始提示设计和持续提示调优期间大规模改进提示。提示优化器会评估模型对机器学习工程师提供的一组示例提示的回答。评估输出包括模型对示例提示的回答、机器学习工程师指定的指标的分数,以及一组可供您考虑使用的优化系统指令。
使用的产品
此参考架构使用以下 Google Cloud 产品:
- Gemini Enterprise Agent Platform:一个综合性平台,可让您构建、扩缩、治理和优化企业级 AI 智能体。
- Vector Search:向量相似度匹配服务,可让您存储、编入索引和搜索语义相似或相关的数据。
- Cloud Run:一个无服务器计算平台,可让您直接在 Google 可伸缩的基础设施之上运行容器。
- Cloud Run functions:一个无服务器计算平台,可让您直接在 Google Cloud中运行单一用途函数。
- Cloud Storage:适用于各种数据类型的费用低廉且不受限制的对象存储区。数据可从 Google Cloud内部和外部访问,并且跨位置进行复制以实现冗余。
- Pub/Sub:一种异步且可伸缩的通讯服务,可将生成消息的服务与处理这些消息的服务分离开。
- Cloud Logging:具有存储、搜索、分析和提醒功能的实时日志管理系统。
- Cloud Monitoring:可帮助您了解您的应用和基础设施的性能、可用性和健康状况的服务。
- BigQuery:一种企业数据仓库,可帮助您使用机器学习、地理空间分析和商业智能等内置功能管理和分析数据。
使用场景
RAG 是一种可提高从 LLM 生成的输出质量的有效技术。本部分提供可使用支持 RAG 的生成式 AI 应用的应用场景示例。
个性化产品推荐
在线购物网站可能会使用由 LLM 提供支持的聊天机器人来帮助客户查找产品或获取与购物相关的帮助。可以使用有关用户购买行为和网站互动模式的历史数据来增强用户提出的问题。数据可能包括存储在非结构化数据存储区中的用户评价和反馈,或存储在网站分析数据仓库中的搜索相关指标。然后,LLM 可以处理增强的问题,以生成个性化回复,用户可能认为这些回复更具吸引力和说服力。
临床辅助系统
医院中的医生需要快速分析和诊断患者的健康状况,从而做出有关适当的护理和药物的决策。使用 Med-PaLM 等医疗 LLM 的生成式 AI 应用可用于辅助医生完成临床诊断过程。应用生成的响应可以基于患者历史记录,具体方法是将医生的提示与来自医院电子健康记录 (EHR) 数据库或外部知识库(例如 PubMed)的数据结合在一起。
高效的法律研究
借助由生成式 AI 提供支持的法律研究,律师可以快速查询大量法规和判例法,以确定相关的法律先例或总结复杂的法律概念。可以使用从律师事务所专有的合同语料库、过往法律沟通和内部案例记录中检索到的数据来增强律师的提示,从而改进此类研究的输出结果。这种设计方法可确保生成的响应与律师专门从事的法律领域相关。
设计替代方案
本部分介绍了您可以在 Google Cloud中为支持 RAG 的生成式 AI 应用考虑的其他设计方法。
替代 RAG 架构
本文档中的架构使用 Agent Platform 和 Vector Search 为大规模向量相似度匹配提供无服务器 RAG 流水线。如果您需要代理驱动的编排、共置的关系型和向量数据,或自行管理的开源模型,请考虑以下替代架构:
使用 Gemini Enterprise 和 Agent Platform 的生成式 AI 的 RAG 基础架构:一种智能体驱动型架构,可为需要实时数据可用性和丰富上下文搜索的企业应用编排端到端 RAG 数据流。
使用 Agent Platform 和 AlloyDB for PostgreSQL 为生成式 AI 构建 RAG 基础设施:一种将向量嵌入与运营数据一起存储在全代管式数据库中的架构。
使用 GKE 和 Cloud SQL 的生成式 AI 的 RAG 基础设施:一种灵活的基于容器的架构,可提供最大程度的控制,以便使用 Ray、Hugging Face 和 LangChain 等开源工具构建自定义应用。
应用托管方案
本文档中的架构使用 Cloud Run 作为生成式 AI 应用和数据处理的主机。Cloud Run 是一个以开发者为中心的全代管式应用平台。如果您需要更高的配置灵活性和对计算基础架构的控制,可以将应用部署到 Google Kubernetes Engine (GKE) 集群或 Compute Engine 虚拟机。
无论是决定使用 Cloud Run、GKE 还是 Compute Engine 作为应用主机,都需要在配置灵活性和管理工作量之间作出权衡取舍。借助无服务器 Cloud Run 选项,您可以将应用部署到极少需要管理的预配置环境。使用 Compute Engine 虚拟机和 GKE 容器时,您需要负责管理底层计算资源,但您拥有更大的配置灵活性和控制力。如需详细了解如何选择适当的应用托管服务,请参阅以下文档:
设计考虑事项
本部分介绍了一些设计因素、最佳实践和设计建议,您在使用此参考架构开发满足特定安全性、可靠性、费用和性能要求的拓扑时应考虑这些内容。
本部分中的指导并非详尽无遗。根据应用的具体要求以及您使用的 Google Cloud 和第三方产品和功能,您可能还需要考虑其他设计因素和权衡因素。
安全性、合规性和隐私权
本部分介绍了在 Google Cloud 中设计满足工作负载安全性和合规性要求的拓扑时的设计注意事项和建议。
Agent Platform 安全注意事项
为确保您的 Agent Platform 配置和使用符合您的安全要求,请考虑以下建议:
- 安全控制措施:Agent Platform 支持 Google Cloud 安全控制措施,可用于满足数据驻留、数据加密、网络安全和访问透明性的要求。如需了解详情,请参阅机器学习服务的安全控制措施和生成式 AI 的安全控制措施。
- 模型访问权限:您可以设置组织政策,以限制可在 Google Cloud 项目中使用的 LLM 的类型和版本。如需了解详情,请参阅控制对 Model Garden 模型的访问权限。
- 责任共担:Agent Platform 可保护底层基础架构,并提供工具和安全控制措施,帮助您保护数据、代码和模型。如需了解详情,请参阅 Agent Platform 责任共担。
- 数据保护:使用 Cloud Data Loss Prevention API 发现提示、回答和日志数据中的敏感数据(例如个人身份信息 [PII])并对其进行去标识化处理。如需了解详情,请参阅文本分类和隐去以及对文本内容中的敏感数据进行去标识化处理。
Cloud Run 安全注意事项
为确保您的 Cloud Run 实现满足安全要求,请考虑以下建议:
- 入站流量安全性(前端服务):为了控制对应用的外部访问权限,请停用前端 Cloud Run 服务的默认 run.app 应用网址,并设置区域级外部应用负载均衡器。除了对应用的传入流量进行负载均衡之外,负载均衡器还会处理 SSL 证书管理。为了增强保护,您可以使用 Google Cloud Armor 安全政策为服务提供请求过滤、DDoS 攻击防护和速率限制。
- 入站流量安全(后端服务):此架构中应用后端的 Cloud Run 服务不需要从互联网访问。为确保只有内部客户端可以访问该服务,请将
ingress参数设置为internal。如需了解详情,请参阅限制 Cloud Run 的网络入站流量。 - 数据加密:默认情况下,Cloud Run 使用 Google-owned and Google-managed encryption key加密数据。如需使用您控制的密钥保护容器,您可以使用客户管理的加密密钥 (CMEK)。如需了解详情,请参阅使用客户管理的加密密钥。
- 容器映像安全性:如需确保仅将获得授权的容器映像部署到 Cloud Run 服务,您可以使用 Binary Authorization。
- 数据驻留:Cloud Run 可帮助您满足数据驻留要求。Cloud Run 容器实例在您选择的区域内运行。
如需关于容器安全的更多指导,请参阅常规 Cloud Run 开发技巧。
Cloud Storage 安全注意事项
为确保您的 Cloud Storage 配置符合安全要求,请考虑以下建议:
- 数据加密:默认情况下,存储在 Cloud Storage 中的数据使用Google-owned and Google-managed encryption keys进行加密。如果需要,您可以使用 CMEK 或您自己的通过外部管理方法(如客户提供的加密密钥 [CSEK])管理的密钥。如需了解详情,请参阅数据加密选项。
- 访问权限控制:如需控制用户对 Cloud Storage 中存储桶和对象的访问权限,您可以使用 Identity and Access Management (IAM) 和访问权限控制列表 (ACL)。在大多数情况下,我们建议使用 IAM,这可让您在存储桶级和项目级授予权限。如需了解详情,请参阅访问权限控制概览。
- 数据保护:您通过 Cloud Storage 加载到数据注入子系统的数据可能包含敏感数据。如需保护此类数据,您可以使用 Sensitive Data Protection 来发现数据并对其进行分类以及去标识化处理。如需了解详情,请参阅将 Sensitive Data Protection 与 Cloud Storage 搭配使用。
- 网络控制:如需降低 Cloud Storage 中发生数据渗漏的风险,您可以使用 VPC Service Controls 创建服务边界。
- 数据驻留:Cloud Storage 可帮助您满足数据驻留要求。数据会在您指定的区域内存储或复制。
Pub/Sub 安全注意事项
为确保您的 Pub/Sub 配置符合安全要求,请考虑以下建议:
- 数据加密:默认情况下,Pub/Sub 使用Google-owned and Google-managed encryption keys对所有消息(包括静态消息和传输中的消息)进行加密。Pub/Sub 支持使用 CMEK 在应用层进行消息加密。如需了解详情,请参阅配置消息加密。
- 数据驻留:如果您有数据驻留要求,则可以通过配置消息存储政策来确保消息数据存储在特定位置。
Cloud Logging 安全注意事项
为确保您的 Cloud Logging 配置符合安全要求,请考虑以下设计因素和建议:
- 管理活动审核:默认情况下,系统会为此参考架构中使用的所有 Google Cloud 服务启用管理活动日志记录。您可以通过 Cloud Logging 访问日志,并使用日志来监控用于修改 Google Cloud 资源配置或元数据的 API 调用或其他操作。
数据访问审核:默认情况下,系统会为 BigQuery 启用数据访问事件日志记录。对于此架构中使用的其他服务,您可以启用数据访问审核日志。您可以使用这些日志监控以下内容:
- 用于读取资源配置或元数据的 API 调用。
- 用于创建、修改或读取用户所提供的资源数据的用户请求。
日志数据的安全性:Google 不会访问或使用 Cloud Logging 中的数据。
数据驻留:如需帮助满足数据驻留要求,您可以配置 Cloud Logging,以将日志数据存储在您指定的区域中。如需了解详情,请参阅区域化存储日志。
架构中所有产品的安全注意事项
为帮助确保您的架构满足安全要求,请考虑以下一般建议:
- 降低数据渗漏风险:为降低数据渗漏风险,请在基础架构周围创建 VPC Service Controls 边界。VPC Service Controls 支持此参考架构中使用的所有服务。
- 部署后优化:在Google Cloud中部署应用后,使用 Active Assist 服务获取可帮助您进一步优化云资源安全性的建议。查看建议并根据您的环境进行应用。如需了解详情,请参阅在 Active Assist 中查找建议。
- 访问权限控制:针对每项云服务遵循最小权限原则。
如需了解特定于 AI 和机器学习工作负载的安全原则和建议,请参阅 Well-Architected Framework 中的 AI 和机器学习视角:安全性。
可靠性
本部分介绍了在 Google Cloud中为部署构建和运营可靠的基础设施的设计注意事项和建议。
Vector Search 查询伸缩
为确保 Vector Search 索引能够应对查询负载的增加,您可以为索引端点配置自动扩缩。当查询负载增加时,节点数量会自动增加,最多可达到您指定的最大值。如需了解详情,请参阅启用自动扩缩。
Cloud Run 针对基础设施服务中断的稳健性
Cloud Run 是区域级服务。数据跨一个区域内的多个可用区同步存储。流量在可用区之间自动进行负载均衡。如果可用区服务中断,Cloud Run 将继续运行,并且数据不会丢失。如果区域服务中断,Cloud Run 将停止运行,直到 Google 解决服务中断问题。
Cloud Storage 数据可用性
您可以在以下三种位置类型之一中创建 Cloud Storage 存储桶:单区域、双区域或多区域。存储在区域级存储桶中的数据会跨一个区域内的多个可用区同步复制。为了获得更高的可用性,您可以使用双区域或多区域存储桶,其中数据会跨区域异步复制。
Pub/Sub 可靠性注意事项
为确保您的 Pub/Sub 配置满足可靠性要求,请考虑以下建议:
BigQuery 针对基础设施服务中断的稳健性
加载到 BigQuery 的数据会同步存储在指定区域内的两个可用区中。这种冗余有助于确保在发生可用区服务中断时您的数据不会丢失。如需详细了解 BigQuery 中的可靠性功能,请参阅了解可靠性。
针对架构中所有产品的可靠性建议
在 Google Cloud中部署工作负载后,通过应用 Active Assist 中的相关建议,进一步优化云资源的可靠性。
如需了解特定于 AI 和机器学习工作负载的可靠性原则和建议,请参阅 Well-Architected Framework 中的 AI 和机器学习视角:可靠性。
费用优化
本部分将指导您优化您使用此参考架构构建的 Google Cloud 拓扑的设置和操作费用。
Vector Search 费用注意事项
为了帮助优化 Vector Search 的费用,请考虑以下设计因素和建议:
- 查询批处理:Vector Search 的结算取决于索引的大小、每秒查询次数 (QPS) 以及用于索引端点的节点的数量和机器类型。对于高 QPS 工作负载,对查询进行批处理有助于降低费用。如需了解如何估算 Vector Search 费用,请参阅 Vector Search 价格示例。
- 索引端点自动扩缩:为了提高部署了 Vector Search 索引的计算节点的利用率,您可以为索引端点配置自动扩缩。当需求较低时,节点数量会自动减少到您指定的最小值。如需了解详情,请参阅启用自动扩缩。
Cloud Run 费用注意事项
为确保您的 Cloud Run 实现满足您的费用要求,请考虑以下建议:
资源分配:创建 Cloud Run 服务时,您需要指定要分配给容器实例的内存量和 CPU 量。如需控制费用,请从默认(最小)CPU 和内存分配开始。如需提升性能,您可以通过配置 CPU 限制和内存限制来增加分配量。如需了解详情,请参阅以下文档:
费率优化:如果您可以预测 Cloud Run 服务的 CPU 和内存要求,则可以通过获取承诺使用折扣来节省资金。如需了解详情,请参阅 Cloud Run 承诺使用折扣。
Cloud Storage 费用注意事项
对于用于将数据加载到数据注入子系统的 Cloud Storage 存储桶,请选择适当的存储类别。选择存储类别时,请考虑工作负载的数据保留和访问频率要求。例如,如需控制存储费用,您可以选择 Standard 类别并使用对象生命周期管理。这样,系统就会根据您设置的条件将对象自动降级为费用较低的存储类别或删除对象。
Cloud Logging 费用注意事项
如需控制存储日志的费用,请考虑以下建议:
BigQuery 费用注意事项
借助 BigQuery,您可以在运行查询之前估算查询费用。如需优化查询费用,您需要优化存储和查询计算。如需了解详情,请参阅估算和控制费用。
针对架构中所有产品的费用优化建议
为帮助确保您的架构满足费用要求,请考虑以下一般建议:
- 部署后优化:在Google Cloud中部署工作负载后,通过应用 Active Assist 中的相关建议,进一步优化已部署资源的费用。
- 费用估算:如需估算 Google Cloud资源的费用,请使用Google Cloud 价格计算器。
如需了解特定于 AI 和机器学习工作负载的费用优化原则和建议,请参阅 Well-Architected Framework 中的AI 和机器学习视角:费用优化。
性能优化
本部分介绍了在 Google Cloud 中设计满足工作负载性能要求的拓扑的设计注意事项和建议。
Vector Search 性能注意事项
为确保 Vector Search 配置满足您的性能要求,请考虑以下建议:
- 索引配置:创建索引时,请根据性能要求设置每个叶节点的分片大小、距离测量类型和嵌入数量。例如,如果您的应用对延迟时间变化非常敏感,我们建议您使用较大的分片大小。如需了解详情,请参阅影响性能的配置参数。
- 计算容量:在配置部署 Vector Search 搜索索引的节点的计算容量时,请考虑您的性能要求。根据您预期的查询负载,选择适当的机器类型并设置节点数上限。如需了解详情,请参阅影响性能的部署设置。
- 查询参数:根据您对查询性能、可用性和费用的要求,为 Vector Search 搜索索引配置查询参数。例如,
approximateNeighborsCount参数指定在执行精确重新排序之前必须检索的相邻项数量。减小此参数的值有助于降低延迟时间和费用。如需了解详情,请参阅影响性能的查询时设置。 - 索引更新:最新的索引有助于提高生成的回答的准确性。您可以使用批量更新或流式更新来更新 Vector Search 搜索索引。流式更新可让您对更新后的数据执行近乎实时的查询。如需了解详情,请参阅更新和重新构建活跃索引。
Cloud Run 性能注意事项
为确保您的 Cloud Run 实现满足性能要求,请考虑以下建议:
资源分配:默认情况下,系统会为每个 Cloud Run 容器实例分配一个 CPU 和 512 MiB 的内存。根据性能要求,您可以配置 CPU 限制和内存限制。如需了解详情,请参阅以下文档:
实例数下限:为了帮助最大限度地减少延迟时间(即使在一段时间没有流量之后),您可以配置实例数下限。当此类实例处于空闲状态时,分配给这些实例的 CPU 和内存将按较低的价格计费。
如需更多性能优化指南,请参阅常规 Cloud Run 开发技巧。
Cloud Storage 性能注意事项
如需上传大型文件,您可以使用一种名为并行复合上传的方法。使用此策略时,大文件会拆分为各个块。这些块会并行上传到 Cloud Storage,然后数据会在云中重新组合。如果网络带宽和磁盘速度不是限制因素,则并行复合上传可能比常规上传操作更快。但是,此策略存在一些限制和费用影响。如需了解详情,请参阅并行复合上传。
BigQuery 性能注意事项
为确保您的 BigQuery 使用情况满足性能要求,请考虑以下建议:
- 查询性能数据分析:BigQuery 提供了一个查询执行图,可用于分析查询性能并获取针对槽争用和 shuffle 配额不足等问题的性能数据分析。如需了解详情,请参阅获取查询性能数据分析。
- 查询计算优化:通过查询性能数据分析解决发现的问题后,您可以使用各种方法(如减少输入和输出数据量)进一步优化查询。如需了解详情,请参阅优化查询计算。
针对架构中所有产品的性能优化建议
在 Google Cloud中部署工作负载后,应用 Active Assist 的相关建议,进一步优化云资源的性能。
如需了解特定于 AI 和机器学习工作负载的性能优化原则和建议,请参阅 Well-Architected 框架中的 AI 和机器学习视角:性能优化。
部署
如需部署基于此参考架构的拓扑,您可以下载并使用 GitHub 代码库中提供的 Terraform 示例配置。按照代码库中自述文件的说明操作。示例代码不适用于生产应用场景。
后续步骤
- 在 Cloud Run 上构建生成式 AI 应用
- 使用 Agent Platform 和 AlloyDB for PostgreSQL 的生成式 AI RAG 基础设施
- 使用 GKE 和 Cloud SQL 的生成式 AI 的 RAG 基础设施
- 使用 Gemini Enterprise 和 Agent Platform 的生成式 AI 的 RAG 基础架构
- 使用 Agent Platform 和 Spanner Graph 为生成式 AI 构建 GraphRAG 基础设施
- 如需简要了解 Google Cloud中特定于 AI 和机器学习工作负载的架构原则和建议,请参阅 Well-Architected Framework 中的 AI 和机器学习视角。
- 如需查看更多参考架构、图表和最佳实践,请浏览 Cloud 架构中心。
贡献者
作者: Kumar Dhanagopal | 跨产品解决方案开发者
其他贡献者:
- Assaf Namer | 首席云安全架构师
- Deepak Michael | 网络专家客户工程师
- Divam Anand | 产品策略和运营主管
- Eran Lewis | 高级产品经理
- Jerome Simms | 产品管理总监
- Katie McLaughlin | 高级开发者关系工程师
- Mark Schlagenhauf | 网络技术文档工程师
- Megan O'Keefe | 开发技术推广工程师
- Nicholas McNamara | 产品和商业化策略主管
- Preston Holmes | 对外产品经理 - 应用加速
- Rob Edwards | DevOps 技术实践主管
- Victor Morno | Cloud 网络产品经理
- Wietse Venema | 开发者关系工程师