


本文說明如何更新進行中的串流工作。您可能基於下列原因,需要更新現有的 Dataflow 工作:
- 您想增強或改善管道程式碼。
- 您想修正管道程式碼中的錯誤。
- 您想更新管道,以因應資料格式的異動,或資料來源中的版本或其他變更。
- 您想為所有 Dataflow worker 修補與 Container-Optimized OS 相關的安全漏洞。
- 您想擴充串流 Apache Beam 管道,使用不同數量的 worker。
更新工作的方式有兩種:
- 執行中工作更新:對於使用 Streaming Engine 的串流工作,您可以更新
min-num-workers和max-num-workers工作選項,不必停止工作或變更工作 ID。 - 替換工作:如要執行更新後的管道程式碼,或更新執行中工作不支援的工作選項,請啟動新工作來取代現有工作。如要確認替換工作是否有效,請先驗證工作圖,再啟動新工作。
更新工作時,Dataflow 服務會對已執行的工作和可能替換的工作執行相容性檢查。相容性檢查可確保中繼狀態資訊和緩衝資料等內容,能從先前的任務轉移至替換任務。
您也可以使用 Apache Beam SDK 的內建記錄基礎架構,在更新工作時記錄資訊。詳情請參閱「使用管道記錄」。如要找出管道程式碼的問題,請使用 DEBUG 記錄層級。
- 如要瞭解如何更新使用傳統範本的串流工作,請參閱「更新自訂範本串流工作」。
- 如要瞭解如何更新使用 Flex 範本的串流工作,請按照本頁面的 gcloud CLI 操作說明操作,或參閱「更新 Flex 範本工作」。
更新執行中工作選項
如果串流工作使用 Streaming Engine,您可以更新下列工作選項,不必停止工作或變更工作 ID:
min-num-workers:Compute Engine 執行個體數量下限。max-num-workers:Compute Engine 執行個體的數量上限。worker-utilization-hint:目標 CPU 使用率,範圍為 [0.1, 0.9]latency-tier:延遲時間層級,用於設定待處理項目門檻。值:low_latency(預設,少於 15 秒)、medium_latency(少於 2 分鐘) 或high_latency(少於 10 分鐘)。
如要進行其他工作更新,您必須以更新後的工作取代目前的工作。詳情請參閱「啟動替換工作」。
執行執行中更新
如要更新執行中的工作選項,請按照下列步驟操作。
gcloud
使用 gcloud dataflow jobs update-options 指令:
gcloud dataflow jobs update-options \
  --region=REGION \
  --min-num-workers=MINIMUM_WORKERS \
  --max-num-workers=MAXIMUM_WORKERS \
  --worker-utilization-hint=TARGET_UTILIZATION \
  --latency-tier=TIER \
  JOB_ID
更改下列內容:
- REGION:工作區域的 ID
- MINIMUM_WORKERS:Compute Engine 執行個體的數量下限
- MAXIMUM_WORKERS:Compute Engine 執行個體的數量上限
- TARGET_UTILIZATION:範圍 [0.1, 0.9] 中的值
- TIER:目標延遲時間層級。下列其中一項:
low_latency、medium_latency或high_latency - JOB_ID:要更新的工作 ID
您也可以個別更新 --min-num-workers、--max-num-workers、--worker-utilization-hint 或 --latency-tier。
REST
請使用 projects.locations.jobs.update 方法:
PUT https://dataflow.googleapis.com/v1b3/projects/PROJECT_ID/locations/REGION/jobs/JOB_ID?updateMask=MASK
{
  "runtime_updatable_params": {
    "min_num_workers": MINIMUM_WORKERS,
    "max_num_workers": MAXIMUM_WORKERS,
    "worker_utilization_hint": TARGET_UTILIZATION,
    "latency_tier": TIER
  }
}
更改下列內容:
- MASK:以半形逗號分隔的清單,列出要更新的參數,可從下列選項中選擇:
runtime_updatable_params.max_num_workersruntime_updatable_params.min_num_workersruntime_updatable_params.worker_utilization_hint
- PROJECT_ID:Dataflow 工作的 Google Cloud 專案 ID
- REGION:工作區域的 ID
- JOB_ID:要更新的工作 ID
- MINIMUM_WORKERS:Compute Engine 執行個體的數量下限
- MAXIMUM_WORKERS:Compute Engine 執行個體的數量上限
- TARGET_UTILIZATION:範圍 [0.1, 0.9] 中的值
- TIER:目標延遲時間層級。下列其中一項:
low_latency、medium_latency或high_latency
您也可以個別更新 min_num_workers、max_num_workers、worker_utilization_hint 或 latency_tier。在 updateMask 查詢參數中指定要更新的參數,並在要求主體的 runtimeUpdatableParams 欄位中加入更新的值。以下範例會更新 min_num_workers:
PUT https://dataflow.googleapis.com/v1b3/projects/my_project/locations/us-central1/jobs/job1?updateMask=runtime_updatable_params.min_num_workers
{
  "runtime_updatable_params": {
    "min_num_workers": 5
  }
}
工作必須處於執行中狀態,才能進行執行中更新。如果工作尚未開始或已取消,就會發生錯誤。同樣地,如果您啟動替換工作,請等待工作開始執行,再將任何執行中的更新傳送至新工作。
提交更新要求後,建議您等待要求完成,再傳送其他更新。查看工作記錄,瞭解要求何時完成。
驗證替換工作
如要確認替換工作是否有效,請先驗證工作圖,再啟動新工作。在 Dataflow 中,「工作圖表」是以圖表呈現管道。驗證工作圖表可降低更新後管道發生錯誤或失敗的風險。此外,您不必停止原始工作即可驗證更新,因此工作不會停機。
如要驗證工作圖,請按照啟動替換工作的步驟操作。在更新指令中加入 graph_validate_only
Dataflow 服務選項。
Java
- 傳送
--update選項。 - 將
PipelineOptions中的--jobName選項設為要更新的工作名稱。 - 將
--region選項設為與要更新的工作相同的區域。 - 加入
--dataflowServiceOptions=graph_validate_only服務選項。 - 如果管道中有任何轉換名稱有所變更,您必須提供轉換對應,並使用
--transformNameMapping選項加以傳送。 - 如果您提交的替換工作使用較新版本的 Apache Beam SDK,請將
--updateCompatibilityVersion設為原始工作使用的 Apache Beam SDK 版本。
Python
- 傳送
--update選項。 - 將
PipelineOptions中的--job_name選項設為要更新的工作名稱。 - 將
--region選項設為與要更新的工作相同的區域。 - 加入
--dataflow_service_options=graph_validate_only服務選項。 - 如果管道中有任何轉換名稱有所變更,您必須提供轉換對應,並使用
--transform_name_mapping選項加以傳送。 - 如果您提交的替換工作使用較新版本的 Apache Beam SDK,請將
--updateCompatibilityVersion設為原始工作使用的 Apache Beam SDK 版本。
Go
- 傳送
--update選項。 - 將
--job_name選項設為與要更新的工作相同的名稱。 - 將
--region選項設為與要更新的工作相同的區域。 - 加入
--dataflow_service_options=graph_validate_only服務選項。 - 如果管道中有任何轉換名稱有所變更,您必須提供轉換對應,並使用
--transform_name_mapping選項加以傳送。
gcloud
如要驗證 Flex 範本工作的圖表,請使用 gcloud dataflow flex-template run 指令並加上 additional-experiments 選項:
- 傳送
--update選項。 - 將 JOB_NAME 設為與要更新的工作相同的名稱。
- 將
--region選項設為與要更新的工作相同的區域。 - 加入
--additional-experiments=graph_validate_only選項。 - 如果管道中有任何轉換名稱有所變更,您必須提供轉換對應,並使用
--transform-name-mappings選項加以傳送。
例如:
gcloud dataflow flex-template run JOB_NAME --additional-experiments=graph_validate_only
將 JOB_NAME 替換為要更新的工作名稱。
REST
使用 FlexTemplateRuntimeEnvironment (Flex 範本) 或 RuntimeEnvironment 物件中的 additionalExperiments 欄位。
{
  additionalExperiments : ["graph_validate_only"]
  ...
}
graph_validate_only 服務選項只會驗證管道更新。建立或啟動管道時,請勿使用這個選項。如要更新管道,請啟動替換工作,但不使用 graph_validate_only 服務選項。
工作圖表驗證成功後,工作狀態和工作記錄會顯示下列狀態:
- 工作狀態為
JOB_STATE_DONE。 - 在 Google Cloud 控制台中,「Job status」(工作狀態) 為
Succeeded。 工作記錄中會顯示下列訊息:
Workflow job: JOB_ID succeeded validation. Marking graph_validate_only job as Done.
如果工作圖表驗證失敗,工作狀態和工作記錄會顯示下列狀態:
- 工作狀態為
JOB_STATE_FAILED。 - 在 Google Cloud 控制台中,「Job status」(工作狀態) 為
Failed。 - 工作記錄中會顯示訊息,說明不相容錯誤。訊息內容取決於錯誤類型。
啟動替換工作
您可能會基於下列原因,選擇取代現有工作:
- 執行更新後的管道程式碼。
- 更新不支援執行中更新的工作選項。
如要確認替換工作是否有效,請先驗證工作圖,再啟動新工作。
啟動替換工作時,除了設定工作的一般選項外,還須設定下列管道選項,才能執行更新程序:
Java
- 傳送
--update選項。 - 將
PipelineOptions中的--jobName選項設為要更新的工作名稱。 - 將
--region選項設為與要更新的工作相同的區域。 - 如果管道中有任何轉換名稱有所變更,您必須提供轉換對應,並使用
--transformNameMapping選項加以傳送。 - 如果您提交的替換工作使用較新版本的 Apache Beam SDK,請將
--updateCompatibilityVersion設為原始工作使用的 Apache Beam SDK 版本。
Python
- 傳送
--update選項。 - 將
PipelineOptions中的--job_name選項設為要更新的工作名稱。 - 將
--region選項設為與要更新的工作相同的區域。 - 如果管道中有任何轉換名稱有所變更,您必須提供轉換對應,並使用
--transform_name_mapping選項加以傳送。 - 如果您提交的替換工作使用較新版本的 Apache Beam SDK,請將
--updateCompatibilityVersion設為原始工作使用的 Apache Beam SDK 版本。
Go
- 傳送
--update選項。 - 將
--job_name選項設為與要更新的工作相同的名稱。 - 將
--region選項設為與要更新的工作相同的區域。 - 如果管道中有任何轉換名稱有所變更,您必須提供轉換對應,並使用
--transform_name_mapping選項加以傳送。
gcloud
如要使用 gcloud CLI 更新 Flex 範本工作,請使用 gcloud dataflow flex-template run 指令。不支援使用 gcloud CLI 更新其他工作。
- 傳送
--update選項。 - 將 JOB_NAME 設為與要更新的工作相同的名稱。
- 將
--region選項設為與要更新的工作相同的區域。 - 如果管道中有任何轉換名稱有所變更,您必須提供轉換對應,並使用
--transform-name-mappings選項加以傳送。
REST
以下操作說明示範如何使用 REST API 更新非範本工作。如要使用 REST API 更新傳統範本工作,請參閱「更新自訂範本串流工作」。如要使用 REST API 更新 Flex 範本工作,請參閱「更新 Flex 範本工作」。
使用
projects.locations.jobs.get方法,擷取要取代的工作job資源。加入view查詢參數,並將值設為JOB_VIEW_DESCRIPTION。加入JOB_VIEW_DESCRIPTION可限制回應中的資料量,確保後續要求不會超過大小限制。如需更詳細的工作資訊,請使用JOB_VIEW_ALL值。GET https://dataflow.googleapis.com/v1b3/projects/PROJECT_ID/locations/REGION/jobs/JOB_ID?view=JOB_VIEW_DESCRIPTION替換下列值:
- PROJECT_ID:Dataflow 工作的 Google Cloud 專案 ID
- REGION:要更新的工作所在區域
- JOB_ID:要更新的工作 ID
如要更新工作,請使用
projects.locations.jobs.create方法。在要求主體中,使用您擷取的job資源。POST https://dataflow.googleapis.com/v1b3/projects/PROJECT_ID/locations/REGION/jobs { "id": JOB_ID, "replaceJobId": JOB_ID, "name": JOB_NAME, "type": "JOB_TYPE_STREAMING", "transformNameMapping": { string: string, ... }, }更改下列內容:
- JOB_ID:與要更新的工作 ID 相同的工作 ID。
- JOB_NAME:與要更新的工作名稱相同。
如果管道中的任何轉換名稱有所變更,您必須提供轉換對應,並使用
transformNameMapping欄位傳遞。選用:如要使用 curl (Linux、macOS 或 Cloud Shell) 傳送要求,請將要求儲存至 JSON 檔案,然後執行下列指令:
curl -X POST -d "@FILE_PATH" -H "Content-Type: application/json" -H "Authorization: Bearer $(gcloud auth print-access-token)" https://dataflow.googleapis.com/v1b3/projects/PROJECT_ID/locations/REGION/jobs將 FILE_PATH 替換為包含要求主體的 JSON 檔案路徑。
指定替換工作的名稱
Java
啟動替換工作時,針對 --jobName 選項所傳送的值必須與待替換工作的名稱完全相符。
Python
啟動替換工作時,針對 --job_name 選項所傳送的值必須與待替換工作的名稱完全相符。
Go
啟動替換工作時,針對 --job_name 選項所傳送的值必須與待替換工作的名稱完全相符。
gcloud
啟動替換工作時,JOB_NAME 必須與要替換的工作名稱完全相符。
REST
將 replaceJobId 欄位的值設為要更新的工作 ID。如要找出正確的工作名稱值,請在 Dataflow 監控介面中選取先前的工作。接著,在「工作資訊」側邊面板中,找到「工作 ID」欄位。
如要找出正確的工作名稱值,請在 Dataflow 監控介面中選取先前的工作。接著,在「Job info」(工作資訊) 側邊面板中,找到「Job name」(工作名稱) 欄位:
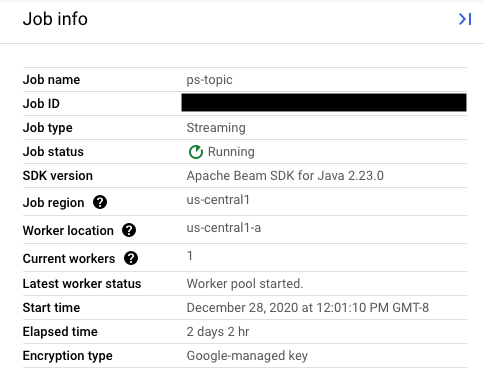
或者,您也可以使用 Dataflow 指令列介面查詢現有工作清單。在殼層或終端機視窗中輸入 gcloud dataflow jobs list 指令,取得 Google Cloud專案中的 Dataflow 工作清單,並找出要取代的工作 NAME 欄位:
JOB_ID                                    NAME                        TYPE       CREATION_TIME        STATE    REGION
2020-12-28_12_01_09-yourdataflowjobid     ps-topic                    Streaming  2020-12-28 20:01:10  Running  us-central1
建立轉換對應
如果替換管道變更了先前管道中的任何轉換名稱,Dataflow 服務會要求提供轉換對應。轉換對應會將先前管道程式碼中的命名轉換,對應至替換管道程式碼中的名稱。
Java
使用 --transformNameMapping 指令列選項傳遞對應,一般格式如下:
--transformNameMapping= .
{"oldTransform1":"newTransform1","oldTransform2":"newTransform2",...}
您只需要針對先前管道與替換管道之間有變更的轉換名稱,在 --transformNameMapping 中提供對應項目即可。
使用 --transformNameMapping 執行時,您可能需要根據殼層適當逸出引號。例如,在 Bash 中:
--transformNameMapping='{"oldTransform1":"newTransform1",...}'
Python
使用 --transform_name_mapping 指令列選項傳遞對應,一般格式如下:
--transform_name_mapping= .
{"oldTransform1":"newTransform1","oldTransform2":"newTransform2",...}
您只需要針對先前管道與替換管道之間有變更的轉換名稱,在 --transform_name_mapping 中提供對應項目即可。
使用 --transform_name_mapping 執行時,您可能需要根據殼層適當逸出引號。例如,在 Bash 中:
--transform_name_mapping='{"oldTransform1":"newTransform1",...}'
Go
使用 --transform_name_mapping 指令列選項傳遞對應,一般格式如下:
--transform_name_mapping= .
{"oldTransform1":"newTransform1","oldTransform2":"newTransform2",...}
您只需要針對先前管道與替換管道之間有變更的轉換名稱,在 --transform_name_mapping 中提供對應項目即可。
使用 --transform_name_mapping 執行時,您可能需要根據殼層適當逸出引號。例如,在 Bash 中:
--transform_name_mapping='{"oldTransform1":"newTransform1",...}'
gcloud
使用 --transform-name-mappings 選項傳遞對應,一般格式如下:
--transform-name-mappings= .
{"oldTransform1":"newTransform1","oldTransform2":"newTransform2",...}
您只需要針對先前管道與替換管道之間有變更的轉換名稱,在 --transform-name-mappings 中提供對應項目即可。
使用 --transform-name-mappings 執行時,您可能需要根據殼層適當逸出引號。例如,在 Bash 中:
--transform-name-mappings='{"oldTransform1":"newTransform1",...}'
REST
使用 transformNameMapping 欄位傳遞對應,一般格式如下:
"transformNameMapping": {
  oldTransform1: newTransform1,
  oldTransform2: newTransform2,
  ...
}
您只需要針對先前管道與替換管道之間有變更的轉換名稱,在 transformNameMapping 中提供對應項目即可。
決定轉換名稱
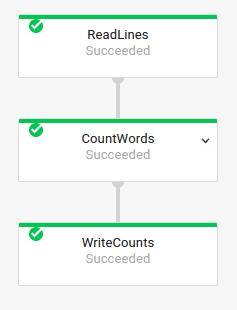
對應中每個執行個體的轉換名稱,是您在管道中套用轉換時提供的名稱。例如:
Java
  .apply("FormatResults", ParDo
    .of(new DoFn<KV<String, Long>>, String>() {
      ...
     }
  }))
Python
| 'FormatResults' >> beam.ParDo(MyDoFn())
Go
  // In Go, this is always the package-qualified name of the DoFn itself.
  // For example, if the FormatResults DoFn is in the main package, its name
  // is "main.FormatResults".
  beam.ParDo(s, FormatResults, results)
您也可以在 Dataflow 監控介面中查看工作的執行圖,取得先前工作的轉換名稱:
複合轉換命名
轉換名稱為階層式結構,以管道中的轉換階層結構為依據。如果管道有複合式轉換,則巢狀轉換的名稱取決於其包含的轉換。舉例來說,假設管道包含名為 CountWidgets 的複合轉換,其中包含名為 Parse 的內部轉換。轉換作業的全名為 CountWidgets/Parse,您必須在轉換對應中指定該全名。
如果新管道將複合轉換對應至其他名稱,所有巢狀轉換也會自動重新命名。您必須在轉換對應中,為內部轉換指定變更後的名稱。
重構轉換階層
如果替代管道使用的轉換階層與先前管道不同,您必須明確宣告對應關係。如果您重構複合轉換,或管道依賴的程式庫複合轉換有所變更,轉換階層可能會有所不同。
舉例來說,先前的管道套用了複合轉換 CountWidgets,其中包含名為 Parse 的內部轉換。替代管道會重構 CountWidgets,並將 Parse 巢狀結構置於另一個名為 Scan 的轉換中。如要成功更新,您必須明確將先前管道 (CountWidgets/Parse) 中的完整轉換名稱,對應至新管道 (CountWidgets/Scan/Parse) 中的轉換名稱:
Java
--transformNameMapping={"CountWidgets/Parse":"CountWidgets/Scan/Parse"}
如果您在替換管道中完全刪除轉換,則必須提供 null 對應。假設替換管道完全移除 CountWidgets/Parse 轉換:
--transformNameMapping={"CountWidgets/Parse":""}
Python
--transform_name_mapping={"CountWidgets/Parse":"CountWidgets/Scan/Parse"}
如果您在替換管道中完全刪除轉換,則必須提供 null 對應。假設替換管道完全移除 CountWidgets/Parse 轉換:
--transform_name_mapping={"CountWidgets/Parse":""}
Go
--transform_name_mapping={"CountWidgets/main.Parse":"CountWidgets/Scan/main.Parse"}
如果您在替換管道中完全刪除轉換,則必須提供 null 對應。假設替換管道完全移除 CountWidgets/Parse 轉換:
--transform_name_mapping={"CountWidgets/main.Parse":""}
gcloud
--transform-name-mappings={"CountWidgets/Parse":"CountWidgets/Scan/Parse"}
如果您在替換管道中完全刪除轉換,則必須提供 null 對應。假設替代管道完全移除 CountWidgets/Parse 轉換:
--transform-name-mappings={"CountWidgets/main.Parse":""}
REST
"transformNameMapping": {
  CountWidgets/Parse: CountWidgets/Scan/Parse
}
如果您在替換管道中完全刪除轉換,則必須提供 null 對應。假設替換管道完全移除 CountWidgets/Parse 轉換:
"transformNameMapping": {
  CountWidgets/main.Parse: null
}
取代工作的影響
取代現有工作時,新工作會執行更新後的管道程式碼。Dataflow 服務會保留工作名稱,但會以更新後的工作 ID 執行替換工作。這個程序可能會導致停機,因為現有工作會停止、相容性檢查會執行,而新工作會啟動。
替換工作會保留下列項目:
- 先前工作的中繼狀態資料。記憶體內快取不會儲存。
- 先前工作的緩衝資料記錄或目前「傳輸中」的中繼資料。舉例來說,管道中的某些記錄可能會在等待視窗解析時緩衝處理。
- 您對先前工作套用的執行中工作選項更新。
如果管道包含代管 I/O 連接器,Dataflow 會檢查連接器是否有更新,並自動使用最新的已知良好版本。詳情請參閱「自動升級」
中繼狀態資料
先前工作的過渡狀態資料會保留。狀態資料不包含記憶體內快取。如要在更新管道時保留記憶體內快取資料,可以重構管道,將快取轉換為狀態資料或側邊輸入。如要進一步瞭解如何使用側邊輸入,請參閱 Apache Beam 說明文件中的「側邊輸入模式」。
串流管道對 ValueState 和側邊輸入內容設有大小限制。因此,如果您有需要保留的大型快取,可能需要使用外部儲存空間,例如 Memorystore 或 Bigtable。
傳輸中的資料
「傳輸中」的資料仍會由新管道中的轉換作業處理。不過,您在替換管道程式碼中新增的其他轉換,可能會生效,也可能不會生效,具體取決於記錄緩衝的位置。在本例中,現有管道包含下列轉換:
Java
  p.apply("Read", ReadStrings())
   .apply("Format", FormatStrings());
Python
  p | 'Read' >> beam.io.ReadFromPubSub(subscription=known_args.input_subscription)
    | 'Format' >> FormatStrings()
Go
   beam.ParDo(s, ReadStrings)
   beam.ParDo(s, FormatStrings)
您可以將工作替換為新的管道程式碼,如下所示:
Java
  p.apply("Read", ReadStrings())
   .apply("Remove", RemoveStringsStartingWithA())
   .apply("Format", FormatStrings());
Python
  p | 'Read' >> beam.io.ReadFromPubSub(subscription=known_args.input_subscription)
    | 'Remove' >> RemoveStringsStartingWithA()
    | 'Format' >> FormatStrings()
Go
  beam.ParDo(s, ReadStrings)
  beam.ParDo(s, RemoveStringsStartingWithA)
  beam.ParDo(s, FormatStrings)
即使您新增轉換來篩除開頭為字母「A」的字串,下一個轉換 (FormatStrings) 仍可能會看到從先前工作轉移過來、開頭為「A」的緩衝或傳輸中字串。
變更視窗
您可以變更替代管道中 PCollection 元素的視窗和觸發策略,但請務必謹慎。變更視窗或觸發策略不會影響已緩衝或傳輸中的資料。
建議您只對管道的時間區間設定進行較細微的變更,例如變更固定時間或滑動時間區間的持續時間。如果對時間區間設定或觸發條件進行重大變更 (例如變更時間區間設定演算法),可能會對管道輸出造成無法預測的結果。
工作相容性檢查
啟動替換工作時,Dataflow 服務會檢查替換工作與先前工作是否相容。如果相容性檢查通過,系統會停止先前的工作。接著,Dataflow 服務會啟動替換工作,並保留相同的工作名稱。如果相容性檢查失敗,先前的工作會繼續在 Dataflow 服務上執行,而替換工作會傳回錯誤。
Java
由於限制,您必須使用封鎖執行,才能在控制台或終端機中查看更新嘗試失敗錯誤。目前的解決方法包括下列步驟:
- 在管道程式碼中使用 pipeline.run().waitUntilFinish()。
- 使用
--update選項執行替換管道程式。 - 等候替換工作成功通過相容性檢查。
- 輸入
Ctrl+C以結束封鎖執行器程序。
或者,您也可以在 Dataflow 監控介面中監控替換工作的狀態。如果工作順利啟動,就表示工作也通過了相容性檢查。
Python
由於限制,您必須使用封鎖執行,才能在控制台或終端機中查看更新嘗試失敗錯誤。目前的解決方法包括下列步驟:
- 在管道程式碼中使用 pipeline.run().wait_until_finish()。
- 使用
--update選項執行替換管道程式。 - 等候替換工作成功通過相容性檢查。
- 輸入
Ctrl+C以結束封鎖執行器程序。
或者,您也可以在 Dataflow 監控介面中監控替換工作的狀態。如果工作順利啟動,就表示工作也通過了相容性檢查。
Go
由於限制,您必須使用封鎖執行,才能在控制台或終端機中查看更新嘗試失敗錯誤。具體來說,您必須使用 --execute_async 或 --async 旗標指定非阻塞執行。目前的解決方法包含下列步驟:
- 執行替代管道程式時,請使用
--update選項,且不使用--execute_async或--async旗標。 - 等候替換工作成功通過相容性檢查。
- 輸入
Ctrl+C以結束封鎖執行器程序。
gcloud
由於限制,您必須使用封鎖執行,才能在控制台或終端機中查看更新嘗試失敗錯誤。目前的解決方法包括下列步驟:
- 如果是 Java 管道,請在管道程式碼中使用 pipeline.run().waitUntilFinish()。如果是 Python 管道,請在管道程式碼中使用 pipeline.run().wait_until_finish()。如果是 Go 管道,請按照「Go」分頁中的步驟操作。
- 使用
--update選項執行替換管道程式。 - 等候替換工作成功通過相容性檢查。
- 輸入
Ctrl+C以結束封鎖執行器程序。
REST
由於限制,您必須使用封鎖執行,才能在控制台或終端機中查看更新嘗試失敗錯誤。目前的解決方法包括下列步驟:
- 如果是 Java 管道,請在管道程式碼中使用 pipeline.run().waitUntilFinish()。如果是 Python 管道,請在管道程式碼中使用 pipeline.run().wait_until_finish()。如果是 Go 管道,請按照「Go」分頁中的步驟操作。
- 使用
replaceJobId欄位執行替換管道程式。 - 等候替換工作成功通過相容性檢查。
- 輸入
Ctrl+C以結束封鎖執行器程序。
相容性檢查會使用提供的轉換對應,確保 Dataflow 能將先前工作步驟中的中繼狀態資料,轉移至替換工作。相容性檢查也會確保管道中的 PCollection 使用相同的編碼器。變更 Coder 可能會導致相容性檢查失敗,因為任何傳輸中的資料或緩衝記錄可能無法在替代管道中正確序列化。
避免相容性中斷
先前管道與替代管道之間的某些差異,可能會導致相容性檢查失敗。這些差異包括:
- 變更管道圖,但不提供對應。更新工作時,Dataflow 會嘗試將先前工作中的轉換與替換工作中的轉換進行比對。這項比對程序可協助 Dataflow 轉移每個步驟的中繼狀態資料。如果您重新命名或移除任何步驟,則必須提供轉換對應,Dataflow 才能據此比對狀態資料。
- 變更步驟的側邊輸入。在替換管道中,對轉換新增或移除側輸入,會導致相容性檢查失敗。
- 變更步驟的 Coder。更新工作時,Dataflow 會保留目前緩衝的所有資料記錄,並在替換工作中處理這些記錄。舉例來說,在視窗化解析期間,可能會產生緩衝資料。如果替換工作使用不同或不相容的資料編碼,Dataflow 就無法序列化或反序列化這些記錄。
從管道中移除「有狀態」作業。如果從管道中移除有狀態作業,替換工作可能無法通過相容性檢查。Dataflow 可以將多個步驟融合在一起,提高效率。如果您從融合步驟中移除依附狀態的作業,檢查就會失敗。有狀態的作業包括:
- 會產生或使用側邊輸入的轉換。
- I/O 讀取。
- 使用帶鍵狀態的轉換。
- 具有時間區間合併的轉換。
變更有狀態
DoFn變數。 對於持續執行的串流工作,如果管道包含有狀態的DoFn,變更有狀態的DoFn變數可能會導致管道失敗。嘗試在其他地理可用區執行替換工作。 請在執行先前工作的相同可用區中執行替換工作,否則替換工作會失敗。
更新結構定義
Apache Beam 允許 PCollection 具有含具名欄位的結構定義,在這種情況下,不需要明確的編碼器。如果特定結構定義的欄位名稱和類型未變更 (包括巢狀欄位),則該結構定義不會導致更新檢查失敗。不過,如果新管道的其他區隔不相容,更新仍可能遭到封鎖。
演進結構定義
由於業務需求不斷演變,通常需要調整 PCollection 的結構定義。更新管道時,Dataflow 服務允許對結構定義進行下列變更:
- 在結構定義中新增一或多個欄位,包括巢狀欄位。
- 將必填 (不可為空值) 欄位類型設為選填 (可為空值)。
更新期間,不得移除欄位、變更欄位名稱或變更欄位類型。
將額外資料傳遞至現有的 ParDo 作業
您可以視用途,使用下列其中一種方法,將額外 (頻外) 資料傳遞至現有的 ParDo 作業:
- 將資訊序列化為
DoFn子類別中的欄位。 - 匿名
DoFn中方法參照的任何變數都會自動序列化。 - 在
DoFn.startBundle()內運算資料。 - 使用
ParDo.withSideInputs傳入資料。
如需詳細資訊,請參閱以下頁面:
- Apache Beam 程式設計指南:ParDo,特別是建立 DoFn 和側邊輸入內容的章節。
- Apache Beam SDK for Java 參考資料:ParDo