


Agent Platform Memory Bank 可根據使用者與代理之間的對話,動態生成長期記憶。這些記憶是跨多個工作階段保留的個人化資訊,可讓代理根據情境和連續性調整及提供個人化回覆。
功能與特色
Memory Bank 可協助您管理記憶,以便個人化代理與使用者互動的方式,並管理脈絡視窗。Memory Bank 會為每個範圍維護獨立的記憶集合。每項記憶都是獨立、完整的資訊,可用於擴充代理可用的背景資訊。例如:
{
  "name": "projects/.../locations/.../reasoningEngines/.../memories/...",
  "scope": {
    "agent_name": "My agent",
    "user": "my user ID"
  },
  "fact": "I use Memory Bank to manage my memories."
}
Memory Bank 包含下列功能:
生成回憶:使用大型語言模型 (LLM) 建立、調整及管理回憶。
記憶擷取:只從來源資料擷取最重要的資訊,並保留為記憶。
記憶整合:將新擷取的資訊與現有記憶整合,讓記憶隨著新資訊的擷取而演變。您也可以將預先擷取的記憶 (例如代理或人工介入迴路認為有意義的資訊) 與現有記憶合併。
非同步生成:在背景生成記憶,代理不必等待記憶生成完成。
持續擷取事件:使用事件擷取功能串流及管理對話事件,系統會根據您設定的批次處理規則,自動觸發記憶生成。
可自訂擷取:提供特定主題和少量樣本範例,設定記憶庫認為有意義的資訊。
多模態理解:處理多模態資訊,生成並保留文字洞察。
代管儲存和檢索:享有全代管、永久且可存取的記憶體儲存庫。
不同身分的資料隔離:記憶體整合和擷取作業會隔離至特定身分。
永久且可存取的儲存空間:儲存可從多個環境存取的記憶,包括 Agent Runtime、本機環境或其他部署選項。
相似度搜尋:使用相似度搜尋擷取記憶,範圍限定為特定身分。
自動到期:設定記憶的存留時間 (TTL),確保過時資訊會自動刪除。設定 Memory Bank 執行個體,讓系統自動為插入或生成的記憶套用存留時間。
記憶修訂版本:自動建立及維護記憶修訂版本,以便檢查記憶在擷取新資訊時如何轉換。
受限制權限:使用 IAM 條件,限制哪些主體可以讀取或寫入特定範圍的記憶。
代理整合:將 Memory Bank 連結至代理,以便調度呼叫來生成及擷取記憶。
整合 Agent Development Kit (ADK):使用內建的 ADK 工具和
VertexAiMemoryBankService,自動調度管理 ADK 代理的呼叫,以便讀取及寫入 Memory Bank。其他框架:將 Memory Bank 程式碼包裝在工具和回呼中,以自動化記憶生成和擷取作業。
用途
您可以使用 Memory Bank,將無狀態代理互動轉換為有狀態、情境式的體驗,讓代理能記住、學習及適應。Memory Bank 適合有下列需求的應用程式:
長期個人化:打造專為個別使用者量身打造的體驗。Memory Bank 會將記憶範圍限定在特定身分,讓代理在多個工作階段中記住使用者的偏好設定、記錄和重要詳細資料。
- 範例:客服專員記住使用者過去支援單中的重要資訊和產品偏好,不必再次詢問。
LLM 驅動的知識擷取:如需自動識別並保留對話或多模態內容中最重要的資訊,不需手動介入,請使用此功能。
- 範例:研究代理讀取一系列技術論文,並建立重要發現、方法和結論的整合記憶。
動態且不斷演變的情境:如果需要非靜態的知識來源,請使用 Memory Bank。Memory Bank 會持續整合代理的新資訊,並在新資料出現時,修正及更新儲存的記憶。確保代理依據的背景資訊一律最新且準確。RAG 具有靜態的外部知識庫,而 Memory Bank 則可根據代理提供的背景資訊進行演變。
應用實例
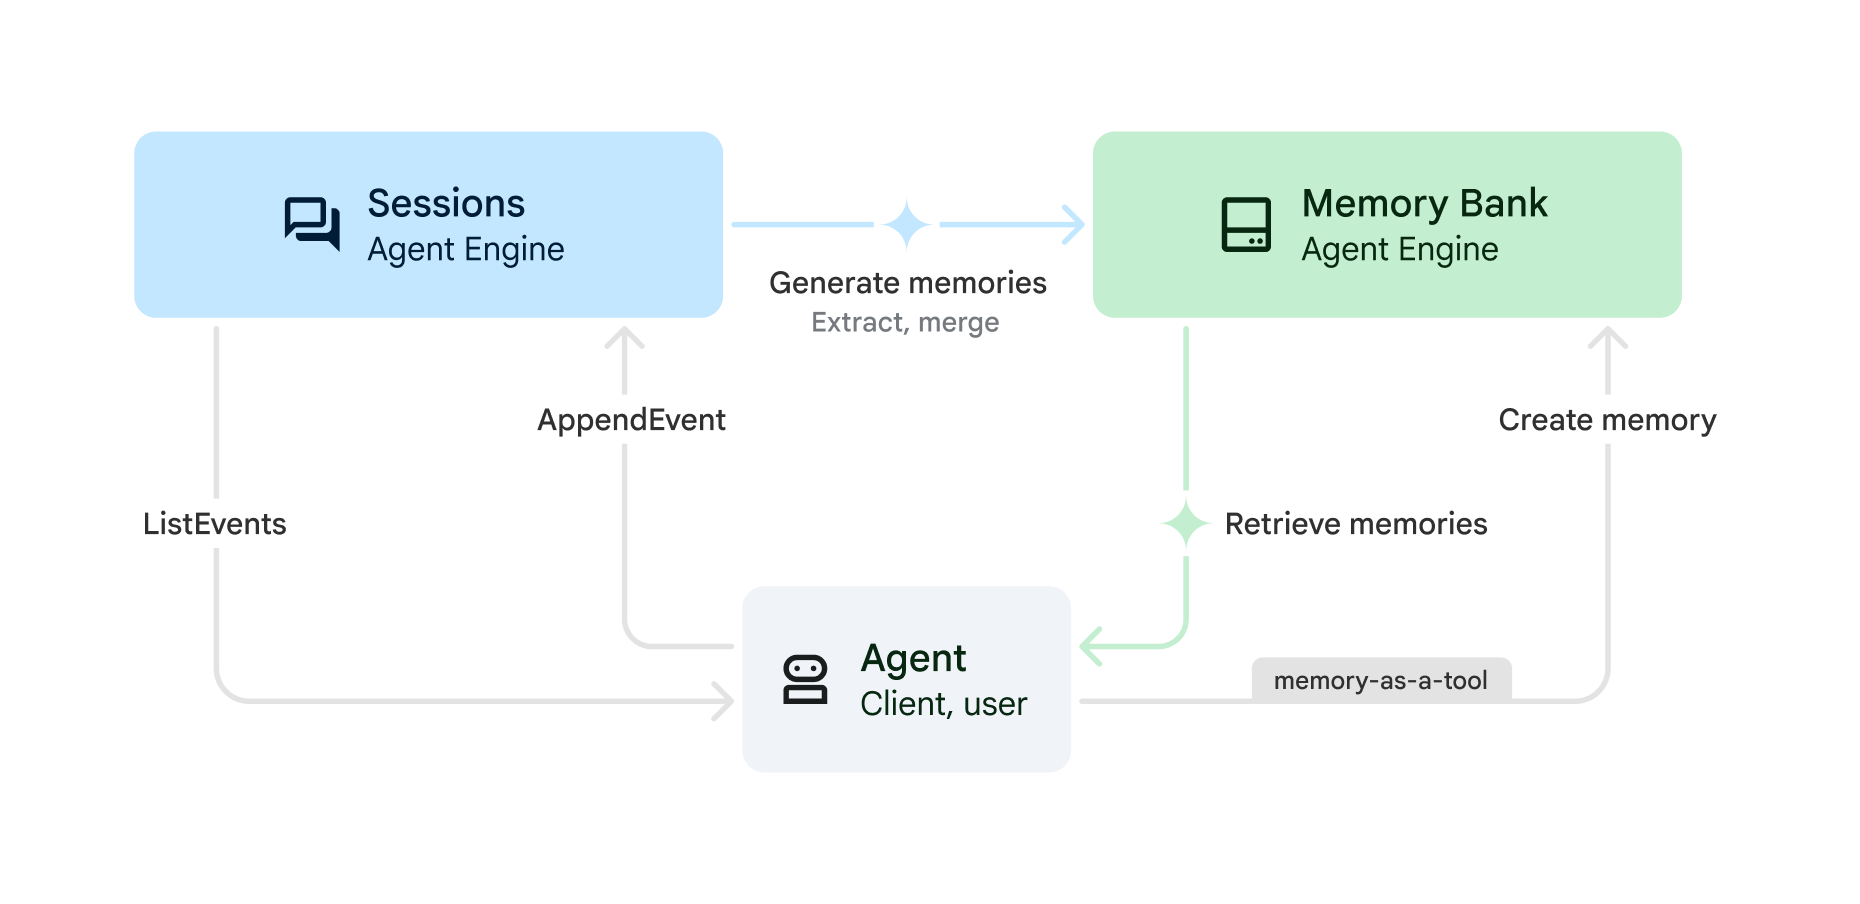
您可以搭配使用 Memory Bank 和 Agent Platform 工作階段,透過下列程序,從儲存的工作階段生成記憶:
(工作階段)
CreateSession:在每段對話開始時,建立新的工作階段。代理使用的對話記錄僅限於這個工作階段。工作階段包含使用者與代理互動時,訊息和動作 (SessionEvents) 的時間順序。所有工作階段都必須有使用者 ID,系統會將這個工作階段擷取的記憶 (請參閱GenerateMemories) 對應至該使用者。(工作階段)
AppendEvent:使用者與代理互動時,事件 (例如使用者訊息、代理回覆、工具動作) 會上傳至工作階段。事件會保留對話記錄,並建立對話記錄,可用於生成記憶。(工作階段)
ListEvents:使用者與代理互動時,代理會擷取對話記錄。(記憶庫) 生成或建立記憶:
GenerateMemories:代理可按照指定間隔 (例如每個工作階段或每輪對話結束時),根據對話記錄觸發記憶生成。系統會自動從對話記錄中擷取使用者的相關事實,以便在目前或日後的對話中使用。CreateMemory:代理可以直接將記憶寫入 Memory Bank。舉例來說,代理可以決定何時寫入記憶,以及應儲存哪些資訊 (記憶即工具)。如要讓代理進一步控管擷取的資訊,請使用CreateMemory。
(記憶庫)
RetrieveMemories:使用者與代理互動時,代理可以擷取儲存的使用者相關記憶。您可以擷取所有記憶 (簡單擷取),或只擷取與目前對話最相關的記憶 (相似度搜尋擷取)。接著,您可以在提示中插入擷取的記憶。
快速入門導覽課程
請參閱下列快速入門導覽課程,開始使用 Memory Bank:
使用 REST API 的快速入門導覽課程:按照 REST API 快速入門導覽課程,直接對 Sessions 和 Memory Bank 發出 API 呼叫。
使用 ADK 的快速入門導覽課程:如果您希望 ADK 代理自動呼叫 Sessions 和 Memory Bank,請按照 ADK 快速入門導覽課程操作。
記憶庫管理
本節說明使用 Memory Bank 時的資料治理考量,例如安全責任和資料落地。
提示詞注入的安全性風險
除了「Agent Platform 共同責任」中列出的安全責任,也請考量提示詞注入和記憶中毒的風險,這些風險可能會影響使用長期記憶的代理。當錯誤資訊儲存在 Memory Bank 時,就會發生記憶中毒。代理可能會在日後的會話中,根據這些錯誤或惡意資訊執行操作。
如要降低記憶中毒的風險,可以採取下列做法:
Model Armor:使用 Model Armor 檢查傳送至記憶庫或來自代理的提示。
對抗測試:模擬攻擊,主動測試 LLM 應用程式是否有提示詞注入安全漏洞。這通常稱為「紅隊演練」。
沙箱執行:如果代理能夠執行或與外部或重要系統互動,則應在沙箱環境中執行這些動作,並實施嚴格的存取控管和專人審查。
詳情請參閱「Google 的安全 AI 代理做法」。
資料落地設定
為遵守《一般資料保護規則》(GDPR) 等規範架構和區域資料主權規定,您必須確保在記憶庫中生成及儲存的記憶,遵循嚴格的資料落地和隔離界限。
雖然 Memory Bank 會在執行個體內,依身分隔離不同範圍的資料,但您仍須套用角色式存取控管 (RBAC) 和 Identity and Access Management 政策,強制執行區域邊界,防止不同區域執行個體之間的記憶體交叉污染。
區域執行個體部署和資料落地
建立 Memory Bank 執行個體時,請選擇區域或多區域位置 (例如歐盟的 eu 或美國的 us),確保靜態資料會保留在特定地理邊界內。
機器學習 (ML) 處理位置取決於基礎模型的區域可用性。如果所選模型或位置 (例如 Gemini 3 模型或亞洲單一區域) 沒有可用的區域端點,系統會使用全域 Gemini 端點進行機器學習處理。詳情請參閱「資料落地」和「多區域和全域端點」。
防止跨境記憶汙染
如果代理執行階段、代理身分、服務帳戶或應用程式在某個管轄區 (例如美國) 運作,卻寫入或擷取位於另一個管轄區 (例如歐盟) 的 Memory Bank 執行個體中的記憶,就會發生跨境記憶汙染。
為防止跨境記憶汙染並遵守法規遵循,您可以設定下列 IAM 控制項:
專屬區域代理身分或服務帳戶:為每個管轄區建立獨立的區域專屬代理身分或服務帳戶 (例如
agent-us@PROJECT_ID.iam.gserviceaccount.com適用於美國工作負載,agent-eu@PROJECT_ID.iam.gserviceaccount.com適用於歐盟工作負載)。確保區域代理身分和服務帳戶,僅在位於相同地理管轄區的 Memory Bank 執行個體上,獲得 IAM 角色,防止區域執行階段存取跨國界執行個體。- 最小權限專用角色:僅授予主體工作負載所需的特定 Memory Bank 角色 (例如唯讀檢索的
roles/aiplatform.memoryViewer,或寫入和生成存取權的roles/aiplatform.memoryEditor),並繫結至適當的區域資源。如要進一步瞭解可用角色,請參閱「Specialized Memory Bank IAM 角色」。
- 最小權限專用角色:僅授予主體工作負載所需的特定 Memory Bank 角色 (例如唯讀檢索的
組織政策:使用
gcp.resourceLocations組織政策限制,在組織、資料夾或專案層級強制執行位置限制。這項限制可確保 Memory Bank 資源只能在符合規定的核准區域建立及使用,並防止未經授權使用全域端點。
如要進一步瞭解如何實作條件式存取政策,請參閱「使用 IAM 條件控管 Agent Platform Memory Bank 的存取權」。