


跨雲端資料存取功能可讓您直接從 Google Cloud 查詢儲存在其他雲端服務供應商的資料儲存庫,不必遷移檔案或建構複雜的 ETL 管道。查詢可以透過公開網際網路轉送,或使用 Cross-Cloud Interconnect 進行私人網路傳輸。
這項功能是無邊界湖倉的一部分,可透過 BigQuery、獨立 Apache Spark 環境或 Managed Service for Apache Spark,整合分散式資料集的數據分析和 AI 工作負載。
除了執行分析查詢,您也可以建構對話式數據分析代理,以分散式資料表 (包括跨雲端來源) 為基礎,透過單一對話分析不同雲端環境中的資料。您也可以使用 Knowledge Catalog,在遠端平台進行資料剖析及取得深入分析。
用途
Lakehouse 支援多種重要用途,可跨多個雲端服務供應商存取資料:
- 減少資料移動:直接查詢儲存在其他雲端環境中的資料,簡化資料存取和處理作業。
- 統一數據分析可讓您使用一致的功能和硬體最佳化,對所有資料執行進階數據分析,無論資料位於何處。
- 無邊界 AI 和機器學習可讓您直接將 AI 模型、自主代理和機器學習技術套用至遠端資料,無須遷移資料。
架構
下圖說明 Lakehouse 跨雲端資料存取架構:
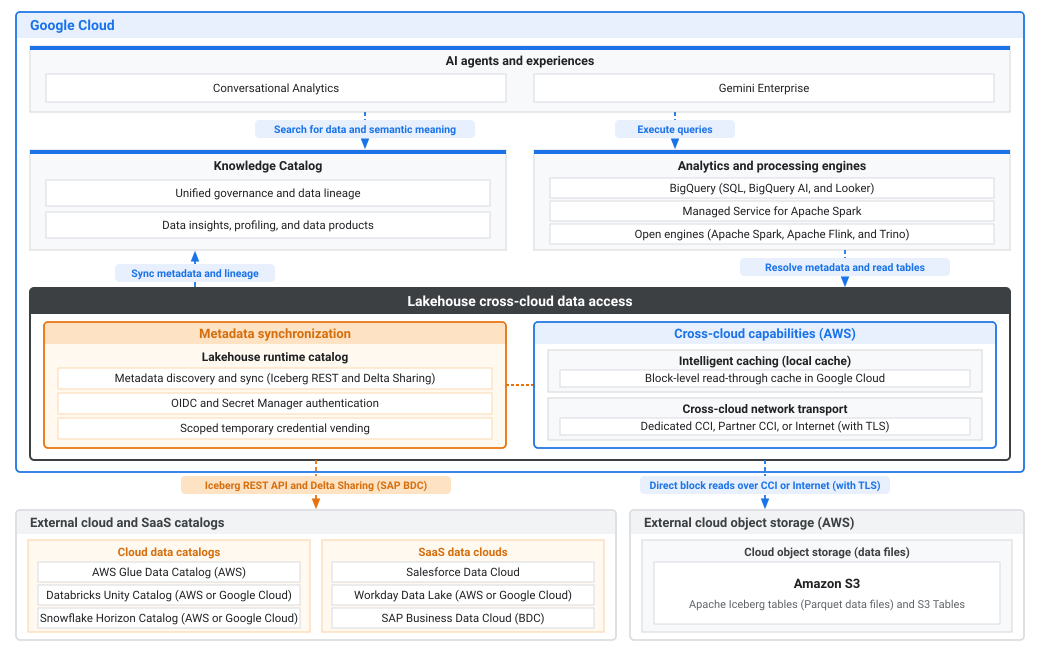
上圖說明 Google Cloud 與外部雲端和 SaaS 環境的架構:
- Google Cloud:提供 AI、治理、數據分析,以及跨雲端資料存取功能,可存取遠端資料集:
- AI 代理和體驗:在對話式數據分析和 Gemini Enterprise 中建構自主代理,在 Knowledge Catalog 中搜尋資料和語意,並透過數據分析和處理引擎執行查詢。
- Knowledge Catalog:同步處理湖倉架構的中繼資料和歷程,提供統一治理和資料歷程,以及資料洞察、剖析和資料產品。
- 數據分析和處理引擎:執行 BigQuery SQL、BigQuery AI 和 Looker 工作負載,或透過 Lakehouse 解析中繼資料和讀取資料表,使用 Managed Service for Apache Spark 和開放式引擎 (Apache Spark、Apache Flink 和 Trino) 處理遠端資料。
- Lakehouse 跨雲端資料存取:直接查詢遠端資料,不需遷移檔案或使用 ETL 管道:
- 中繼資料同步:使用 Lakehouse 執行階段目錄,透過 Apache Iceberg REST 和 Delta Sharing 探索及同步資料表中繼資料,並透過 OpenID Connect (OIDC) 或 Secret Manager 進行驗證,以及提供限定範圍的臨時憑證。
- 跨雲端功能 (AWS):使用區塊層級讀取快取 (智慧型快取 (本機快取)),將讀取的資料區塊快取至 Google Cloud ,並使用跨雲端網路傳輸,透過 Dedicated Cross-Cloud Interconnect (CCI)、Partner Interconnect 或網際網路 (使用 TLS) 轉送流量。
- 外部雲端和 SaaS 資料來源:託管遠端目錄、SaaS Data Cloud 和物件儲存庫:
- 外部雲端和 SaaS 目錄:透過 Iceberg REST API 和 Delta Sharing (適用於 SAP BDC),同步處理雲端資料目錄 (AWS 上的 AWS Glue Data Catalog,以及 AWS 或 Google Cloud上的 Databricks Unity Catalog 和 Snowflake Horizon Catalog) 和 SaaS 資料雲端 (Salesforce Data Cloud、AWS 或Google Cloud上的 Workday 資料湖泊,以及 SAP 業務資料雲端 (BDC)) 的中繼資料。
- 外部雲端物件儲存庫 (AWS):在 Amazon S3 儲存 Apache Iceberg 資料表 (Parquet 資料檔案) 和 Amazon S3 資料表,以便透過 CCI 或網際網路 (使用 TLS) 直接讀取區塊。
如何存取跨雲端資料
Lakehouse 會使用下列程序查詢遠端資料:
- 中繼資料探索:Google Cloud 的 Lakehouse 會連線至遠端 Apache Iceberg REST 目錄,例如 Databricks Unity Catalog 或 AWS Glue。Lakehouse 會探索資料,不複製任何檔案。Lakehouse 會根據遠端目錄供應商,透過 Secret Manager 或 OIDC 權杖聯合機制 (以 Google 為識別資訊提供者) 安全地進行驗證。
- 安全傳輸:選擇透過私人互連網路 (例如 Dedicated CCI 或 Partner Interconnect) 轉送流量,可大幅降低資料移轉費用,並使延遲時間高度可預測。
- 最佳化執行:查詢從遠端雲端讀取資料時,Lakehouse 會將這些資料區段暫時快取至 Google Cloud 中的專用儲存空間。後續查詢會使用本機快取,避免產生大部分的跨雲端輸出費用。
支援的目錄
Lakehouse 支援查詢下列遠端目錄供應商的資料:
- Databricks Unity Catalog:託管於 Amazon Web Services (AWS) 或 Google Cloud。
- AWS Glue:託管於 AWS。
- Snowflake Horizon Catalog:託管於 AWS 或 Google Cloud。
- Workday 資料湖泊:託管於 AWS 或 Google Cloud。
- SAP Business Data Cloud (BDC): 託管於 AWS、Microsoft Azure 或 Google Cloud ,使用 SAP BDC 連接器。
核心概念
本節說明使用跨雲端資料存取功能時,不可或缺的重要元件。
中繼資料層
中繼資料層會連線至遠端 Apache Iceberg REST 目錄端點,根據重新整理間隔同步處理 Iceberg 資源 (命名空間、資料表) 中繼資料。Lakehouse 會使用儲存在 Secret Manager 或 OIDC 權杖聯合中的 OAuth 憑證,安全地進行驗證。
傳輸層
傳輸層可讓 BigQuery 和開放原始碼引擎使用中繼資料層的同步中繼資料查詢資料。對於特定類型的遠端目錄,Lakehouse 支援透過公開網際網路或專屬私人互連網路查詢資料。
請根據架構和安全性需求,選取合適的傳輸方式:
客戶擁有 (CCI)
您可以設定 BigQuery,透過專屬 Cross-Cloud Interconnect 或合作夥伴 Cross-Cloud Interconnect,使用私人 Cross-Cloud Interconnect 查詢儲存在 AWS Amazon S3 bucket 中的資料。
使用私人互連網路有下列好處:
- 安全性更高:資料在 Google Cloud 和 AWS 之間的私人網路連線傳輸,不經過公開網際網路。
- 降低成本:與網際網路輸出相比,AWS 的輸出費用可能較低,尤其是與私人互連容量搭配使用時。
- 穩定的效能:與公開網際網路相比,網路延遲時間和頻寬更可預測。
架構總覽
如要啟用私人查詢,請透過私人互連網路,設定從 BigQuery 到 AWS Amazon S3 bucket 的路徑。 Google Cloud虛擬私有雲 (VPC) 的重要元件是內部負載平衡器 (ILB)。ILB 會將 BigQuery 的要求,分配給 AWS VPC 中 Amazon S3 的私人端點,這些端點是使用 AWS PrivateLink 佈建。
使用 ILB 搭配多個彈性網路介面 (ENI) 做為後端,對於負載平衡、擴充性和高可用性至關重要。無論您使用專屬 CCI 或 Partner Interconnect,都適用這項規定。
私人查詢工作流程如下:
- BigQuery 會使用以 Service Directory 服務設定的連線。
- Service Directory 會將服務名稱解析為 Google Cloud ILB 的內部 IP 位址。
- ILB 會接收來自 BigQuery 的要求,並將要求分配給設定的後端。
- ILB 後端是混合式連線網路端點群組 (NEG),每個群組都指向 AWS VPC 中 ENI 的私人 IP 位址。
- 流量會從 ILB 經由 NEG,透過私人互連網路流向 AWS ENI。
- AWS ENI 是 Amazon S3 虛擬私有雲介面端點 (AWS PrivateLink) 的一部分,可提供 Amazon S3 服務的私人存取權。
公開網際網路 (無 CCI)
如未設定私人互連網路,系統預設會透過公開網際網路,對遠端目錄執行查詢。
透過公開網際網路查詢資料時,請考量下列影響:
- 標準加密:資料存取要求和資料移轉作業在傳輸過程中,會使用標準 TLS 通訊協定在公開網際網路上加密。
- 輸出費用:資料移轉會產生遠端雲端服務供應商 (例如 AWS) 的標準網際網路輸出費用,通常高於私人互連網路輸出費率。
- 延遲時間不穩定:網路效能、頻寬和延遲時間取決於公開網際網路的轉送和壅塞情況,因此與專屬私人互連網路相比,查詢執行時間較難預測。
- 簡化設定:不需要額外的網路基礎架構、虛擬私有雲對接,或在 Google Cloud 或遠端雲端服務供應商中設定 Service Directory。
架構總覽
透過公開網際網路查詢資料時,Lakehouse 會直接連線至遠端目錄和物件儲存庫端點,不需要私人 Google Cloud 或遠端雲端網路基礎架構。
公開網際網路查詢工作流程如下:
- BigQuery 會對 Lakehouse 目錄中定義的遠端資料表發起查詢。
- Lakehouse 會使用儲存在 Secret Manager 或 OIDC 權杖聯盟中的憑證,安全地向遠端 Apache Iceberg 目錄進行驗證。
- Lakehouse 會透過公開網際網路擷取資料表中繼資料和資訊清單檔案,找出相關的基礎資料檔案 (例如 AWS Amazon S3 中的檔案)。
- 基礎物件的資料存取要求會透過公開網際網路,使用標準 TLS 加密直接從Google Cloud 傳送。
- 遠端儲存空間服務會使用 Lakehouse 提供的臨時範圍憑證驗證要求,並透過公開網際網路將要求的資料區塊傳回 Google Cloud。
智慧型快取
查詢遠端雲端資料時,Lakehouse 會自動將擷取的資料區塊快取至 Google Cloud本機。所有跨雲端查詢都會自動啟用快取功能,盡可能降低遠端雲端服務供應商的輸出費用。後續針對快取資料的查詢會直接從本機 Google Cloud 儲存空間讀取,而不是跨雲端重新擷取資料。
節省輸出費用
在初始查詢執行時,Lakehouse 會從遠端雲端服務供應商擷取必要的資料區塊,並填入本機快取。後續針對相同資料區塊的查詢,會直接從本機Google Cloud 快取讀取,而非跨雲端重新擷取資料。
如果工作負載會對相同資料集重複執行查詢模式,快取功能會從本機儲存空間提供資料要求,減少跨雲端輸出費用。實際節省的輸出費用取決於多項因素,例如查詢存取模式、資料修改率,以及目標 Google Cloud區域中的快取保留。
在工作統計資料中驗證快取用量和節省的輸出費用
如要驗證查詢的快取命中率和節省的輸出費用,請在 BigQuery 控制台或 API (JobStatistics2) 中檢查查詢統計資料。由於查詢可以參照多個供應商的資料,因此工作統計資料會提供重複的 object_storage_stats (objectStorageStats) 欄位,其中包含執行期間存取的每個雲端服務供應商的項目。
每個 object_storage_stats 項目都會回報下列指標:
cloud_provider(cloudProvider):託管物件儲存庫的雲端服務供應商 (例如AWS或AZURE)。cache_bytes_read(cacheBytesRead):從本機 Google Cloud 快取讀取的總位元組數,避免讀取遠端物件儲存庫。object_storage_bytes_read(objectStorageBytesRead):直接從遠端雲端服務供應商物件儲存庫讀取的總位元組數。
資料落地和管轄權考量
在 Google Cloud 區域建立遠端目錄或連線時,快取的靜態資料會儲存在該目標區域。
如果遠端雲端資料位於不同的地理區域或管轄區 (例如歐盟的 AWS Amazon S3 與 us-east4 的 BigQuery 運算),跨雲端查詢會將遠端資料的靜態快取副本儲存在目標Google Cloud 區域。建立連線或目錄的使用者或管理員,必須確保跨管轄區快取符合組織的資料落地、主權和法規遵循要求。
加密和 CMEK 支援
Lakehouse 快取不支援客戶自行管理的加密金鑰 (CMEK)。所有快取的資料區塊都會使用預設的Google-owned and Google-managed encryption keys進行靜態資料加密。
如果貴組織強制執行限制非 CMEK 服務組織政策限制 (constraints/gcp.restrictNonCmekServices),Lakehouse 會自動停用存取受限制資料表的查詢快取功能。查詢仍會成功執行,但不會快取資料區塊,也無法享有快取相關輸出節省。
身分模式
Lakehouse 支援兩種跨雲端資料存取的身分模式:
- 服務身分 (預設):背景中繼資料重新整理和查詢作業,都會使用目錄的服務帳戶執行。該帳戶可設定 OIDC (建議) 或 Secret 驗證。
使用者身分聯盟:背景中繼資料重新整理作業會使用目錄的服務帳戶執行,但查詢會使用使用者的身分執行,並傳播至遠端目錄。這樣一來,遠端目錄就能將來自 Google Cloud 的查詢歸因給使用者,進而強制執行權限及產生稽核記錄。必須在遠端目錄中設定身分聯盟。
後續步驟
- 為 AWS Glue、Databricks Unity Catalog、Snowflake Horizon Catalog、Workday Data Lake 或 SAP Business Data Cloud 設定跨雲端連線。