


Lakehouse 运行时目录提供无服务器的统一 metastore,让您可以在 Apache Spark、Apache Hive 和 BigQuery 之间共享数据。借助这个全代管式元数据层,您无需为开源工作负载使用单独的自托管 Hive metastore。
此集成针对 Apache Spark ExternalCatalog 兼容性进行了优化,支持 Hive Metastore 接口的子集。如需确定您的
工作负载是否依赖于不支持的功能(例如事务、压缩或
Kerberos),请查看功能比较和
限制。
Hive 如何与 Lakehouse 运行时目录集成
Hive metastore 端点管理标准 Apache Hive 和 Spark 表(使用 Hive SerDes 或 Spark 数据源),而不是 Apache Iceberg 表。 为了简化将 Spark 作业连接到此端点的过程,Managed Service for Apache Spark 映像预配置了必要的客户端库和依赖项。
以下序列介绍了 Spark 如何连接到 metastore:
- Apache Spark 使用标准 Apache Hive
IMetastoreClient接口连接到外部元数据目录。 - Lakehouse 运行时目录实现自定义
IMetastoreClient,为您的 Spark 和 Hive 元数据提供全代管式 metastore 服务。 - 预配置的 Managed Service for Apache Spark 运行时会自动使用此自定义客户端将元数据操作直接路由到 metastore。
设置完成后,您可以在 BigQuery 中直接查询 Spark 创建的表。此集成支持各种存储 格式(例如 Parquet、ORC、Avro 和 Delta Lake),以及 Spark 和 BigQuery 之间的特定数据类型 映射,以及用于存储在 Cloud Storage 中的数据的客户管理的加密密钥 (CMEK)。
Hive 目录端点如何与 Google Cloud 服务集成
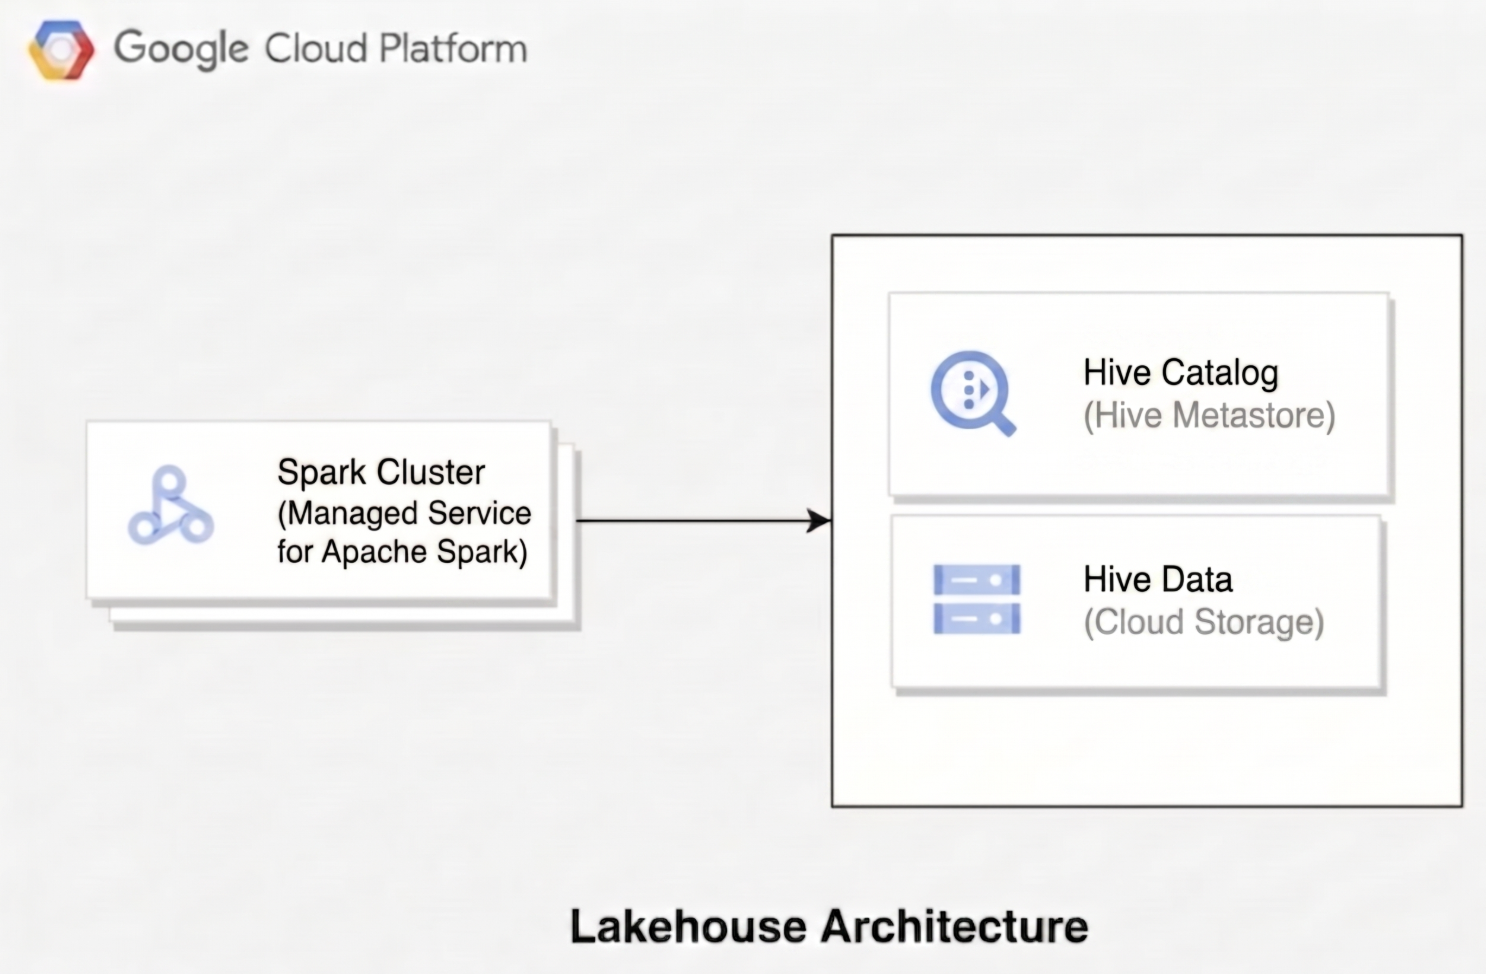
如需了解无边界 Lakehouse 如何管理您的数据,请参阅 Hive 目录架构如何与 Google Cloud 服务集成。 您的开源工作负载无需维护自托管 metastore,而是连接到 Lakehouse 运行时目录来管理 Hive 数据库和表定义,同时将底层数据文件直接存储在 Cloud Storage 仓库目录中。
下图说明了 Managed Service for Apache Spark 等计算引擎如何使用 Lakehouse 运行时目录来管理表元数据,同时直接在 Hive 中读取和写入底层数据文件。
与 Hive Metastore 的功能比较
下表比较了 Hive Metastore 和 Lakehouse 中的实体和操作:
| 实体或操作 | Hive Metastore | Lakehouse 运行时目录 |
|---|---|---|
| 目录 | ✅ | ✅ |
| 数据库(创建、删除、更新) | ✅ | ✅ |
| 表(创建、删除、更新) | ✅ | ✅ |
| 分区(添加、删除、更新) | ✅ | ✅ |
| 表权限 | ✅ | ✅(通过 Identity and Access Management (IAM)) |
| 分区权限 | ✅ | ✅(通过 IAM) |
| 用户定义的函数 | ✅ | 不支持 |
| 存储桶 / 倾斜列 | ✅ | 不支持 |
| 表和分区列统计信息 | ✅ | 不支持 |
| 键约束 | ✅ | 不支持 |
| 委托令牌 (Kerberos) | ✅ | 不支持 |
| 列权限 | ✅ | 不支持 |
| 角色 | ✅ | 不支持 |
| Workload Manager 资源计划 | ✅ | 不支持 |
| 事务和压缩 | ✅ | 不支持 |
从 Dataproc Metastore 迁移
如需将元数据从 Dataproc Metastore 升级和迁移到 Lakehouse 运行时目录,请参阅将元数据从 Dataproc Metastore 迁移到 Lakehouse。