


Lakehouse 執行階段目錄提供無伺服器的統合式 metastore,可讓您在 Apache Spark、Apache Hive 和 BigQuery 之間共用資料。這個全代管中繼資料層可免除開放原始碼工作負載的獨立自代管 Hive 中繼存放區。
這項整合功能已針對 Apache Spark ExternalCatalog 相容性進行最佳化,支援 Hive Metastore 介面的部分功能。如要判斷工作負載是否依賴不支援的功能 (例如交易、壓縮或 Kerberos),請參閱功能比較和限制。
Hive 如何與 Lakehouse 執行階段目錄整合
Hive metastore 端點會管理標準 Apache Hive 和 Spark 資料表 (使用 Hive SerDes 或 Spark 資料來源),而非 Apache Iceberg 資料表。為簡化將 Spark 工作連結至這個端點的程序,Managed Service for Apache Spark 映像檔已預先設定必要的用戶端程式庫和依附元件。
以下序列說明 Spark 如何連線至 metastore:
- Apache Spark 會使用標準的 Apache Hive
IMetastoreClient介面,連線至外部中繼資料目錄。 - Lakehouse 執行階段目錄會實作自訂
IMetastoreClient,為 Spark 和 Hive 中繼資料提供全代管的 metastore 服務。 - 預先設定的 Managed Service for Apache Spark 執行階段會自動使用這個自訂用戶端,將中繼資料作業直接傳送至 metastore。
設定完成後,您就能直接在 BigQuery 中查詢 Spark 建立的資料表。這項整合功能支援多種儲存格式,例如 Parquet、ORC、Avro 和 Delta Lake,以及 Spark 和 BigQuery 之間的特定資料類型對應,以及儲存在 Cloud Storage 中的資料客戶自行管理的加密金鑰 (CMEK)。
Hive 目錄端點如何與 Google Cloud 服務整合
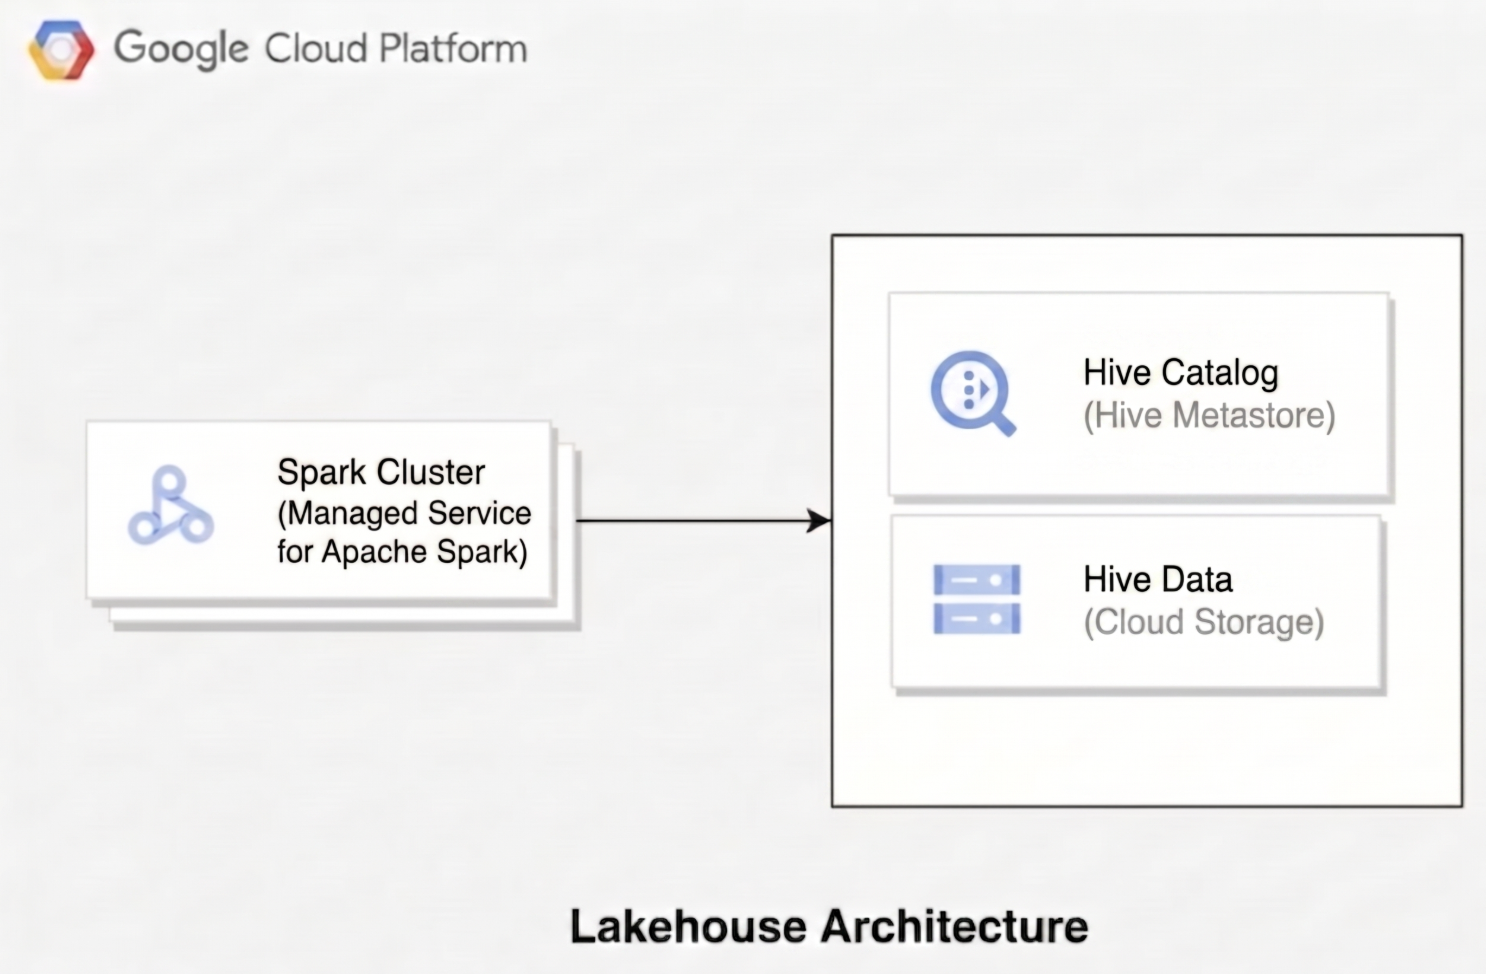
如要瞭解無邊界湖倉如何管理資料,請參閱 Hive 目錄架構與 Google Cloud 服務的整合方式。開放原始碼工作負載不必維護自行代管的 metastore,而是連線至 Lakehouse 執行階段目錄,管理 Hive 資料庫和資料表定義,同時將基礎資料檔案直接儲存在 Cloud Storage 倉儲目錄中。
下圖說明 Managed Service for Apache Spark 等運算引擎,如何使用 Lakehouse 執行階段目錄管理資料表中繼資料,同時直接在 Hive 中讀寫基礎資料檔案。
與 Hive Metastore 的功能比較
下表比較 Hive Metastore 和 Lakehouse 的實體和作業:
| 實體或作業 | Hive 中繼存放區 | Lakehouse 執行階段目錄 |
|---|---|---|
| 目錄 | ✅ | ✅ |
| 資料庫 (建立、刪除、更新) | ✅ | ✅ |
| 資料表 (建立、刪除、更新) | ✅ | ✅ |
| 分割區 (新增、捨棄、更新) | ✅ | ✅ |
| 資料表權限 | ✅ | ✅ (透過 Identity and Access Management (IAM)) |
| 分區權限 | ✅ | ✅ (透過 IAM) |
| 使用者定義函式 | ✅ | 不支援 |
| 分桶 / 偏斜資料欄 | ✅ | 不支援 |
| 資料表和分區資料欄統計資料 | ✅ | 不支援 |
| 主要限制 | ✅ | 不支援 |
| 委派權杖 (Kerberos) | ✅ | 不支援 |
| 資料欄權限 | ✅ | 不支援 |
| 角色 | ✅ | 不支援 |
| Workload Manager 資源方案 | ✅ | 不支援 |
| 交易和壓縮 | ✅ | 不支援 |
從 Dataproc Metastore 遷移
如要將中繼資料從 Dataproc Metastore 升級並遷移至 Lakehouse 執行階段目錄,請參閱「將中繼資料從 Dataproc Metastore 遷移至 Lakehouse」。