


Lakehouse 執行階段目錄的憑證販售功能,可讓您將 Cloud Storage 存取權委派給查詢引擎,並使用 Google Cloud 控制台或 Google Cloud CLI,在目錄、命名空間和資料表層級,強制執行精細的 Identity and Access Management (IAM) 政策。此外,您也必須啟用憑證販售功能,才能啟用自動資料表管理,以便執行壓縮、快照到期和垃圾收集等背景維護工作。
憑證臨時配發的運作方式
使用憑證販售時,作業順序會略有變更,以便在存取儲存空間前強制執行政策。下圖說明查詢引擎如何從目錄取得範圍縮小的儲存空間權杖,以便直接在 Cloud Storage 中安全地讀取及寫入資料:
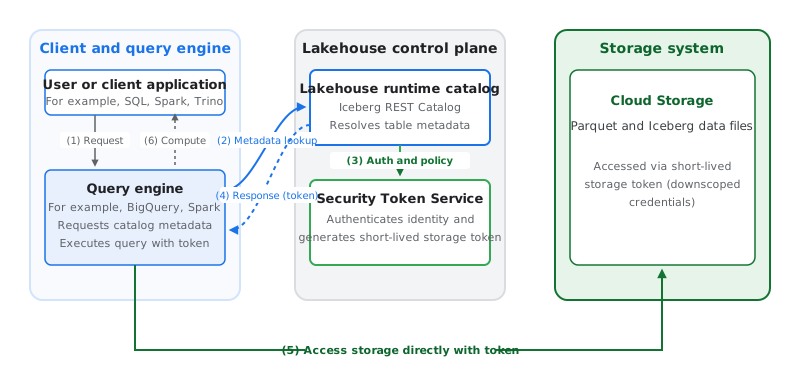
上圖顯示的操作順序如下:
- 要求:使用者將 SQL 陳述式 (例如查詢、DML 或 DDL 作業) 提交至支援的引擎,例如 Apache Spark 或 BigQuery。
- 中繼資料查詢:引擎會向 Lakehouse 執行階段目錄傳送要求,以解析資料表。
- 驗證和政策:目錄會驗證使用者,並檢查他們對 Lakehouse 資源的 IAM 權限。
- 回應:由於已啟用憑證販售功能,目錄會將中繼資料和效期短暫的儲存空間權杖 (範圍縮小的儲存空間憑證) 傳回引擎。權杖的範圍限定為與資料表相關聯的路徑,並縮減至最低必要權限 (例如,對於不需要寫入檔案的查詢,則為唯讀存取權)。
- 存取:引擎會使用這個權杖,直接從 Cloud Storage 讀取或寫入特定授權檔案。
- 運算:引擎會處理資料或執行作業,並傳回結果。
啟用自動資料表管理 (gcp.biglake.table-management.enabled) 後,壓縮、快照到期和垃圾收集等背景維護工作,會使用目錄自動佈建的服務帳戶,直接向 Cloud Storage 驗證並更新基礎資料檔案。
支援的引擎
如要搭配查詢引擎使用憑證臨時配發功能,您必須在 Lakehouse 執行階段目錄中設定 Apache Iceberg REST 目錄端點,以支援憑證臨時配發功能。Apache Hive 目錄端點不支援憑證販售功能。
- 開放原始碼引擎:Spark 和 Trino 等支援的引擎會使用目錄提供的短期儲存空間權杖。用戶端應用程式必須在
X-Iceberg-Access-Delegation標頭中,指定支援憑證販售。 - BigQuery:BigQuery 使用供應的憑證存取 Cloud Storage,而非使用者憑證。
必要的服務帳戶權限
啟用憑證販售功能時,請確認下列服務帳戶具備必要角色:
- 自動佈建的 Lakehouse 執行階段目錄服務帳戶:您必須在所有相關聯的 Cloud Storage bucket,將 Storage 物件使用者角色 (
roles/storage.objectUser) 授予這個帳戶。如果沒有這項存取權,供應的憑證就無法讀取或寫入儲存空間。如果使用 Google Cloud 控制台,按一下「Set bucket permissions」(設定 bucket 權限) 即可驗證這個角色。如果使用 gcloud CLI、Terraform 或 API,則必須手動授予這個角色。 - 查詢引擎服務帳戶:執行查詢引擎工作 (例如 Managed Service for Apache Spark、Managed Service for Apache Spark 或 Dataflow) 的服務帳戶,必須具備 BigLake 編輯者角色 (
roles/biglake.editor),才能取得具有寫入範圍的供應憑證。