


本文档介绍了如何启用 Lightning Engine 来加速 Managed Service for Apache Spark 批量工作负载和交互式会话。
概览
Lightning Engine 是一款高性能查询加速器,由多层优化引擎提供支持,该引擎可执行常规优化技术(例如查询和执行优化),以及文件系统层和数据访问连接器中的精选优化。
如下图所示,Lightning Engine 可在类似 TPC-H 的工作负载(10 TB 数据集大小)上提升 Spark 查询执行性能。
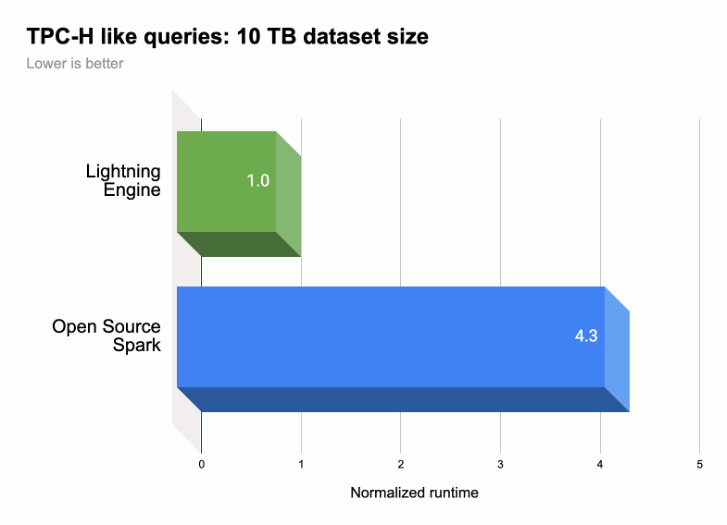
如需了解详情,请参阅全新推出 Lightning Engine,新一代 Apache Spark 性能。
Lightning Engine 可用性
Lightning Engine 和原生查询执行可与 Managed Service for Apache Spark 运行时
2.3搭配使用。Lightning Engine 和原生查询执行在3.0运行时中不可用。Lightning Engine 仅适用于 Managed Service for Apache Spark 高级定价层级。
批处理工作负载:Lightning Engine 会自动为高级层级上的批处理工作负载启用。您无需采取任何行动。
交互式会话:默认情况下,交互式会话不会启用 Lightning Engine。如需启用该功能,请参阅启用 Lightning Engine。
运行时配置文件(会话模板):在 Google Cloud 控制台中创建运行时配置文件时,系统会默认选择高级层级和启用 Lightning Engine 以提升性能。使用 Google Cloud CLI 或 Dataproc API 创建会话模板时,Lightning Engine 默认处于停用状态。如需启用或配置该功能,请参阅启用 Lightning Engine。
启用 Lightning Engine
以下部分介绍了如何在 Managed Service for Apache Spark 批量工作负载、运行时配置文件(会话模板)和交互式会话中启用 Lightning Engine。
批处理工作负载
在批处理工作负载上启用 Lightning Engine
您可以使用 Google Cloud 控制台、Google Cloud CLI 或 Dataproc API 在批处理工作负载上启用 Lightning Engine。
控制台
使用 Google Cloud 控制台在批处理工作负载上启用 Lightning Engine。
在 Google Cloud 控制台中:
- 前往 Managed Service for Apache Spark 批处理。
- 点击创建,打开创建批处理页面。
选择并填写以下字段:
- 容器:
- 运行时版本:选择
2.3。
- 运行时版本:选择
层级配置:
- 选择
Premium。这会自动启用并勾选“启用 LIGHTNING ENGINE 以提升 Spark 性能”。
选择高级层级后,驱动程序计算层级和执行器计算层级会设置为
Premium。对于使用3.0之前的运行时的批处理,这些自动设置的高级层级计算设置无法被覆盖。您可以将驱动程序磁盘层级和执行器磁盘层级配置为
Premium,也可以将其保留为默认的Standard层级值。如果您选择高级磁盘层级,则必须选择磁盘大小。如需了解详情,请参阅资源分配属性。- 选择
属性:可选:如果您想选择原生查询执行运行时,请输入以下
Key(属性名称)和Value对:键 值 spark.dataproc.lightningEngine.runtime本国的/原生的/土著
- 容器:
填写、选择或确认其他批处理工作负载设置。请参阅提交 Spark 批量工作负载。
点击提交以运行 Spark 批处理工作负载。
gcloud
设置以下 gcloud CLI gcloud dataproc batches submit spark 命令标志,以在批处理工作负载上启用 Lightning Engine。
gcloud dataproc batches submit spark \
    --project=PROJECT_ID \
    --region=REGION \
    --version=2.3 \
    --properties=dataproc.tier=premium \
    OTHER_FLAGS_AS_NEEDED
注意:
- PROJECT_ID:您的 Google Cloud 项目 ID。 项目 ID 列在 Google Cloud 控制台信息中心的项目信息部分中。
- REGION:用于运行工作负载的可用 Compute Engine 区域。
--properties=dataproc.tier=premium。设置高级层级会自动在批处理工作负载上设置以下属性:spark.dataproc.engine=lightningEngine为批处理工作负载选择 Lightning Engine。spark.dataproc.driver.compute.tier和spark.dataproc.executor.compute.tier设置为premium(请参阅资源分配属性)。对于使用3.0之前版本的运行时的批处理,这些自动设置的高级层级计算设置无法被覆盖。
其他属性
OTHER_FLAGS_AS_NEEDED:请参阅提交 Spark 批处理工作负载。
API
如需在批处理工作负载上启用 Lightning Engine,请在 batches.create 请求中执行以下操作:
- 将 RuntimeConfig.version 设置为
2.3。 将 "dataproc.tier":"premium" 添加到 RuntimeConfig.properties。设置高级层级会自动在批处理工作负载上设置以下属性:
spark.dataproc.engine=lightningEngine为批处理工作负载选择 Lightning Engine。spark.dataproc.driver.compute.tier和spark.dataproc.executor.compute.tier设置为premium(请参阅资源分配属性)。对于使用3.0之前的运行时的批处理,这些自动设置的高级层级计算设置无法被覆盖。
其他RuntimeConfig.properties:
原生查询引擎:
spark.dataproc.lightningEngine.runtime:native。 如果您想选择原生查询执行运行时,请添加此属性。磁盘层级和大小:默认情况下,驱动程序和执行器磁盘大小设置为
standard层级和大小。您可以添加属性来选择premium层级和大小(以375 GiB的倍数表示)。
如需了解详情,请参阅资源分配属性。
如需设置其他批量工作负载 API 字段,请参阅提交 Spark 批量工作负载。
运行时配置文件
在运行时配置文件(会话模板)上启用 Lightning Engine
您可以使用 Google Cloud 控制台、Google Cloud CLI 或 Dataproc API 在 Jupyter 或 Spark Connect 会话的运行时配置文件(会话模板)上启用 Lightning Engine。
控制台
使用 Google Cloud 控制台在运行时配置文件(会话模板)上启用 Lightning Engine:
在 Google Cloud 控制台中,前往运行时配置文件页面:
点击创建,打开创建运行时配置文件页面。
选择并填写以下字段:
层级:确认已选择高级(默认),并确认已选择启用 Lightning Engine 以提升性能(默认处于选中状态,用于设置
spark.dataproc.engine=lightningEngine)。其他配置:配置以下运行时和 Spark 属性设置:
运行时配置:点击修改,验证 Spark 运行时版本是否设置为
2.3,然后点击保存。其他自定义设置:(可选)如需选择原生查询执行运行时,请点击修改,点击 Spark 属性下的添加属性,输入以下键(属性名称)和值对,然后点击保存:
键 值 spark.dataproc.lightningEngine.runtimenative
填写、选择或确认其他运行时配置文件设置。如需详细了解运行时配置文件设置,请参阅创建运行时配置文件。
点击创建。
gcloud
您无法使用 gcloud CLI 直接创建 Managed Service for Apache Spark 会话模板(运行时配置文件)。您可以改用 gcloud beta dataproc session-templates import 命令导入现有会话模板,修改导入的模板以启用 Lightning Engine 和(可选)Native Query 运行时,然后使用 gcloud beta dataproc session-templates export 命令导出修改后的模板。
API
如需在会话模板(运行时配置文件)上启用 Lightning Engine,请在 sessionTemplates.create 请求中执行以下操作:
- 将 RuntimeConfig.version 设置为
2.3。 - 将 "dataproc.tier":"premium" 和 "spark.dataproc.engine":"lightningEngine" 添加到 RuntimeConfig.properties。
其他RuntimeConfig.properties:
- 原生查询引擎:
spark.dataproc.lightningEngine.runtime:native:将此属性添加到 RuntimeConfig.properties,以选择原生查询执行运行时。
如需详细了解如何设置其他会话模板 API 字段,请参阅创建运行时配置文件(会话模板)。
交互式会话
在交互式会话中启用 Lightning Engine
您可以使用 Google Cloud CLI 或 Dataproc API 在 Managed Service for Apache Spark 交互式会话中启用 Lightning Engine。您还可以在 BigQuery Studio 笔记本中的交互式会话中启用 Lightning Engine。
gcloud
设置以下 gcloud CLI gcloud beta dataproc sessions create spark 命令标志,以便在交互式会话中启用 Lightning Engine。
gcloud beta dataproc sessions create spark \
    --project=PROJECT_ID \
    --location=REGION \
    --version=2.3 \
    --properties=dataproc.tier=premium,spark.dataproc.engine=lightningEngine \
    OTHER_FLAGS_AS_NEEDED
注意:
- PROJECT_ID:您的 Google Cloud 项目 ID。 项目 ID 列在 Google Cloud 控制台信息中心的项目信息部分中。
- REGION:用于运行工作负载的可用 Compute Engine 区域。
--properties=dataproc.tier=premium,spark.dataproc.engine=lightningEngine。这些属性会在会话中启用 Lightning Engine。其他属性:
- 原生查询引擎:
spark.dataproc.lightningEngine.runtime=native:添加此属性以选择原生查询执行运行时。
- 原生查询引擎:
OTHER_FLAGS_AS_NEEDED:请参阅创建交互式会话。
API
如需在会话中启用 Lightning Engine,请在 sessions.create 请求中执行以下操作:
- 将 RuntimeConfig.version 设置为
2.3。 - 将 "dataproc.tier":"premium" 和 "spark.dataproc.engine":"lightningEngine" 添加到 RuntimeConfig.properties。
其他 RuntimeConfig.properties:
- 原生查询引擎:
spark.dataproc.lightningEngine.runtime:native:如果您想选择原生查询执行运行时,请将此属性添加到 RuntimeConfig.properties。
如需设置其他会话模板 API 字段,请参阅创建交互式会话。
BigQuery 笔记本
在 BigQuery Studio PySpark 笔记本中创建会话时,您可以启用 Lightning Engine。
from google.cloud.dataproc_spark_connect import DataprocSparkSession
from google.cloud.dataproc_v1 import Session
session = Session()

# Enable Lightning Engine.
session.runtime_config.properties["version"] = "2.3"
session.runtime_config.properties["dataproc.tier"] = "premium"
session.runtime_config.properties["spark.dataproc.engine"] = "lightningEngine"

# Enable THE Native Query Execution runtime.
session.runtime_config.properties["spark.dataproc.lightningEngine.runtime"] = "native"

# Create the Spark session.
spark = (
   DataprocSparkSession.builder
     .appName("APP_NAME")
     .dataprocSessionConfig(session)
     .getOrCreate())

# Add Spark application code here:
验证 Lightning Engine 设置
您可以使用 Google Cloud 控制台、Google Cloud CLI 或 Dataproc API 验证批处理工作负载、运行时配置文件(会话模板)或交互式会话中的 Lightning Engine 设置。
批处理工作负载
如需验证批处理层级是否设置为
premium,以及引擎是否设置为Lightning Engine,请运行以下命令:- Google Cloud 控制台:在批处理页面上,查看批处理的层级和引擎列。您可以点击批次 ID,在批次详情页面上查看这些设置。
- gcloud CLI:运行
gcloud dataproc batches describe命令。 - API:发出
batches.get请求。
运行时配置文件
如需验证运行时配置文件(会话模板)的 engine 是否设置为
Lightning Engine,请运行以下命令:Google Cloud 控制台:在运行时配置文件页面上,点击运行时配置文件名称,即可在运行时配置文件详情页面上查看其设置。
gcloud CLI:运行
gcloud beta dataproc session-templates describe命令。API:发出
sessionTemplates.get请求。
交互式会话
如需验证交互式会话的 engine 是否设置为
Lightning Engine,请运行以下命令:Google Cloud 控制台:在交互式会话页面上,查看会话的引擎列。您可以点击交互式会话 ID,在会话详情页面上查看此设置。
gcloud CLI:运行
gcloud beta dataproc sessions describe命令。API:发出
sessions.get请求。
原生查询执行
原生查询执行 (NQE) 是一项可选的 Lightning Engine 功能,可通过基于 Apache Gluten 和 Velox 的原生实现来提升性能,该实现专为 Google 硬件而设计。
Native Query Execution 运行时包含统一内存管理功能,可在堆外内存和堆内内存之间动态切换,而无需更改现有 Spark 配置。NQE 扩大了对运算符、函数和 Spark 数据类型的支持,并能智能地自动识别使用原生引擎进行最佳下推操作的机会。
确定原生查询执行工作负载
在以下场景中使用原生查询执行:
从 Parquet 和 ORC 文件中读取数据的 Spark Dataframe API、Spark Dataset API 和 Spark SQL 查询。输出文件格式不会影响原生查询执行性能。
原生查询执行资格评定工具推荐的工作负载。
对于输入包含以下数据类型的工作负载,不建议执行原生查询:
- Byte:ORC 和 Parquet
- 时间戳:ORC
- 结构体、数组、映射:Parquet
原生查询执行限制
在以下场景中启用 Native Query Execution 可能会导致异常、Spark 不兼容或工作负载回退到默认 Spark 引擎。
后备
在以下执行过程中,原生查询执行可能会导致工作负载回退到 Spark 执行引擎,从而导致回归或失败。
ANSI:如果启用了 ANSI 模式,执行会回退到 Spark。
区分大小写模式:原生查询执行仅支持 Spark 默认的不区分大小写模式。如果启用了区分大小写模式,则可能会出现不正确的结果。
分区表扫描:仅当路径包含分区信息时,原生查询执行才支持分区表扫描,否则工作负载会回退到 Spark 执行引擎。
不兼容的行为
在以下情况下,使用原生查询执行可能会导致不兼容的行为或不正确的结果:
JSON 函数:原生查询执行支持用英文双引号(而非英文单引号)括起来的字符串。使用单引号会导致结果不正确。在路径中将“*”与
get_json_object函数搭配使用会返回NULL。Parquet 读取配置:
- 原生查询执行会将
spark.files.ignoreCorruptFiles视为设置为默认false值,即使设置为true也是如此。 - 原生查询执行会忽略
spark.sql.parquet.datetimeRebaseModeInRead,并且仅返回 Parquet 文件内容。不考虑旧版混合(儒略历和公历)日历与预推公历之间的差异。Spark 结果可能会有所不同。
- 原生查询执行会将
NaN:不支持。例如,在数值比较中使用NaN时,可能会出现意外结果。Spark 列式读取:由于 Spark 列式向量与原生查询执行不兼容,因此可能会发生严重错误。
溢出:如果 shuffle 分区数量设置得过大,溢出到磁盘功能可能会触发
OutOfMemoryException。如果发生这种情况,减少分区数量可以消除此异常。