


本文說明如何啟用 Lightning Engine,加速 Managed Service for Apache Spark 批次工作負載和互動式工作階段。
總覽
Lightning Engine 是高效能查詢加速器,採用多層最佳化引擎,可執行查詢和執行最佳化等自訂最佳化技術,以及檔案系統層和資料存取連接器中的精選最佳化。
如下圖所示,Lightning Engine 可加快 Spark 查詢執行效能,處理類似 TPC-H 的工作負載 (10 TB 資料集大小)。
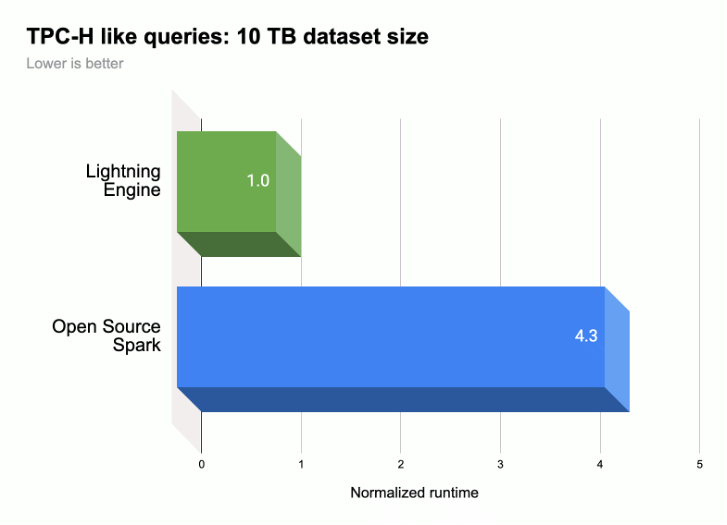
詳情請參閱「隆重推出 Lightning Engine:新一代的 Apache Spark 效能大幅提升」。
Lightning Engine 適用情形
Lightning Engine 和原生查詢執行可與 Managed Service for Apache Spark 執行階段
2.3搭配使用。Lightning Engine 和原生查詢執行作業不適用於3.0執行階段。Lightning Engine 僅適用於 Managed Service for Apache Spark 進階定價級別。
批次工作負載:進階級的批次工作負載會自動啟用 Lightning Engine。您無須採取任何行動。
互動式工作階段:Lightning Engine 預設不會為互動式工作階段啟用。如要啟用,請參閱「啟用 Lightning Engine」。
執行階段設定檔 (工作階段範本):在 Google Cloud 控制台建立執行階段設定檔時,系統會預設選取「進階」級和「啟用 Lightning Engine 以提升效能」。使用 Google Cloud CLI 或 Dataproc API 建立工作階段範本時,Lightning Engine 預設為停用。如要啟用或設定,請參閱「啟用 Lightning Engine」。
啟用 Lightning Engine
以下各節說明如何為 Managed Service for Apache Spark 批次工作負載、執行階段設定檔 (工作階段範本) 和互動式工作階段啟用 Lightning Engine。
批次工作負載
為批次工作負載啟用 Lightning Engine
您可以使用 Google Cloud 控制台、Google Cloud CLI 或 Dataproc API,在批次工作負載上啟用 Lightning Engine。
控制台
使用 Google Cloud 控制台,為批次工作負載啟用 Lightning Engine。
在 Google Cloud 控制台中:
- 前往 Managed Service for Apache Spark 批次。
- 按一下「Create」(建立),開啟「Create batch」(建立批次) 頁面。
選取並填寫下列欄位:
- 容器:
- 執行階段版本:選取
2.3。
- 執行階段版本:選取
層級設定:
- 選取「
Premium」。這項操作會自動啟用並勾選「啟用 Lightning Engine 來提高 Spark 效能」。
選取進階級時,「Driver Compute Tier」(驅動程式運算級別) 和「Executor Compute Tier」(執行器運算級別) 會設為
Premium。如果批次使用的執行階段早於3.0,則無法覆寫這些自動設定的進階級運算設定。您可以將「Driver Disk Tier」(驅動程式磁碟層級) 和「Executor Disk Tier」(執行器磁碟層級) 設為
Premium,或保留預設的Standard層級值。如果選擇進階磁碟級別,則必須選取磁碟大小。詳情請參閱資源分配屬性。- 選取「
屬性:選用:如要選取原生查詢執行執行階段,請輸入下列
Key(屬性名稱) 和Value配對:鍵 值 spark.dataproc.lightningEngine.runtime原生
- 容器:
填寫、選取或確認其他批次工作負載設定。請參閱「提交 Spark 批次工作負載」。
按一下「Submit」(提交),執行 Spark 批次工作負載。
gcloud
設定下列 gcloud CLI gcloud dataproc batches submit spark 指令旗標,為批次工作負載啟用 Lightning Engine。
gcloud dataproc batches submit spark \
    --project=PROJECT_ID \
    --region=REGION \
    --version=2.3 \
    --properties=dataproc.tier=premium \
    OTHER_FLAGS_AS_NEEDED
注意:
- PROJECT_ID:您的 Google Cloud 專案 ID。 專案 ID 會列在 Google Cloud 控制台資訊主頁的「Project info」(專案資訊) 部分。
- REGION:可執行工作負載的 Compute Engine 區域。
--properties=dataproc.tier=premium。 設定進階級後,系統會自動在批次工作負載上設定下列屬性:spark.dataproc.engine=lightningEngine會為批次工作負載選取 Lightning Engine。spark.dataproc.driver.compute.tier和spark.dataproc.executor.compute.tier設為premium(請參閱資源分配屬性)。如果批次使用的執行階段早於3.0,則無法覆寫這些自動設定的進階級運算設定。
其他屬性
OTHER_FLAGS_AS_NEEDED:請參閱「提交 Spark 批次工作負載」。
API
如要在批次工作負載上啟用 Lightning Engine,請在 batches.create 要求中執行下列操作:
- 將 RuntimeConfig.version 設為
2.3。 將「dataproc.tier」:「premium」新增至 RuntimeConfig.properties。設定進階級會自動在批次工作負載上設定下列屬性:
spark.dataproc.engine=lightningEngine會為批次工作負載選取 Lightning Engine。spark.dataproc.driver.compute.tier和spark.dataproc.executor.compute.tier設為premium(請參閱資源分配屬性)。如果批次使用的執行階段早於3.0,則無法覆寫這些自動設定的進階級運算設定。
其他RuntimeConfig.properties:
原生查詢引擎:
spark.dataproc.lightningEngine.runtime:native。如要選取原生查詢執行執行階段,請新增這項屬性。磁碟級別和大小:根據預設,驅動程式和執行器磁碟大小會設為
standard級別和大小。您可以新增屬性,選取premium級別和大小 (375 GiB的倍數)。
詳情請參閱資源分配屬性。
如要設定其他批次工作負載 API 欄位,請參閱「提交 Spark 批次工作負載」。
執行階段設定檔
在執行階段設定檔 (工作階段範本) 啟用 Lightning Engine
您可以使用 Google Cloud 控制台、Google Cloud CLI 或 Dataproc API,在 Jupyter 或 Spark Connect 工作階段的執行階段設定檔 (工作階段範本) 上啟用 Lightning Engine。
控制台
使用 Google Cloud 控制台,在執行階段設定檔 (工作階段範本) 上啟用 Lightning Engine:
在 Google Cloud 控制台中,前往「Runtime Profiles」(執行階段設定檔) 頁面:
按一下「Create」(建立),開啟「Create a runtime profile」(建立執行階段設定檔) 頁面。
選取並填寫下列欄位:
「Tier」(級別):確認已選取「Premium」(進階) (預設),並確認已選取「Enable Lightning Engine to accelerate performance」(啟用 Lightning Engine 來提高效能) (預設為選取,會設定
spark.dataproc.engine=lightningEngine)。其他設定:設定下列執行階段和 Spark 屬性:
「Runtime configuration」(執行階段設定):按一下「Edit」(編輯),確認「Spark runtime version」(Spark 執行階段版本) 設為
2.3,然後按一下「Save」(儲存)。其他自訂項目:(選用) 如要選取原生查詢執行執行階段,請按一下「Edit」(編輯),然後點選「Spark properties」(Spark 屬性) 下方的「Add property」(新增屬性),接著輸入下列「Key」(鍵) (屬性名稱) 和「Value」(值) 組合,最後點選「Save」(儲存):
鍵 值 spark.dataproc.lightningEngine.runtimenative
填寫、選取或確認其他執行階段設定檔設定。如要進一步瞭解執行階段設定檔設定,請參閱「建立執行階段設定檔」。
點選「建立」。
gcloud
您無法直接使用 gcloud CLI 建立 Managed Service for Apache Spark 工作階段範本 (執行階段設定檔)。您可以改用 gcloud beta dataproc session-templates import 指令匯入現有的工作階段範本,編輯匯入的範本來啟用 Lightning Engine,並視需要啟用原生查詢執行階段,然後使用 gcloud beta dataproc session-templates export 指令匯出編輯過的範本。
API
如要在工作階段範本 (執行階段設定檔) 上啟用 Lightning Engine,請在 sessionTemplates.create 要求中執行下列操作:
- 將 RuntimeConfig.version 設為
2.3。 - 將「dataproc.tier」:「premium」和「spark.dataproc.engine」:「lightningEngine」新增至 RuntimeConfig.properties。
其他RuntimeConfig.properties:
- 原生查詢引擎:
spark.dataproc.lightningEngine.runtime:native:將這項屬性新增至 RuntimeConfig.properties,即可選取原生查詢執行執行階段。
如要進一步瞭解如何設定其他工作階段範本 API 欄位,請參閱「建立執行階段設定檔 (工作階段範本)」。
互動式工作階段
在互動式工作階段啟用 Lightning Engine
您可以使用 Google Cloud CLI 或 Dataproc API,在 Managed Service for Apache Spark 互動式工作階段中啟用 Lightning Engine。您也可以在 BigQuery Studio 筆記本的互動式工作階段中啟用 Lightning Engine。
gcloud
設定下列 gcloud CLI gcloud beta dataproc sessions create spark 指令旗標,在互動式工作階段啟用 Lightning Engine。
gcloud beta dataproc sessions create spark \
    --project=PROJECT_ID \
    --location=REGION \
    --version=2.3 \
    --properties=dataproc.tier=premium,spark.dataproc.engine=lightningEngine \
    OTHER_FLAGS_AS_NEEDED
注意:
- PROJECT_ID:您的 Google Cloud 專案 ID。 專案 ID 會列在 Google Cloud 控制台資訊主頁的「Project info」(專案資訊) 部分。
- REGION:可執行工作負載的 Compute Engine 區域。
--properties=dataproc.tier=premium,spark.dataproc.engine=lightningEngine。 這些屬性會為工作階段啟用 Lightning Engine。其他屬性:
- 原生查詢引擎:
spark.dataproc.lightningEngine.runtime=native:新增這項屬性,即可選取原生查詢執行執行階段。
- 原生查詢引擎:
OTHER_FLAGS_AS_NEEDED:請參閱「建立互動式工作階段」。
API
如要在工作階段啟用 Lightning Engine,請在 sessions.create 要求中執行下列操作:
- 將 RuntimeConfig.version 設為
2.3。 - 將「dataproc.tier」:「premium」和「spark.dataproc.engine」:「lightningEngine」新增至 RuntimeConfig.properties。
其他RuntimeConfig.properties:
- 原生查詢引擎:
spark.dataproc.lightningEngine.runtime:native:如要選取原生查詢執行執行階段,請將這項屬性新增至 RuntimeConfig.properties。
如要設定其他工作階段範本 API 欄位,請參閱「建立互動式工作階段」。
BigQuery 筆記本
在 BigQuery Studio PySpark 筆記本中建立工作階段時,可以啟用 Lightning Engine。
from google.cloud.dataproc_spark_connect import DataprocSparkSession
from google.cloud.dataproc_v1 import Session
session = Session()

# Enable Lightning Engine.
session.runtime_config.properties["version"] = "2.3"
session.runtime_config.properties["dataproc.tier"] = "premium"
session.runtime_config.properties["spark.dataproc.engine"] = "lightningEngine"

# Enable THE Native Query Execution runtime.
session.runtime_config.properties["spark.dataproc.lightningEngine.runtime"] = "native"

# Create the Spark session.
spark = (
   DataprocSparkSession.builder
     .appName("APP_NAME")
     .dataprocSessionConfig(session)
     .getOrCreate())

# Add Spark application code here:
驗證 Lightning Engine 設定
您可以使用 Google Cloud 控制台、Google Cloud CLI 或 Dataproc API,驗證批次工作負載、執行階段設定檔 (工作階段範本) 或互動式工作階段的 Lightning Engine 設定。
批次工作負載
執行階段設定檔
互動式工作階段
原生查詢執行作業
原生查詢執行作業 (NQE) 是 Lightning Engine 的選用功能,可透過以 Apache Gluten 和 Velox 為基礎的原生實作,提升 Google 硬體產品的效能。
原生查詢執行執行階段包含統一記憶體管理功能,可在堆積外和堆積內記憶體之間動態切換,無須變更現有的 Spark 設定。NQE 擴大支援運算子、函式和 Spark 資料類型,並能自動找出使用原生引擎的機會,以最佳方式執行下推作業。
找出原生查詢執行作業工作負載
在下列情況下,請使用原生查詢執行作業:
Spark Dataframe API、Spark Dataset API,以及從 Parquet 和 ORC 檔案讀取資料的 Spark SQL 查詢。輸出檔案格式不會影響原生查詢執行效能。
原生查詢執行作業資格工具建議的工作負載。
如果工作負載的輸入內容屬於下列資料類型,則不建議執行原生查詢:
- Byte:ORC 和 Parquet
- 時間戳記:ORC
- Struct、Array、Map:Parquet
原生查詢執行作業限制
在下列情況下啟用原生查詢執行功能,可能會導致例外狀況、Spark 不相容,或工作負載改用預設 Spark 引擎。
備用廣告
在下列執行作業中執行原生查詢,可能會導致工作負載改用 Spark 執行引擎,進而造成迴歸或失敗。
ANSI:如果啟用 ANSI 模式,執行作業會改回使用 Spark。
區分大小寫模式:原生查詢執行作業僅支援 Spark 預設的不區分大小寫模式。如果啟用區分大小寫模式,可能會產生不正確的結果。
分區資料表掃描:只有在路徑包含分區資訊時,原生查詢執行作業才支援分區資料表掃描,否則工作負載會改用 Spark 執行引擎。
不相容行為
在下列情況下使用原生查詢執行,可能會導致不相容的行為或不正確的結果:
JSON 函式:原生查詢執行功能支援以雙引號括住的字串,不支援單引號。使用單引號會導致結果不正確。在路徑中搭配
get_json_object函式使用「*」會傳回NULL。Parquet 讀取設定:
- 原生查詢執行會將
spark.files.ignoreCorruptFiles視為設為預設false值,即使設為true也是如此。 - 原生查詢執行作業會忽略
spark.sql.parquet.datetimeRebaseModeInRead,只傳回 Parquet 檔案內容。不考慮舊版混合曆 (儒略曆和公曆) 與逆推公曆之間的差異。Spark 結果可能有所不同。
- 原生查詢執行會將
NaN:不支援。舉例來說,在數值比較中使用NaN時,可能會發生非預期的結果。Spark 欄式讀取:Spark 欄式向量與原生查詢執行不相容,因此可能會發生嚴重錯誤。
溢出:如果隨機分區數量過多,溢出至磁碟功能可能會觸發
OutOfMemoryException。如果發生這種情況,減少分區數量即可消除這個例外狀況。