本文档介绍了如何运行 Managed Service for Apache Spark SQL 和 PySpark 批处理工作负载,以创建元数据存储在 Lakehouse 运行时目录中的 Apache Iceberg 表。如需了解运行 Spark 代码的其他方式,请参阅在 BigQuery 笔记本中运行 PySpark 代码和运行 Apache Spark 工作负载
准备工作
如果您尚未创建项目和 Cloud Storage 存储桶,请先创建这些资源。 Google Cloud
设置项目
- 登录您的 Google Cloud 账号。如果您是 Google Cloud新手,请 创建一个账号来评估我们的产品在实际场景中的表现。新客户还可获享 $300 赠金,用于运行、测试和部署工作负载。
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
Enable the Dataproc, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
Enable the Dataproc, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.
在项目中创建 Cloud Storage 存储桶。
- 在 Google Cloud 控制台中,前往 Cloud Storage 存储桶页面。
- 点击 创建。
- 在创建存储桶页面上,输入您的存储桶信息。要转到下一步,请点击继续。
- 在开始使用部分中,执行以下操作:
- 在选择数据存储位置部分,执行以下操作:
- 在选择数据存储方式部分中,执行以下操作:
- 在选择如何控制对对象的访问权限部分中,选择存储桶是否强制执行禁止公开访问,然后为存储桶对象选择访问权限控制方法。
- 在选择如何保护对象数据部分中,执行以下操作:
- 点击创建。
向 Compute Engine 默认服务账号
PROJECT_NUMBER-compute@developer.gserviceaccount.com授予 BigQuery Data Editor (roles/bigquery.dataEditor) 角色。 如需查看相关说明,请参阅授予单个角色。Google Cloud CLI 示例:
gcloud projects add-iam-policy-binding PROJECT_ID \
    --member PROJECT_NUMBER-compute@developer.gserviceaccount.com \
--role roles/bigquery.dataEditor
注意:
- PROJECT_ID 和 PROJECT_NUMBER 列在 Google Cloud 控制台信息中心的项目信息部分中。
从 OSS 资源到 BigQuery 资源的映射
请注意以下开源资源与 BigQuery 资源术语之间的映射:
| OSS 资源 | BigQuery 资源 |
|---|---|
| 命名空间、数据库 | 数据集 |
| 分区表或未分区表 | 表格 |
| 视图 | 视图 |
创建 Iceberg 表
本部分介绍了如何使用 Managed Service for Apache Spark Spark SQL 和 PySpark 批量工作负载在 Lakehouse 运行时目录中创建包含元数据的 Iceberg 表。
Spark SQL
运行 Spark SQL 工作负载以创建 Iceberg 表
以下步骤介绍了如何运行 Managed Service for Apache Spark SQL 批处理工作负载,以创建包含存储在 Lakehouse 运行时目录中的表元数据的 Iceberg 表。
在本地或在 Cloud Shell 中将以下 Spark SQL 命令复制到
iceberg-table.sql文件中。USE CATALOG_NAME; CREATE NAMESPACE IF NOT EXISTS example_namespace; USE example_namespace; DROP TABLE IF EXISTS example_table; CREATE TABLE example_table (id int, data string) USING ICEBERG LOCATION 'gs://BUCKET/WAREHOUSE_FOLDER'; INSERT INTO example_table VALUES (1, 'first row'); ALTER TABLE example_table ADD COLUMNS (newDoubleCol double); DESCRIBE TABLE example_table;
替换以下内容:
- CATALOG_NAME:Iceberg 目录名称。
- BUCKET 和 WAREHOUSE_FOLDER:用作 Iceberg 数据仓库目录的 Cloud Storage 存储桶和文件夹。
在本地或在 Cloud Shell 中从包含
iceberg-table.sql的目录运行以下命令,以提交 Spark SQL 工作负载。gcloud dataproc batches submit spark-sql iceberg-table.sql \ --project=PROJECT_ID \ --region=REGION \ --deps-bucket=BUCKET_NAME \ --version=2.2 \ --subnet=SUBNET_NAME \ --properties="spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,spark.sql.catalog.CATALOG_NAME.catalog-impl=org.apache.iceberg.gcp.bigquery.BigQueryMetastoreCatalog,spark.sql.catalog.CATALOG_NAME.gcp_project=PROJECT_ID,spark.sql.catalog.CATALOG_NAME.gcp_location=LOCATION,spark.sql.catalog.CATALOG_NAME.warehouse=gs://BUCKET/WAREHOUSE_FOLDER"
注意:
- PROJECT_ID:您的 Google Cloud 项目 ID。 项目 ID 列在 Google Cloud 控制台信息中心的项目信息部分中。
- REGION:用于运行工作负载的可用 Compute Engine 区域。
- BUCKET_NAME:Cloud Storage 存储桶的名称。Spark 会在运行批处理工作负载之前,将工作负载依赖项上传到此存储桶中的
/dependencies文件夹。WAREHOUSE_FOLDER 位于此存储桶中。 --version:Managed Service for Apache Spark 运行时版本 2.2 或更高版本。- SUBNET_NAME:
REGION中的 VPC 子网的名称。如果您省略此标志,Managed Service for Apache Spark 会选择会话区域中的default子网。Managed Service for Apache Spark 会在子网上启用专用 Google 访问通道 (PGA)。如需了解网络连接要求,请参阅 Managed Service for Apache Spark 网络配置。 - LOCATION:受支持的 BigQuery 位置。默认位置为“US”。
--properties目录属性。
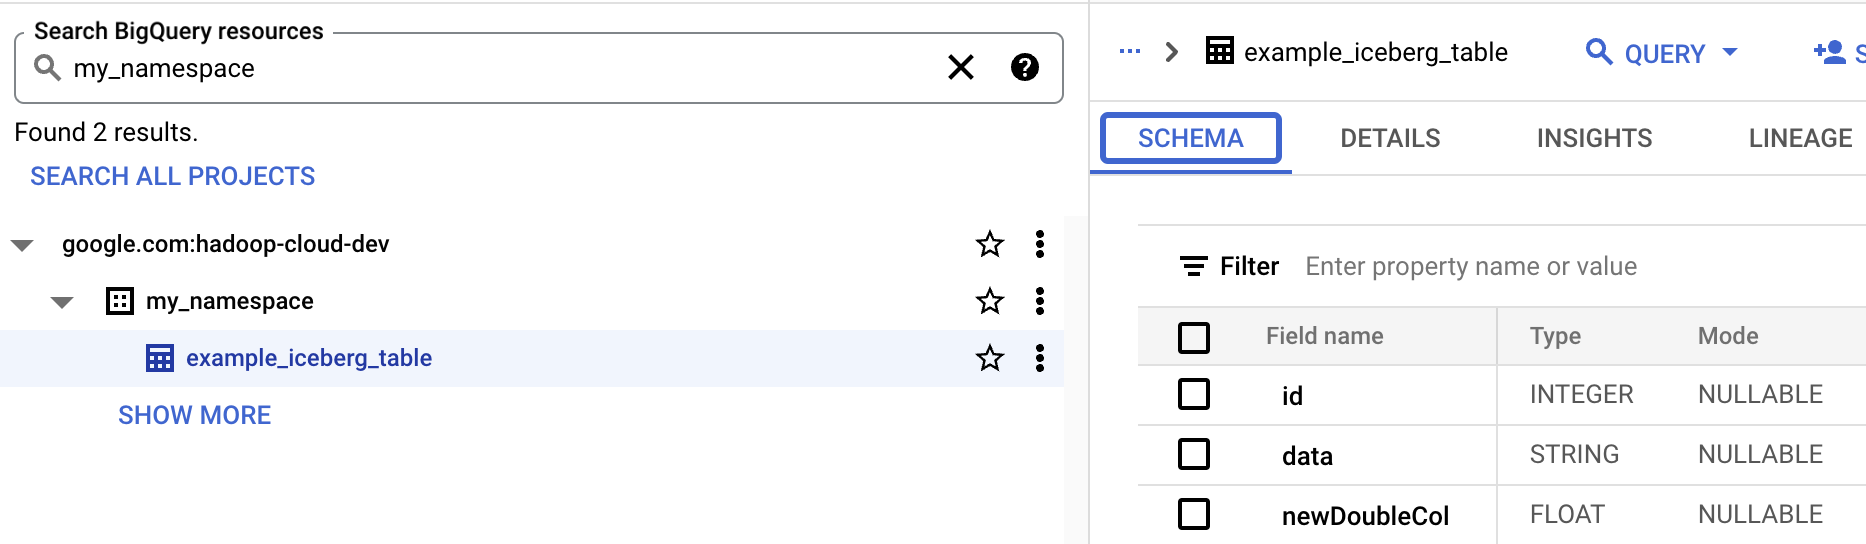
查看 BigQuery 中的表元数据
在 Google Cloud 控制台中,前往 BigQuery 页面。
查看 Iceberg 表元数据。
PySpark
以下步骤介绍了如何运行 Managed Service for Apache Spark PySpark 批处理工作负载,以创建包含存储在 Lakehouse 运行时目录中的表元数据的 Iceberg 表。
- 在本地或在 Cloud Shell 中将以下 PySpark 代码复制到
iceberg-table.py文件中。from pyspark.sql import SparkSession spark = SparkSession.builder.appName("iceberg-table-example").getOrCreate() catalog = "CATALOG_NAME" namespace = "NAMESPACE" spark.sql(f"USE `{catalog}`;") spark.sql(f"CREATE NAMESPACE IF NOT EXISTS `{namespace}`;") spark.sql(f"USE `{namespace}`;") # Create table and display schema spark.sql("DROP TABLE IF EXISTS example_iceberg_table") spark.sql("CREATE TABLE example_iceberg_table (id int, data string) USING ICEBERG") spark.sql("DESCRIBE example_iceberg_table;") # Insert table data. spark.sql("INSERT INTO example_iceberg_table VALUES (1, 'first row');") # Alter table, then display schema. spark.sql("ALTER TABLE example_iceberg_table ADD COLUMNS (newDoubleCol double);") spark.sql("DESCRIBE example_iceberg_table;")
替换以下内容:
- CATALOG_NAME 和 NAMESPACE:Iceberg 目录名称和命名空间组合起来,用于标识 Iceberg 表 (
catalog.namespace.table_name)。
- CATALOG_NAME 和 NAMESPACE:Iceberg 目录名称和命名空间组合起来,用于标识 Iceberg 表 (
-
在本地或在 Cloud Shell 中从包含
iceberg-table.py的目录运行以下命令,以提交 PySpark 工作负载。gcloud dataproc batches submit pyspark iceberg-table.py \ --project=PROJECT_ID \ --region=REGION \ --deps-bucket=BUCKET_NAME \ --version=2.2 \ --subnet=SUBNET_NAME \ --properties="spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,spark.sql.catalog.CATALOG_NAME.catalog-impl=org.apache.iceberg.gcp.bigquery.BigQueryMetastoreCatalog,spark.sql.catalog.CATALOG_NAME.gcp_project=PROJECT_ID,spark.sql.catalog.CATALOG_NAME.gcp_location=LOCATION,spark.sql.catalog.CATALOG_NAME.warehouse=gs://BUCKET/WAREHOUSE_FOLDER"注意:
- PROJECT_ID:您的 Google Cloud 项目 ID。 项目 ID 列在 Google Cloud 控制台信息中心的项目信息部分中。
- REGION:用于运行工作负载的可用 Compute Engine 区域。
- BUCKET_NAME:Cloud Storage 存储桶的名称。Spark 会在运行批处理工作负载之前,将工作负载依赖项上传到此存储桶中的
/dependencies文件夹。 --version:Managed Service for Apache Spark 运行时版本 2.2 或更高版本。- SUBNET_NAME:
REGION中的 VPC 子网的名称。如果您省略此标志,Managed Service for Apache Spark 会选择会话区域中的default子网。Managed Service for Apache Spark 会在子网上启用专用 Google 访问通道 (PGA)。如需了解网络连接要求,请参阅 Managed Service for Apache Spark 网络配置。 - LOCATION:受支持的 BigQuery 位置。 默认位置为“US”。
- BUCKET 和 WAREHOUSE_FOLDER:用作 Iceberg 数据仓库目录的 Cloud Storage 存储桶和文件夹。
--properties:目录属性。
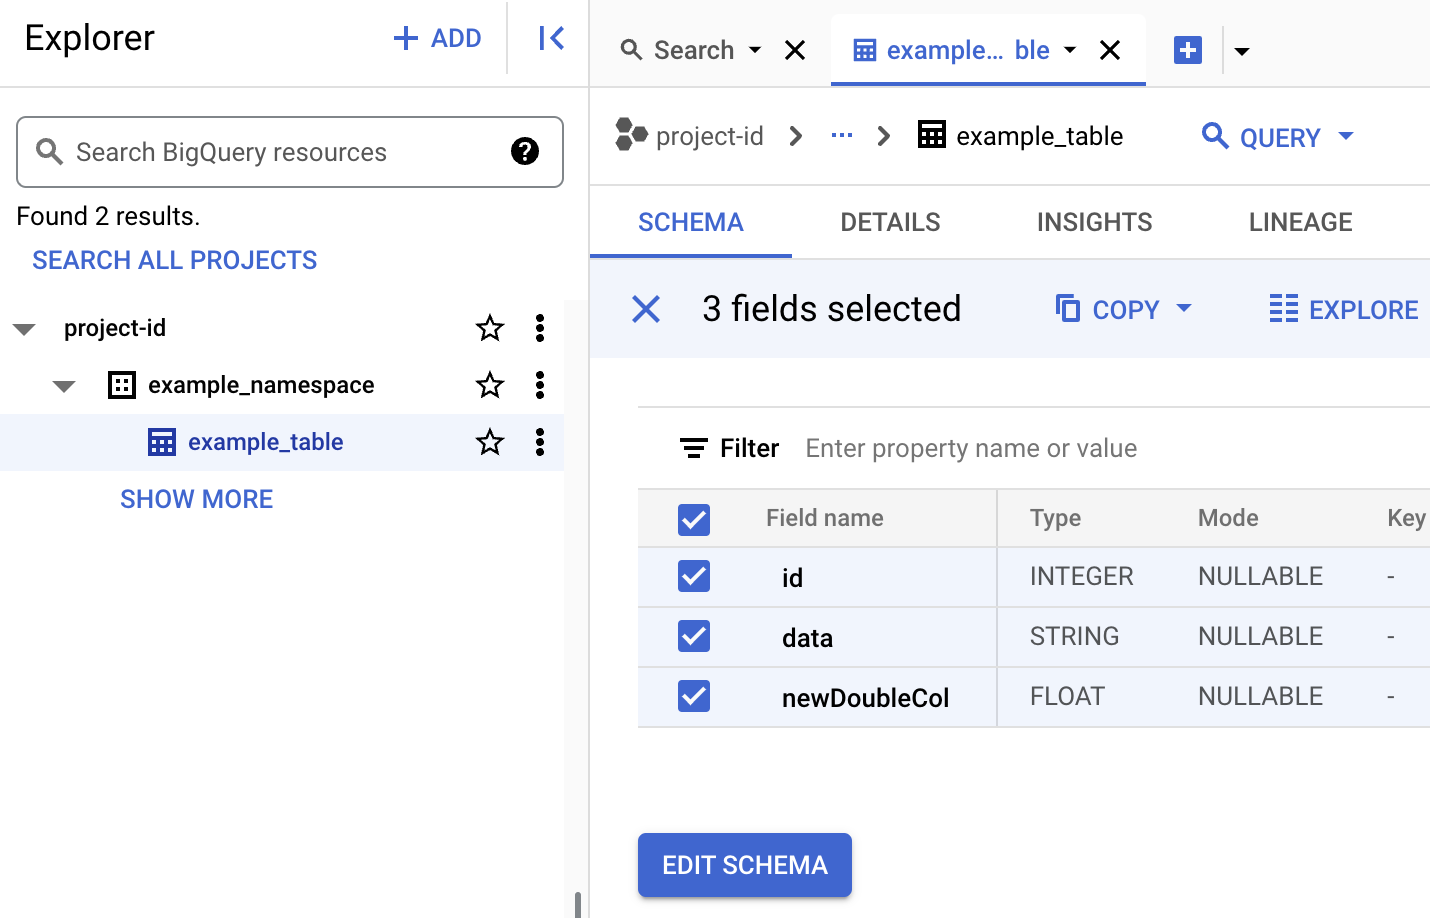
- 在 BigQuery 中查看表架构。
- 在 Google Cloud 控制台中,前往 BigQuery 页面。 进入 BigQuery Studio
- 查看 Iceberg 表元数据。