


本文档提供了一个高级架构,用于实现使用 AI 智能体的跨云分析工作流。本文档适用于希望使用智能体 AI 在多云数据湖、结构化数据仓库和非结构化数据存储区中执行分析工作流的云架构师、数据工程师和数据科学家。本文档假定您对智能体 AI 概念、数据分析和云架构有基本的了解。
本文档的部署部分提供了一个 Codelab,您可以使用它来学习如何构建智能体分析解决方案。
架构
下图展示了智能体分析解决方案的架构,该解决方案可从分布在多个数据存储区和云服务商中的结构化和非结构化数据中获取业务洞见。
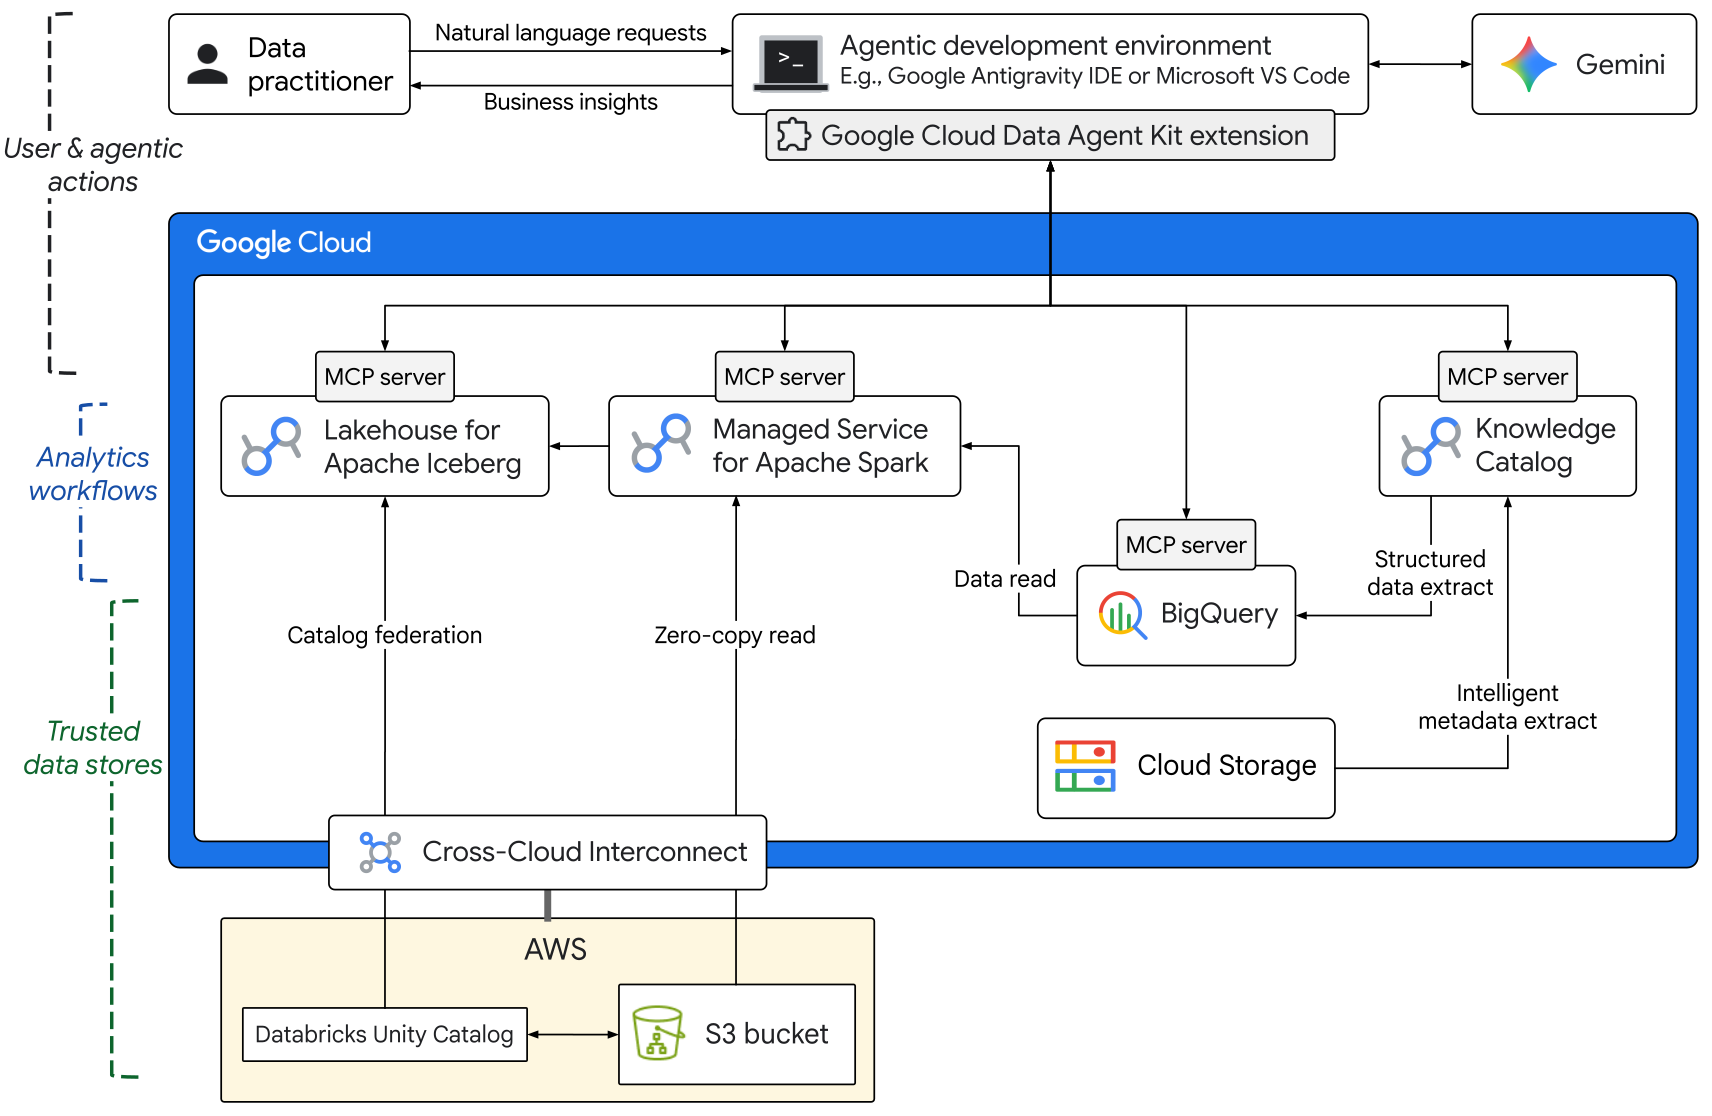
此架构中的组件分为以下几层:
用户和智能体操作
- 智能体开发环境:数据从业者(例如数据工程师和数据科学家)使用以下方法之一提交自然语言请求:
- Google Antigravity IDE 或 Microsoft Visual Studio Code 等智能体开发环境。
- CLI 智能体,例如 Antigravity CLI、Claude Code 或 Codex。
- Google Cloud Data Agent Kit:Data Agent Kit 可让智能体通过加载适当的技能并连接到远程 MCP 服务器来访问Google Cloud 中的可信数据,以使用 Google Cloud 服务。
- 基础模型:为了从可信上下文和数据中生成业务数据分析,智能体开发环境使用基础模型,例如 Gemini 系列中的模型。该模型会使用 Data Agent Kit 中的适当技能,并使用所需的 MCP 服务器工具来实现复杂的分析工作流。
- 智能体开发环境:数据从业者(例如数据工程师和数据科学家)使用以下方法之一提交自然语言请求:
分析工作流
- 无边界 Lakehouse:Lakehouse 提供高性能、统一的元数据目录,将 Apache Iceberg 开放表格式与 Google Cloud中的企业级存储集成。借助跨云数据访问,Lakehouse 可让您联合 Databricks Unity Catalog 等外部目录,而无需移动或复制数据。
- Managed Service for Apache Spark:这是架构中的核心数据处理组件。Managed Service for Apache Spark 的 Lightning Engine 功能支持以批处理和交互模式进行高性能、无服务器数据处理。Spark 数据处理作业使用 Lakehouse 中 Iceberg 目录的元数据,从 BigQuery 读取结构化数据,并从 Amazon S3 等外部来源执行零拷贝读取。
- Knowledge Catalog:智能体使用 Knowledge Catalog 对 Cloud Storage 中的非结构化数据进行智能扫描,提取语义元数据,并构建上下文图。
可信数据存储区
- Google Cloud 中的数据:BigQuery 是结构化数据的中央仓库,包括从 Cloud Storage 中的非结构化数据中提取的结构化数据。
- 来自外部来源的数据:该架构显示了外部数据源,例如 Amazon S3 存储桶中的数据和 Databricks Unity Catalog 中的元数据。Cross-Cloud Interconnect 在 Google Cloud与其他云服务商之间提供高带宽专用连接。
使用的产品
该架构使用以下 Google Cloud 产品和工具:
- Google Cloud Data Agent Kit:智能体扩展程序,可让数据科学家、数据工程师和数据应用开发者在首选智能体开发环境中管理整个数据生命周期。
- BigQuery:一种企业数据仓库,可帮助您使用机器学习、地理空间分析和商业智能等内置功能管理和分析数据。
- Managed Service for Apache Spark:一种代管式服务,可在托管式计算基础设施上运行 Apache Spark 批量工作负载。
- Lakehouse:一种高性能存储引擎,可让您构建开放数据湖仓一体架构,并为高级分析和 AI 提供统一的界面。
- Knowledge Catalog:一项 AI 赋能的服务,可提供具有智能元数据和治理功能的数据资产统一目录。
- Gemini:Google 开发的一系列多模态 AI 模型。
- Cloud Storage:适用于各种数据类型的费用低廉且不受限制的对象存储区。数据可从 Google Cloud内部和外部访问,并且跨位置进行复制以实现冗余。
- Cross-Cloud Interconnect:一种服务,可在 Google Cloud 与其他云服务商之间提供高带宽、低延迟的专用连接。
- Google Cloud MCP 服务器:由 Google 管理的远程服务,这些服务实现了 Model Context Protocol (MCP),可让 AI 应用访问 Google 和 Google Cloud 产品和服务。
使用场景
本文档介绍的架构适用于以下应用场景:
- 多云数据分析:高效查询和分析分布在 Google Cloud 和其他云服务商中的数据,而无需移动文件或构建复杂的提取、转换、加载 (ETL) 流水线。例如,全球零售商的营销经理可以通过将 Amazon S3 中的客户忠诚度数据与 BigQuery 中的营销运营数据联接,来分析营销活动的效果。
- 智能数据发现:使用自然语言提示和 AI 智能体,跨多个环境发现、查询和处理联合数据集。例如,采购专家可以根据供应链管理 (SCM) 系统中的结构化数据,结合非结构化电子邮件通信和损害评估报告中的数据洞见,确定供应链中断的常见原因。
- 从非结构化来源中提取结构化数据:扫描大量非结构化数据,派生语义元数据,并将结构化数据提取结果存储在 BigQuery 中,以供下游分析使用。例如,运营控制员可以从数千张以非结构化格式(例如 PDF 文件)存储的账单中提取结构化数据,从而高效分析支出。
安全注意事项
为了帮助应对 AI 智能体的独特安全风险,Google 建议采用一种方法,将确定性安全控制与基于推理的动态防御相结合:
- 人工监督:在业务关键型系统中纳入人机协同流程,以便人工监督者可以审核输出并批准、覆盖或暂停智能体操作。
- Agent Identity:为每个智能体分配一个与工作负载绑定的身份,以强制执行最小权限访问权限控制,并集中管理外部工具的凭据。
- Agent Gateway:通过 Model Armor 强制执行入站和出站流量治理、默认拒绝访问政策以及内嵌提示和工具检查。
- Agent Registry:验证智能体是否仅连接到已获批准的子智能体和 MCP 工具。
本部分中的指导并非详尽无遗。如需详细了解设计因素和最佳实践,以及有关构建和部署多智能体 AI 系统的建议,请参阅 Google Cloud中的多智能体 AI 系统。
如需了解特定于 AI 和机器学习工作负载的安全原则和建议,请参阅 Well-Architected Framework 中的 AI 和机器学习视角:安全性。
部署
如需了解如何使用 Data Agent Kit 构建智能体分析解决方案,请参阅 Codelab:借助 AI 智能体,数秒内将原始数据转化为预测洞察。此 Codelab 演示了如何使用 Data Agent Kit 在您首选的智能体开发环境中高效分析数据。此 Codelab 使用的所有示例数据都存储在Google Cloud中。
后续步骤
- 了解 Data Agent Kit 如何让您使用笔记本进行数据转换和分析。
- 探索 Knowledge Catalog 的应用场景。
- 详细了解使用 Lakehouse 进行跨云数据访问。
- 了解如何使用 Lightning Engine 加速 Apache Spark 工作负载。
- 了解如何将 Knowledge Catalog 用作 BigQuery 的治理和代理层。
- 如需查看更多参考架构、图表和最佳做法,请浏览云架构中心。
贡献者
作者: Kumar Dhanagopal | 跨产品解决方案开发者
其他贡献者:
- Abirami Sukumaran | 资深开发技术推广工程师
- Arti Prasad | 技术文档工程师
- Brad Miro | 高级开发技术推广工程师
- Matthew Rahmann | 高级产品经理
- Ranadip Chatterjee | 解决方案工程师
- Remigiusz Samborski | 首席开发者关系工程师