


您可以使用詞彙表,定義特定領域的專有名詞。您可以使用詞彙表新增詞彙組合,包括原文和譯文語言詞彙。詞彙組合可確保 Vertex AI Translation 服務能一致翻譯您的詞彙。
以下是可定義詞彙表項目的情況示例:
- 產品名稱:識別產品名稱,以便在翻譯中保留。例如,Google Home 必須翻譯成 Google Home。
- 語意模糊的字詞:指定語意模糊字詞和同音異義詞的意思。例如,bat 一詞可以指運動器材,也可以指動物。
- 外來語:說明從其他語言借用的字詞含義。例如,法文的 bouillabaisse 翻譯成英文時,仍是 bouillabaisse,指魚肉燉湯。
詞彙表中的字詞可以是單一字詞 (也稱為「符記」) 或簡短詞組 (通常五個字以下)。如果字詞是停用詞,Vertex AI Translation 會忽略相符的詞彙表項目。
Vertex AI Translation 提供下列詞彙表方法,可在 Google Distributed Cloud (GDC) 實體隔離方案中使用:
| 方法 | 說明 |
|---|---|
CreateGlossary |
建立詞彙表。 |
GetGlossary |
傳回儲存的詞彙表。 |
ListGlossaries |
傳回專案中的詞彙表清單。 |
DeleteGlossary |
刪除不再需要的詞彙表。 |
事前準備
建立詞彙表來定義翻譯術語之前,您必須先建立名為 translation-glossary-project 的專案。專案的自訂資源應如下例所示:
  apiVersion: resourcemanager.gdc.goog/v1
  kind: Project
  metadata:
    labels:
      atat.config.google.com/clin-number: CLIN_NUMBER
      atat.config.google.com/task-order-number: TASK_ORDER_NUMBER
    name: translation-glossary-project
    namespace: platform
如要取得使用詞彙表所需的權限,請要求 IAM 專案管理員在專案命名空間中授予您下列角色:
- AI Translation 開發人員:取得 AI Translation 開發人員 (
ai-translation-developer) 角色,即可存取 Vertex AI Translation 服務。 - 專案 bucket 管理員:取得專案 bucket 管理員 (
project-bucket-admin) 角色,即可管理儲存空間 bucket 和 bucket 內的物件,建立及上傳檔案。
如要進一步瞭解必要條件,請參閱「設定翻譯專案」。
建立詞彙表檔案
您必須建立詞彙表檔案,儲存原文語言和譯文語言字詞。本節包含兩種不同的詞彙表版面配置,可用來定義詞彙。
下表說明 Distributed Cloud 支援的詞彙檔案限制:
| 說明 | 限制 |
|---|---|
| 檔案大小上限 | 1040 萬個 (10,485,760) UTF-8 位元組 |
| 詞彙字詞長度上限 | 1,024 個 UTF-8 位元組 |
| 專案詞彙資源數上限 | 10,000 |
選擇下列其中一種詞彙表檔案版面配置:
單向詞彙表
Vertex AI Translation API 接受以定位點分隔值 (TSV) 和逗號分隔值 (CSV)。每列包含一組以定位點 (\t) 或逗號 (,) 分隔的字詞,適用於這些檔案格式。
Vertex AI Translation API 也接受 Translation Memory eXchange (TMX) 格式,這是提供翻譯原文和譯文詞組配對的標準 XML 格式。支援的輸入檔案格式為 TMX 1.4 版。
下列範例說明單向詞彙表的 TSV、CSV 和 TMX 檔案格式所需結構:
TSV 和 CSV
下圖顯示 TSV 或 CSV 檔案中的兩個資料欄。第一欄包含原文語言字詞,第二欄包含譯文語言字詞。
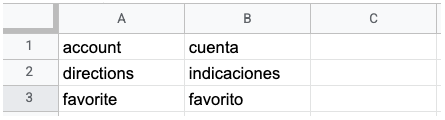
請勿在單向 TSV 或 CSV 檔案中加入標題列,第一列必須包含字詞資料。詞彙表要求會將檔案提供給 Vertex AI Translation API。
TMX
下列範例說明 TMX 檔案的必要結構:
<?xml version='1.0' encoding='utf-8'?>
<!DOCTYPE tmx SYSTEM "tmx14.dtd">
<tmx version="1.4">
  <header segtype="sentence" o-tmf="UTF-8" adminlang="en" srclang="en" datatype="PlainText"/>
  <body>
    <tu>
      <tuv xml:lang="en">
        <seg>account</seg>
      </tuv>
      <tuv xml:lang="es">
        <seg>cuenta</seg>
      </tuv>
    </tu>
    <tu>
      <tuv xml:lang="en">
        <seg>directions</seg>
      </tuv>
      <tuv xml:lang="es">
        <seg>indicaciones</seg>
      </tuv>
    </tu>
  </body>
</tmx>
如果檔案包含這個範例未顯示的 XML 標記,Vertex AI Translation API 會忽略這些標記。
請在 TMX 檔案中加入下列元素,確保 Vertex AI Translation API 能成功處理:
<header>:使用srclang屬性識別原文語言。<tu>:包含一組相同原文與譯文語言的<tuv>元素。這些<tuv>元素符合下列規定:- 每個
<tuv>元素都會使用xml:lang屬性,識別所含文字的語言。使用 ISO-639-1 代碼標示原文和譯文語言。請參閱支援語言清單和對應的語言代碼。 - 如果
<tu>元素包含兩個以上的<tuv>元素,Vertex AI Translation API 只會處理符合原文語言的第一個<tuv>元素,以及符合譯文語言的第一個<tuv>元素。服務會忽略其餘的<tuv>元素。 - 如果
<tu>元素沒有一組相符的<tuv>元素,Vertex AI Translation API 會忽略無效的<tu>元素。
- 每個
<seg>:代表一般文字字串。Vertex AI Translation API 會先移除<seg>元素兩側的標記,再處理檔案。如果<tuv>元素包含多個<seg>元素,Vertex AI Translation API 會將文字串連為單一元素,並以空格分隔文字字串。
在單向詞彙表中確立詞彙後,請將檔案上傳至儲存空間 bucket,並建立及匯入詞彙表,以便將檔案提供給 Vertex AI Translation API 使用。
對等字詞集詞彙表
Vertex AI Translation API 接受 CSV 格式的對等字詞集詞彙表檔案。如要定義對等字詞集,請建立具有多個資料欄的 CSV 檔案,其中每個資料列均列出單一詞彙的多種語言版本。請參閱支援語言清單和對應的語言代碼。
下圖是多欄 CSV 檔案範例。每一列代表一個詞彙,每一欄則代表該詞彙翻譯成不同語言的結果。
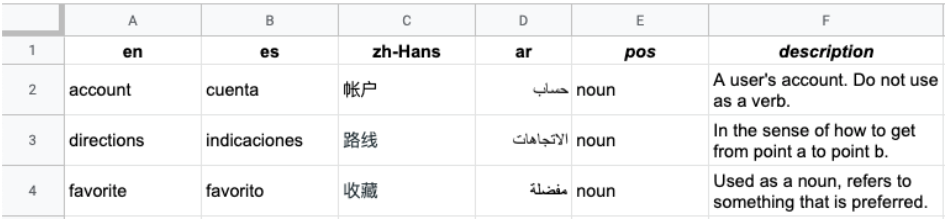
標題是檔案的第一列,用於識別各資料欄的語言。標題列使用 ISO-639-1 或 BCP-47 標準語言代碼。Vertex AI Translation API 不會使用詞性 (pos) 資訊,也不會驗證特定位置值。
後續的每個資料列會包含標題所示語言的對等詞彙。如果某個詞彙不適用於所有語言,您可以將資料欄留空。
在確立對等字詞集中的詞彙後,請將檔案上傳至儲存空間 bucket,並建立及匯入詞彙表,以便將詞彙表檔案提供給 Vertex AI Translation API 使用。
將詞彙表檔案上傳至 Storage bucket
請按照下列步驟,將詞彙表檔案上傳至 Storage bucket:
- 設定 gdcloud CLI 以使用物件儲存庫。
在專案命名空間中建立 Storage bucket。使用
Standard儲存空間級別。您可以在專案命名空間中部署
Bucket資源,建立 Storage bucket:apiVersion: object.gdc.goog/v1 kind: Bucket metadata: name: glossary-bucket namespace: translation-glossary-project spec: description: bucket for translation glossary storageClass: Standard bucketPolicy: lockingPolicy: defaultObjectRetentionDays: 90將 bucket 的
read權限,以及專案命名空間中secrets的get、list和watch權限,授予 Vertex AI Translation 服務使用的服務帳戶 (ai-translation-system-sa和g-vai-translation-sie-sa)。請按照下列步驟,使用管理 API 伺服器上的自訂資源,建立角色和角色繫結。已具備
secrets權限的使用者必須套用這些資源,否則要求會失敗,並顯示attempting to grant RBAC permissions not currently held:在專案命名空間中部署
Role資源,建立角色:apiVersion: rbac.authorization.k8s.io/v1 kind: Role metadata: name: ai-translation-glossary-reader namespace: translation-glossary-project rules: - apiGroups: - object.gdc.goog resources: - buckets verbs: - read-object - apiGroups: - "" resources: - secrets verbs: - get - list - watch在專案命名空間中部署
RoleBinding資源,建立角色繫結:apiVersion: rbac.authorization.k8s.io/v1 kind: RoleBinding metadata: name: ai-translation-glossary-reader-rolebinding namespace: translation-glossary-project roleRef: apiGroup: rbac.authorization.k8s.io kind: Role name: ai-translation-glossary-reader subjects: - kind: ServiceAccount name: ai-translation-system-sa namespace: g-vai-translation-sie - kind: ServiceAccount name: g-vai-translation-sie-sa namespace: g-vai-translation-sie
將詞彙檔案上傳至您建立的 Storage bucket。詳情請參閱「上傳及下載專案中的儲存空間物件」。
建立詞彙集
CreateGlossary 方法會建立詞彙表,並將 ID 傳回產生詞彙表的長時間執行的作業。
如要建立詞彙表,請先替換下列項目,再使用任何要求資料:
ENDPOINT:貴組織使用的 Vertex AI Translation 端點。詳情請參閱「查看服務狀態和端點」。PROJECT_ID:您的專案 ID。BUCKET_NAME:詞彙表檔案所在儲存空間 bucket 的名稱。GLOSSARY_FILENAME:儲存空間 bucket 中的詞彙表檔案名稱。
以下是建立詞彙表的 HTTP 要求語法:
POST https://ENDPOINT/v3/projects/PROJECT_ID/glossaries
根據您建立的詞彙表檔案,選擇下列其中一個選項來建立詞彙表:
單向
如要建立單向詞彙表,請指定語言組合 (language_pair),其中包含原文語言 (source_language_code) 和譯文語言 (target_language_code)。
請按照下列步驟建立單向詞彙表:
將下列要求主體儲存至名為
request.json的 JSON 檔案:{ "language_pair": { "source_language_code": "SOURCE_LANGUAGE", "target_language_code": "TARGET_LANGUAGE" }, "input_config": { "s3_source": { "input_uri": "s3://BUCKET_NAME/GLOSSARY_FILENAME" } } }更改下列內容:
提出要求。下列範例使用 REST API 方法和指令列,但您也可以使用用戶端程式庫建立單向詞彙表。
curl
curl -X POST \
-H "Authorization: Bearer TOKEN" \
-H "Content-Type: application/json; charset=utf-8" \
-d @request.json \
"https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
將 TOKEN 替換為您取得的驗證權杖。
PowerShell
$cred = TOKEN
$headers = @{ "Authorization" = "Bearer $cred" }
Invoke-WebRequest
  -Method POST
  -Headers $headers
  -ContentType: "application/json; charset=utf-8"
  -InFile request.json
  -Uri "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
  | Select-Object -Expand Content
將 TOKEN 替換為您取得的驗證權杖。
Python
在您建立的 Python 指令碼中,加入下列程式碼:
import time
import google.auth
import google.auth.transport.requests
import requests

def create_glossary(project_id="PROJECT_ID", input_uri="s3://BUCKET_NAME/GLOSSARY_FILENAME",
                    source_lang_code="SOURCE_LANGUAGE", target_lang_code="TARGET_LANGUAGE"):
    # Client 3.8.0 has no s3_source field, so call REST (token audience without :443).
    creds, _ = google.auth.default()
    creds = creds.with_gdch_audience("https://ENDPOINT")
    creds.refresh(google.auth.transport.requests.Request())
    session = requests.Session()
    session.verify = "CERT_NAME"
    session.headers["Authorization"] = f"Bearer {creds.token}"
    body = {"language_pair": {"source_language_code": source_lang_code,
                              "target_language_code": target_lang_code},
            "input_config": {"s3_source": {"input_uri": input_uri}}}
    r = session.post(f"https://ENDPOINT/v3/projects/{project_id}/glossaries", json=body)
    r.raise_for_status()
    op = r.json()
    while not op.get("done"):
        time.sleep(2)
        op = session.get(f"https://ENDPOINT/v3/{op['name']}").json()
    return op  # The service assigns the glossary ID: op["metadata"]["name"]
更改下列內容:
SOURCE_LANGUAGE:詞彙表原文語言的語言代碼。查看支援語言清單和對應的語言代碼。TARGET_LANGUAGE:詞彙表譯文語言的語言代碼。查看支援語言清單和對應的語言代碼。CERT_NAME:憑證授權單位 (CA) 憑證檔案的名稱,例如org-1-trust-bundle-ca.cert。詳情請參閱「在開發環境中產生信任套件 CA 憑證檔案」。
儲存 Python 指令碼。
執行 Python 指令碼:
python SCRIPT_NAME將
SCRIPT_NAME替換為您為 Python 指令碼指定的名稱,例如glossary.py。
如要進一步瞭解 projects.glossaries.create 方法,請參閱 Vertex AI Translation REST API 參考資料。
您應該會收到如下的 JSON 回覆:
{
"name": "projects/PROJECT_ID/operations/OPERATION_ID",
"metadata": {
    "@type": "type.googleapis.com/google.cloud.translation.v3.CreateGlossaryMetadata",
    "name": "projects/PROJECT_ID/glossaries/GLOSSARY_ID",
    "state": "RUNNING",
    "submitTime": "TIME"
  }
}
在回應中:
OPERATION_ID:伺服器指派的長時間執行的作業 ID,用於建立詞彙表。服務會在回應的name欄位中傳回這個 ID,您也可以呼叫projects.operations.list取得。您可以將projects/PROJECT_ID/operations/OPERATION_ID傳遞至projects.operations.get,檢查詞彙建立作業的狀態。GLOSSARY_ID:伺服器指派的詞彙表 ID (G後面加上數字),用於 get、translate 和 delete 要求。
對等字詞集
如要建立對等字詞集詞彙表,請指定語言集 (language_codes_set) 和詞彙表的語言代碼 (language_codes)。
請按照下列步驟建立對等字詞集詞彙表:
將下列要求主體儲存至名為
request.json的 JSON 檔案:{ "language_codes_set": { "language_codes": ["LANGUAGE_CODE_1", "LANGUAGE_CODE_2", "LANGUAGE_CODE_3" ] }, "input_config": { "s3_source": { "input_uri": "s3://BUCKET_NAME/GLOSSARY_FILENAME" } } }將
LANGUAGE_CODE_1、LANGUAGE_CODE_2和LANGUAGE_CODE_3替換為詞彙表的語言代碼。查看支援語言清單和對應的語言代碼。提出要求:
curl
curl -X POST \
    -H "Authorization: Bearer TOKEN" \
    -H "Content-Type: application/json; charset=utf-8" \
    -d @request.json \
    "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
將 TOKEN 替換為您取得的驗證權杖。
您應該會收到如下的 JSON 回覆:
{
  "name": "projects/PROJECT_ID/operations/OPERATION_ID",
  "metadata": {
    "@type": "type.googleapis.com/google.cloud.translation.v3.CreateGlossaryMetadata",
    "name": "projects/PROJECT_ID/glossaries/GLOSSARY_ID",
    "state": "RUNNING",
    "submitTime": "TIME"
  }
}
在回應中:
OPERATION_ID:伺服器指派的長時間執行的作業 ID,用於建立詞彙表。服務會在回應的name欄位中傳回這個 ID,您也可以呼叫projects.operations.list來找出這個 ID。您可以將projects/PROJECT_ID/operations/OPERATION_ID傳遞至projects.operations.get,檢查詞彙建立作業的狀態。GLOSSARY_ID:伺服器指派的詞彙表 ID (G後面加上數字),用於 get、translate 和 delete 要求。
PowerShell
$cred = TOKEN
$headers = @{ "Authorization" = "Bearer $cred" }

Invoke-WebRequest `
  -Method POST `
  -Headers $headers `
  -ContentType: "application/json; charset=utf-8" `
  -InFile request.json `
  -Uri "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
  | Select-Object -Expand Content
將 TOKEN 替換為您取得的驗證權杖。
您應該會收到如下的 JSON 回覆:
{
  "name": "projects/PROJECT_ID/operations/OPERATION_ID",
  "metadata": {
    "@type": "type.googleapis.com/google.cloud.translation.v3.CreateGlossaryMetadata",
    "name": "projects/PROJECT_ID/glossaries/GLOSSARY_ID",
    "state": "RUNNING",
    "submitTime": "TIME"
  }
}
在回應中:
OPERATION_ID:伺服器指派的長時間執行的作業 ID,用於建立詞彙表。服務會在回應的name欄位中傳回這個 ID,您也可以呼叫projects.operations.list來找出這個 ID。您可以將projects/PROJECT_ID/operations/OPERATION_ID傳遞至projects.operations.get,檢查詞彙建立作業的狀態。GLOSSARY_ID:伺服器指派的詞彙表 ID (G後面加上數字),用於 get、translate 和 delete 要求。
Python
在您建立的 Python 指令碼中,加入下列程式碼:
import time
import google.auth
import google.auth.transport.requests
import requests

def create_glossary(project_id="PROJECT_ID", input_uri="s3://BUCKET_NAME/GLOSSARY_FILENAME",
                    lang_1="LANGUAGE_CODE_1", lang_2="LANGUAGE_CODE_2"):
    # Client 3.8.0 has no s3_source field, so call REST (token audience without :443).
    creds, _ = google.auth.default()
    creds = creds.with_gdch_audience("https://ENDPOINT")
    creds.refresh(google.auth.transport.requests.Request())
    session = requests.Session()
    session.verify = "CERT_NAME"
    session.headers["Authorization"] = f"Bearer {creds.token}"
    body = {"language_codes_set": {"language_codes": [lang_1, lang_2]},
            "input_config": {"s3_source": {"input_uri": input_uri}}}
    r = session.post(f"https://ENDPOINT/v3/projects/{project_id}/glossaries", json=body)
    r.raise_for_status()
    op = r.json()
    while not op.get("done"):
        time.sleep(2)
        op = session.get(f"https://ENDPOINT/v3/{op['name']}").json()
    return op  # The service assigns the glossary ID: op["metadata"]["name"]
更改下列內容:
LANGUAGE_CODE_1和LANGUAGE_CODE_2:詞彙表中語言的語言代碼。查看支援語言清單和對應的語言代碼。CERT_NAME:憑證授權單位 (CA) 憑證檔案的名稱,例如org-1-trust-bundle-ca.cert。詳情請參閱「在開發環境中產生信任套件 CA 憑證檔案」。
儲存 Python 指令碼。
執行 Python 指令碼:
python SCRIPT_NAME將
SCRIPT_NAME替換為您為 Python 指令碼指定的名稱,例如glossary.py。
如要進一步瞭解 projects.glossaries.create 方法,請參閱 Vertex AI Translation REST API 參考資料。
視詞彙表檔案的大小而定,建立詞彙表通常不到 10 分鐘即可完成。您可以擷取這項作業的狀態,瞭解作業何時完成。
取得詞彙表
GetGlossary 方法會傳回儲存的詞彙表。如果詞彙表不存在,輸出內容會傳回 NOT_FOUND 值。如要呼叫 GetGlossary 方法,請指定專案 ID 和詞彙表 ID。CreateGlossary 和 ListGlossaries 方法都會傳回詞彙表 ID。Vertex AI Translation API 僅接受 HTTPS 要求。
舉例來說,下列要求會傳回專案中特定詞彙表的資訊:
curl
curl -X GET \
   -H "Authorization: Bearer TOKEN" \
   "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries/GLOSSARY_ID"
將 TOKEN 替換為您取得的驗證權杖。
Python
from google.cloud import translate_v3 as translate
from google.api_core.client_options import ClientOptions

def get_glossary(creds, name="projects/PROJECT_ID/glossaries/GLOSSARY_ID"):
    """Get a glossary by its full name. The service assigns the glossary ID."""
    client = translate.TranslationServiceClient(
        credentials=creds, client_options=ClientOptions(api_endpoint="ENDPOINT:443"))
    response = client.get_glossary(name=name)
    print(f"Glossary name: {response.name}")
傳遞已設定目標對象 https://ENDPOINT:443 的 Distributed Cloud 憑證 (creds),如「翻譯文字」所示。
如要進一步瞭解 get_glossary 方法,請參閱 Python 用戶端程式庫。
列出詞彙表
ListGlossaries 方法會傳回專案中的 Glossary 資源清單,每項資源都包含完整的 name (projects/PROJECT_ID/glossaries/GLOSSARY_ID)。如果專案沒有詞彙,輸出內容會傳回 {}。如果專案不存在,輸出內容會傳回 NOT_FOUND 值。如要呼叫 ListGlossaries 方法,請指定專案 ID 和 Vertex AI Translation 端點。Vertex AI Translation API 僅接受 HTTPS 要求。
舉例來說,下列要求會傳回專案中的詞彙:
curl -X GET \
    -H "Authorization: Bearer TOKEN" \
    "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries?page_size=10"
將 TOKEN 替換為您取得的驗證權杖。
刪除詞彙表
DeleteGlossary 方法會刪除詞彙表。如果詞彙表不存在,輸出內容會傳回 NOT_FOUND 值。如要呼叫 DeleteGlossary 方法,請指定專案 ID、詞彙表 ID 和 Vertex AI Translation 端點。CreateGlossary 和 ListGlossaries 方法都會傳回詞彙表 ID。Vertex AI Translation API 僅接受 HTTPS 要求。
舉例來說,下列要求會從專案中刪除詞彙表:
curl -X DELETE \
    -H "Authorization: Bearer TOKEN" \
    "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries/GLOSSARY_ID"
將 TOKEN 替換為您取得的驗證權杖。