


光學字元辨識 (OCR) 是 Google Distributed Cloud (GDC) 實體隔離方案中的預先訓練 Vertex AI API,可從支援的檔案類型 (包括圖片、文件和手寫筆記) 偵測及擷取文字。您可以處理文字擷取的內嵌要求,或對儲存在 bucket 中的檔案執行非同步批次工作,支援多種語言。
光學字元辨識方法
OCR 提供下列 Distributed Cloud 方法來辨識文字:
| 方法 | 說明 |
|---|---|
BatchAnnotateImages |
偵測內嵌要求中提供的一批 JPEG 或 PNG 圖片中的文字。 |
BatchAnnotateFiles |
偵測內嵌要求中提供的一批 PDF 或 TIFF 檔案中的文字。 |
AsyncBatchAnnotateFiles |
偵測儲存空間 bucket 中一批 PDF 或 TIFF 檔案的文字,以便處理離線要求。 |
光學字元辨識功能
OCR API 可偵測及擷取圖片中的文字。下列兩項註解功能支援光學字元辨識:
TEXT_DETECTION可偵測及擷取任何圖片中的文字。例如,相片可能包含街道或交通標誌。OCR 服務會傳回 JSON 檔案,其中包含擷取的字串、個別字詞和定界框。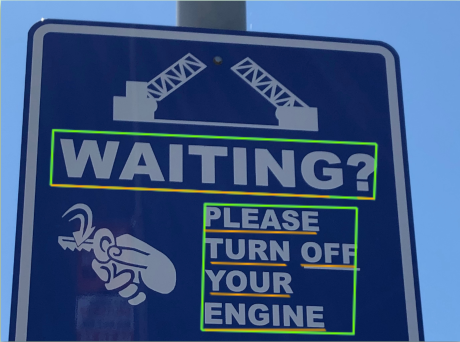
圖 1.路標相片,OCR API 會偵測其中的文字和定界框。
DOCUMENT_TEXT_DETECTION也會從圖片中擷取文字,但這項服務會針對密集文字和文件最佳化回應。舉例來說,打字文字的掃描圖片可能包含多個段落和標題。OCR 服務會傳回 JSON 檔案,內含頁面、區塊、段落、字詞和分行資訊。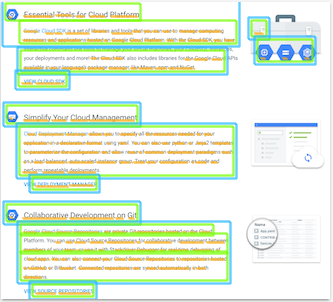
圖 2:OCR API 偵測到字詞、頁面和段落等資訊的打字文字掃描圖片。
手寫文字
圖 3 是手寫文字的圖片。OCR API 會偵測並擷取這些圖片中的文字。如需支援手寫辨識的手寫文字清單,請參閱「手寫文字」。
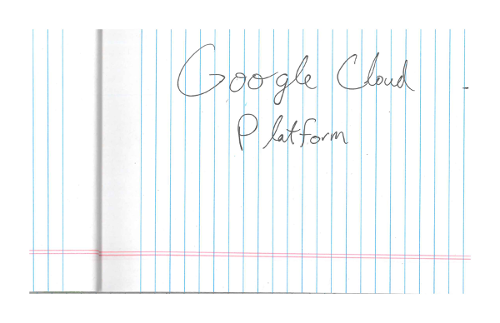
圖 3:OCR API 偵測到文字的手寫圖片。
光學字元辨識限制
BatchAnnotateImages 和 BatchAnnotateFiles API 方法僅支援每次批次呼叫單一要求。
下表列出 Distributed Cloud 中 OCR 服務目前的限制。
| OCR 檔案限制 | 值 |
|---|---|
| 頁數上限 | 五 |
| 檔案大小上限 | 20 MB |
| 圖片大小上限 | 2,000 萬像素 (長 x 寬) |
如果提交給 OCR API 的檔案超過頁數上限或檔案大小上限,系統會傳回錯誤。如果提交的檔案超過圖片大小上限,系統會將圖片縮小至 2,000 萬像素。
OCR 支援的檔案類型
OCR 預先訓練 API 可偵測及轉錄下列檔案類型的文字:
- TIFF
- JPG
- PNG
您必須將檔案儲存在 Distributed Cloud 環境本機。您無法存取託管於 Cloud Storage 的檔案或公開檔案,進行文字偵測。